Trang 20 / 43
Chương 20
RAG Là Gì? Giải Thích Dễ Hiểu Cho Người Mới Bắt Đầu Dùng AI
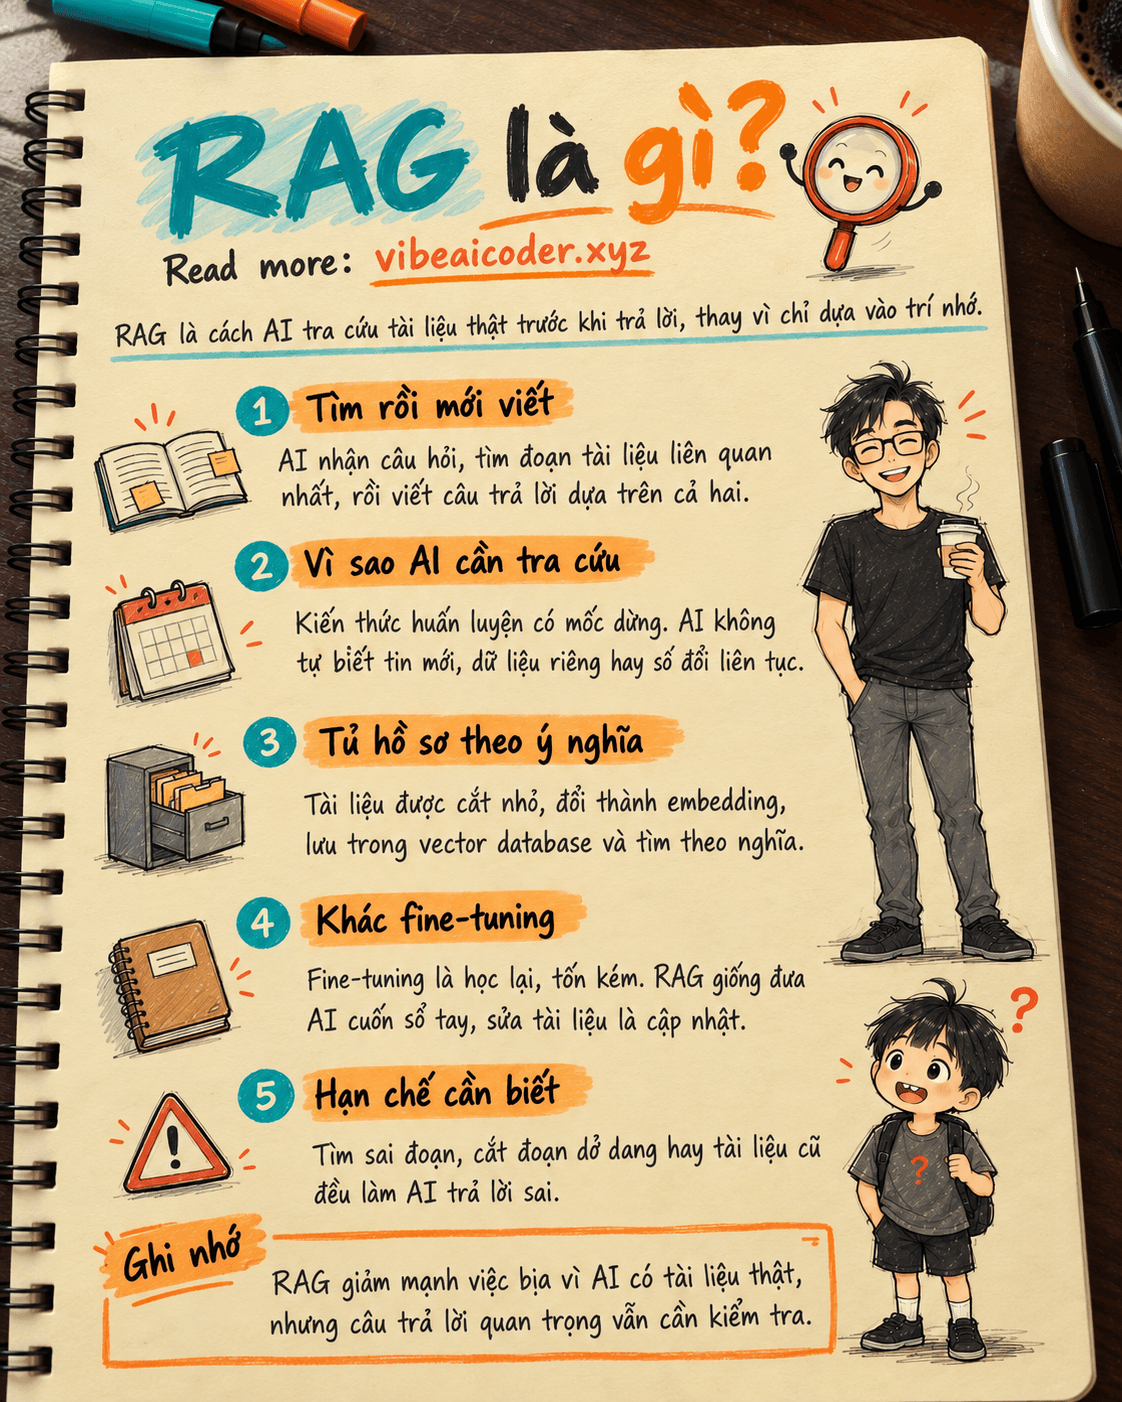
RAG (viết tắt của Retrieval Augmented Generation) là cách AI tra cứu tài liệu thật trước khi trả lời, thay vì chỉ dựa vào trí nhớ đã học sẵn. Nhờ vậy câu trả lời chính xác hơn, cập nhật hơn, và nhiều khi còn kèm nguồn trích dẫn để bạn kiểm tra lại. Nếu bạn từng thấy một AI trả lời đúng cả những thông tin rất mới hoặc rất riêng tư (như tài liệu nội bộ công ty bạn), gần như chắc chắn phía sau nó đang chạy RAG. Nếu bạn muốn ôn lại khái niệm nền tảng trước khi vào sâu RAG, bài AI là gì giải thích rất dễ hiểu cho người mới.
RAG là gì, nói đơn giản nhất
Hãy tưởng tượng bạn hỏi một người bạn thông minh nhưng đã lâu không đọc tin tức. Bạn hỏi nhanh thì người đó trả lời theo trí nhớ, có thể đúng có thể sai vì thông tin cũ. Nhưng nếu bạn đưa cho người đó vài trang tài liệu mới nhất rồi mới hỏi, câu trả lời sẽ chính xác hơn hẳn vì họ vừa "đọc lại" trước khi nói.
RAG làm đúng việc đó cho AI. Thay vì để AI trả lời hoàn toàn bằng kiến thức đã học trong quá trình huấn luyện (có thể cũ vài tháng đến vài năm), hệ thống sẽ:
- Nhận câu hỏi của bạn.
- Đi tìm (retrieve) những đoạn tài liệu liên quan nhất trong một kho dữ liệu, ví dụ tài liệu công ty, bài báo, trang web.
- Đưa những đoạn đó kèm câu hỏi cho AI, rồi để AI sinh câu trả lời (generation) dựa trên cả hai.
Ghép hai bước "tìm" và "sinh" lại, bạn có Retrieval Augmented Generation, tức sinh câu trả lời được tăng cường bằng việc tra cứu.
Vì sao AI cần tra cứu, nó không học hết mọi thứ rồi sao
Một mô hình AI như Claude hay ChatGPT (xem thêm Claude AI là gì) được huấn luyện trên một lượng dữ liệu khổng lồ, nhưng dữ liệu đó luôn có một mốc thời gian dừng lại. Sau mốc đó, có ba thứ AI không thể tự biết:
- Tin tức và sự kiện mới: ra mắt sản phẩm, thay đổi chính sách, giá cả mới.
- Dữ liệu riêng tư: hợp đồng công ty bạn, email nội bộ, tài liệu dự án, những thứ chưa bao giờ xuất hiện trên Internet để AI học.
- Thông tin thay đổi liên tục: tồn kho sản phẩm, lịch bay, số dư tài khoản.
Nếu không có RAG, AI buộc phải đoán hoặc dùng kiến thức cũ, dẫn tới hiện tượng "bịa thông tin nghe rất tự tin" mà dân kỹ thuật gọi là hallucination (ảo giác, tức AI tạo ra câu trả lời nghe hợp lý nhưng sai sự thật). RAG giảm mạnh tình trạng này vì AI được "nhắc bài" bằng tài liệu thật ngay trước khi trả lời, thay vì chỉ dựa vào trí nhớ.
RAG hoạt động thế nào, hình dung qua ba bước
Để dễ hình dung hơn, hãy xem RAG qua một ví dụ cụ thể: bạn hỏi chatbot nội bộ của công ty "Chính sách nghỉ phép năm nay thay đổi gì?"
Bước 1, biến tài liệu thành dạng AI tìm được. Trước đó, toàn bộ tài liệu công ty (quy định, email, file PDF) được cắt thành từng đoạn nhỏ rồi chuyển thành dãy số gọi là embedding (cách AI biến chữ thành các con số để so sánh độ giống nhau về nghĩa). Những dãy số này được lưu trong một kho gọi là vector database, đơn giản là một cái "tủ hồ sơ" được sắp xếp theo ý nghĩa thay vì theo bảng chữ cái.
Bước 2, tìm đúng đoạn liên quan. Khi bạn hỏi, câu hỏi cũng được biến thành dãy số tương tự, rồi hệ thống so sánh để tìm ra vài đoạn tài liệu có ý nghĩa gần với câu hỏi nhất, ví dụ đúng đoạn nói về "chính sách nghỉ phép 2026".
Bước 3, AI đọc và trả lời. Những đoạn tài liệu tìm được sẽ được gửi kèm câu hỏi của bạn cho AI. AI đọc cả hai rồi viết câu trả lời dựa trên tài liệu thật, thường kèm luôn câu trích dẫn như "theo mục 4.2 của quy định nghỉ phép".
Toàn bộ quá trình này diễn ra trong vài giây, bạn chỉ thấy một câu trả lời mượt mà, không biết phía sau có cả một bước "tra cứu thư viện" vừa xảy ra.
RAG khác gì việc huấn luyện lại AI
Nhiều người nhầm RAG với việc "dạy lại" AI bằng dữ liệu mới, gọi là fine-tuning. Hai cách này giải quyết vấn đề khác nhau:
- Fine-tuning giống như cho AI đi học lại một khóa học mới, tốn thời gian, tốn chi phí tính toán, và một khi học xong thì kiến thức đó "cứng" trong mô hình, muốn cập nhật lại phải học lại từ đầu.
- RAG giống như đưa AI một cuốn sổ tay để tra cứu ngay lúc trả lời, không cần huấn luyện lại gì cả. Muốn cập nhật thông tin, bạn chỉ cần thêm hoặc sửa tài liệu trong kho dữ liệu, AI sẽ tự tìm thấy bản mới nhất ở lần hỏi tiếp theo.
Vì rẻ hơn, nhanh hơn và dễ cập nhật hơn rất nhiều, RAG là lựa chọn phổ biến nhất hiện nay khi doanh nghiệp muốn AI trả lời dựa trên dữ liệu riêng của mình, thay vì phải huấn luyện một mô hình AI riêng từ đầu.
RAG giúp ích gì trong đời sống và công việc hàng ngày
Một vài ví dụ bạn có thể đã dùng mà không để ý:
- Chatbot chăm sóc khách hàng trả lời đúng chính sách đổi trả, giá sản phẩm mới nhất của một cửa hàng, thay vì trả lời chung chung.
- Trợ lý đọc tài liệu PDF: bạn tải lên một hợp đồng dài 50 trang, hỏi "điều khoản phạt vi phạm nằm ở đâu", AI tìm đúng đoạn rồi tóm tắt cho bạn.
- Công cụ tìm kiếm có AI như các bản tóm tắt kết quả tìm kiếm, nơi AI đọc vài trang web mới nhất rồi tổng hợp câu trả lời kèm link nguồn.
- AI agent làm việc nhóm hoặc nghiên cứu (xem thêm AI agent là gì) thường dùng RAG để tra cứu tài liệu dự án trước khi lên kế hoạch hành động.
Khi nào không cần dùng RAG
RAG không phải lúc nào cũng là lựa chọn tốt nhất. Andrej Karpathy, cựu giám đốc AI tại Tesla, từng chia sẻ cách ông xây dựng kho tri thức cá nhân bằng LLM mà không cần RAG: khi kho tài liệu đủ nhỏ để nhét vừa luôn vào cửa sổ ngữ cảnh (context window, tức lượng chữ AI có thể đọc trong một lần hỏi) của AI, bạn có thể bỏ qua bước tìm kiếm và đưa thẳng toàn bộ tài liệu cho AI đọc. Cách này đơn giản hơn RAG nhiều, miễn là dữ liệu không quá lớn.
Nói cách khác, RAG thật sự cần thiết khi kho dữ liệu quá lớn để nhét vừa một lần hỏi, ví dụ hàng nghìn trang tài liệu, hàng chục nghìn email.
Những hạn chế bạn nên biết
RAG không phải phép màu. Vài vấn đề thường gặp:
- Tìm sai đoạn tài liệu: nếu bước tìm kiếm chọn nhầm đoạn không liên quan, AI sẽ trả lời dựa trên thông tin sai, dù giọng điệu vẫn rất tự tin.
- Cắt đoạn (chunk) không hợp lý: nếu tài liệu bị cắt giữa chừng một ý quan trọng, AI có thể chỉ đọc được nửa câu chuyện.
- Tài liệu gốc đã lỗi thời: RAG chỉ tốt bằng chính kho dữ liệu nó tra cứu, nếu tài liệu chưa cập nhật thì câu trả lời cũng sai theo.
Vì vậy khi dùng một sản phẩm quảng cáo "AI trả lời dựa trên tài liệu của bạn", bạn vẫn nên kiểm tra lại những câu trả lời quan trọng thay vì tin tuyệt đối.
Muốn tìm hiểu sâu hơn thì bắt đầu từ đâu
Bạn không cần biết lập trình để hiểu RAG, nhưng nếu muốn tự tay thử, bước dễ nhất là tải tài liệu lên một trợ lý AI như Claude hoặc ChatGPT rồi đặt câu hỏi, đó chính là một dạng RAG đơn giản ở quy mô nhỏ. Nếu bạn làm trong lĩnh vực kỹ thuật và muốn xây dựng hệ thống RAG thật sự cho công ty, hãy tìm hiểu thêm về cách viết câu hỏi rõ ràng qua bài Prompt là gì, vì chất lượng câu hỏi ảnh hưởng trực tiếp tới việc hệ thống tìm đúng tài liệu hay không.
 Câu hỏi thường gặp
RAG có phải là một loại AI riêng không? Không. RAG là một kỹ thuật kết hợp với một mô hình AI có sẵn (như Claude, GPT), không phải một AI độc lập. Bạn có thể coi nó như một "trợ thủ" giúp AI tra cứu trước khi trả lời.
RAG có tốn nhiều chi phí hơn hỏi AI bình thường không? Có tốn thêm một chút, vì cần thêm bước tìm kiếm tài liệu và gửi nhiều chữ hơn cho AI đọc. Nhưng chi phí này thường rẻ hơn rất nhiều so với huấn luyện lại (fine-tune) một mô hình AI.
Người dùng bình thường có cần hiểu RAG không? Không bắt buộc, nhưng hiểu khái niệm giúp bạn biết vì sao có AI trả lời rất chính xác về tài liệu riêng của bạn, trong khi AI khác thì không, từ đó chọn đúng công cụ cho nhu cầu của mình.
RAG có giúp AI hết hoàn toàn tình trạng trả lời sai không? Không hết hoàn toàn. RAG giảm mạnh tình trạng bịa thông tin vì có tài liệu thật để dựa vào, nhưng nếu bước tìm kiếm chọn sai tài liệu, AI vẫn có thể trả lời sai.
Làm sao phân biệt một sản phẩm AI có dùng RAG hay không? Dấu hiệu dễ nhận ra nhất là AI trích dẫn nguồn cụ thể (trang tài liệu, đường link, mục quy định) ngay trong câu trả lời, thay vì chỉ trả lời chung chung không rõ dựa vào đâu.