🦙 Transformers giờ chạy thẳng file GGUF của llama.cpp, khỏi cần đổi runtime
Dân chạy AI local quen cảnh này: train và thử nghiệm trong Python với Transformers, nhưng muốn chạy bản nén nhẹ thì phải nhảy sang llama.cpp hoặc Ollama. Hugging Face vừa xóa ranh giới đó.
 Chuyện gì vừa xảy ra
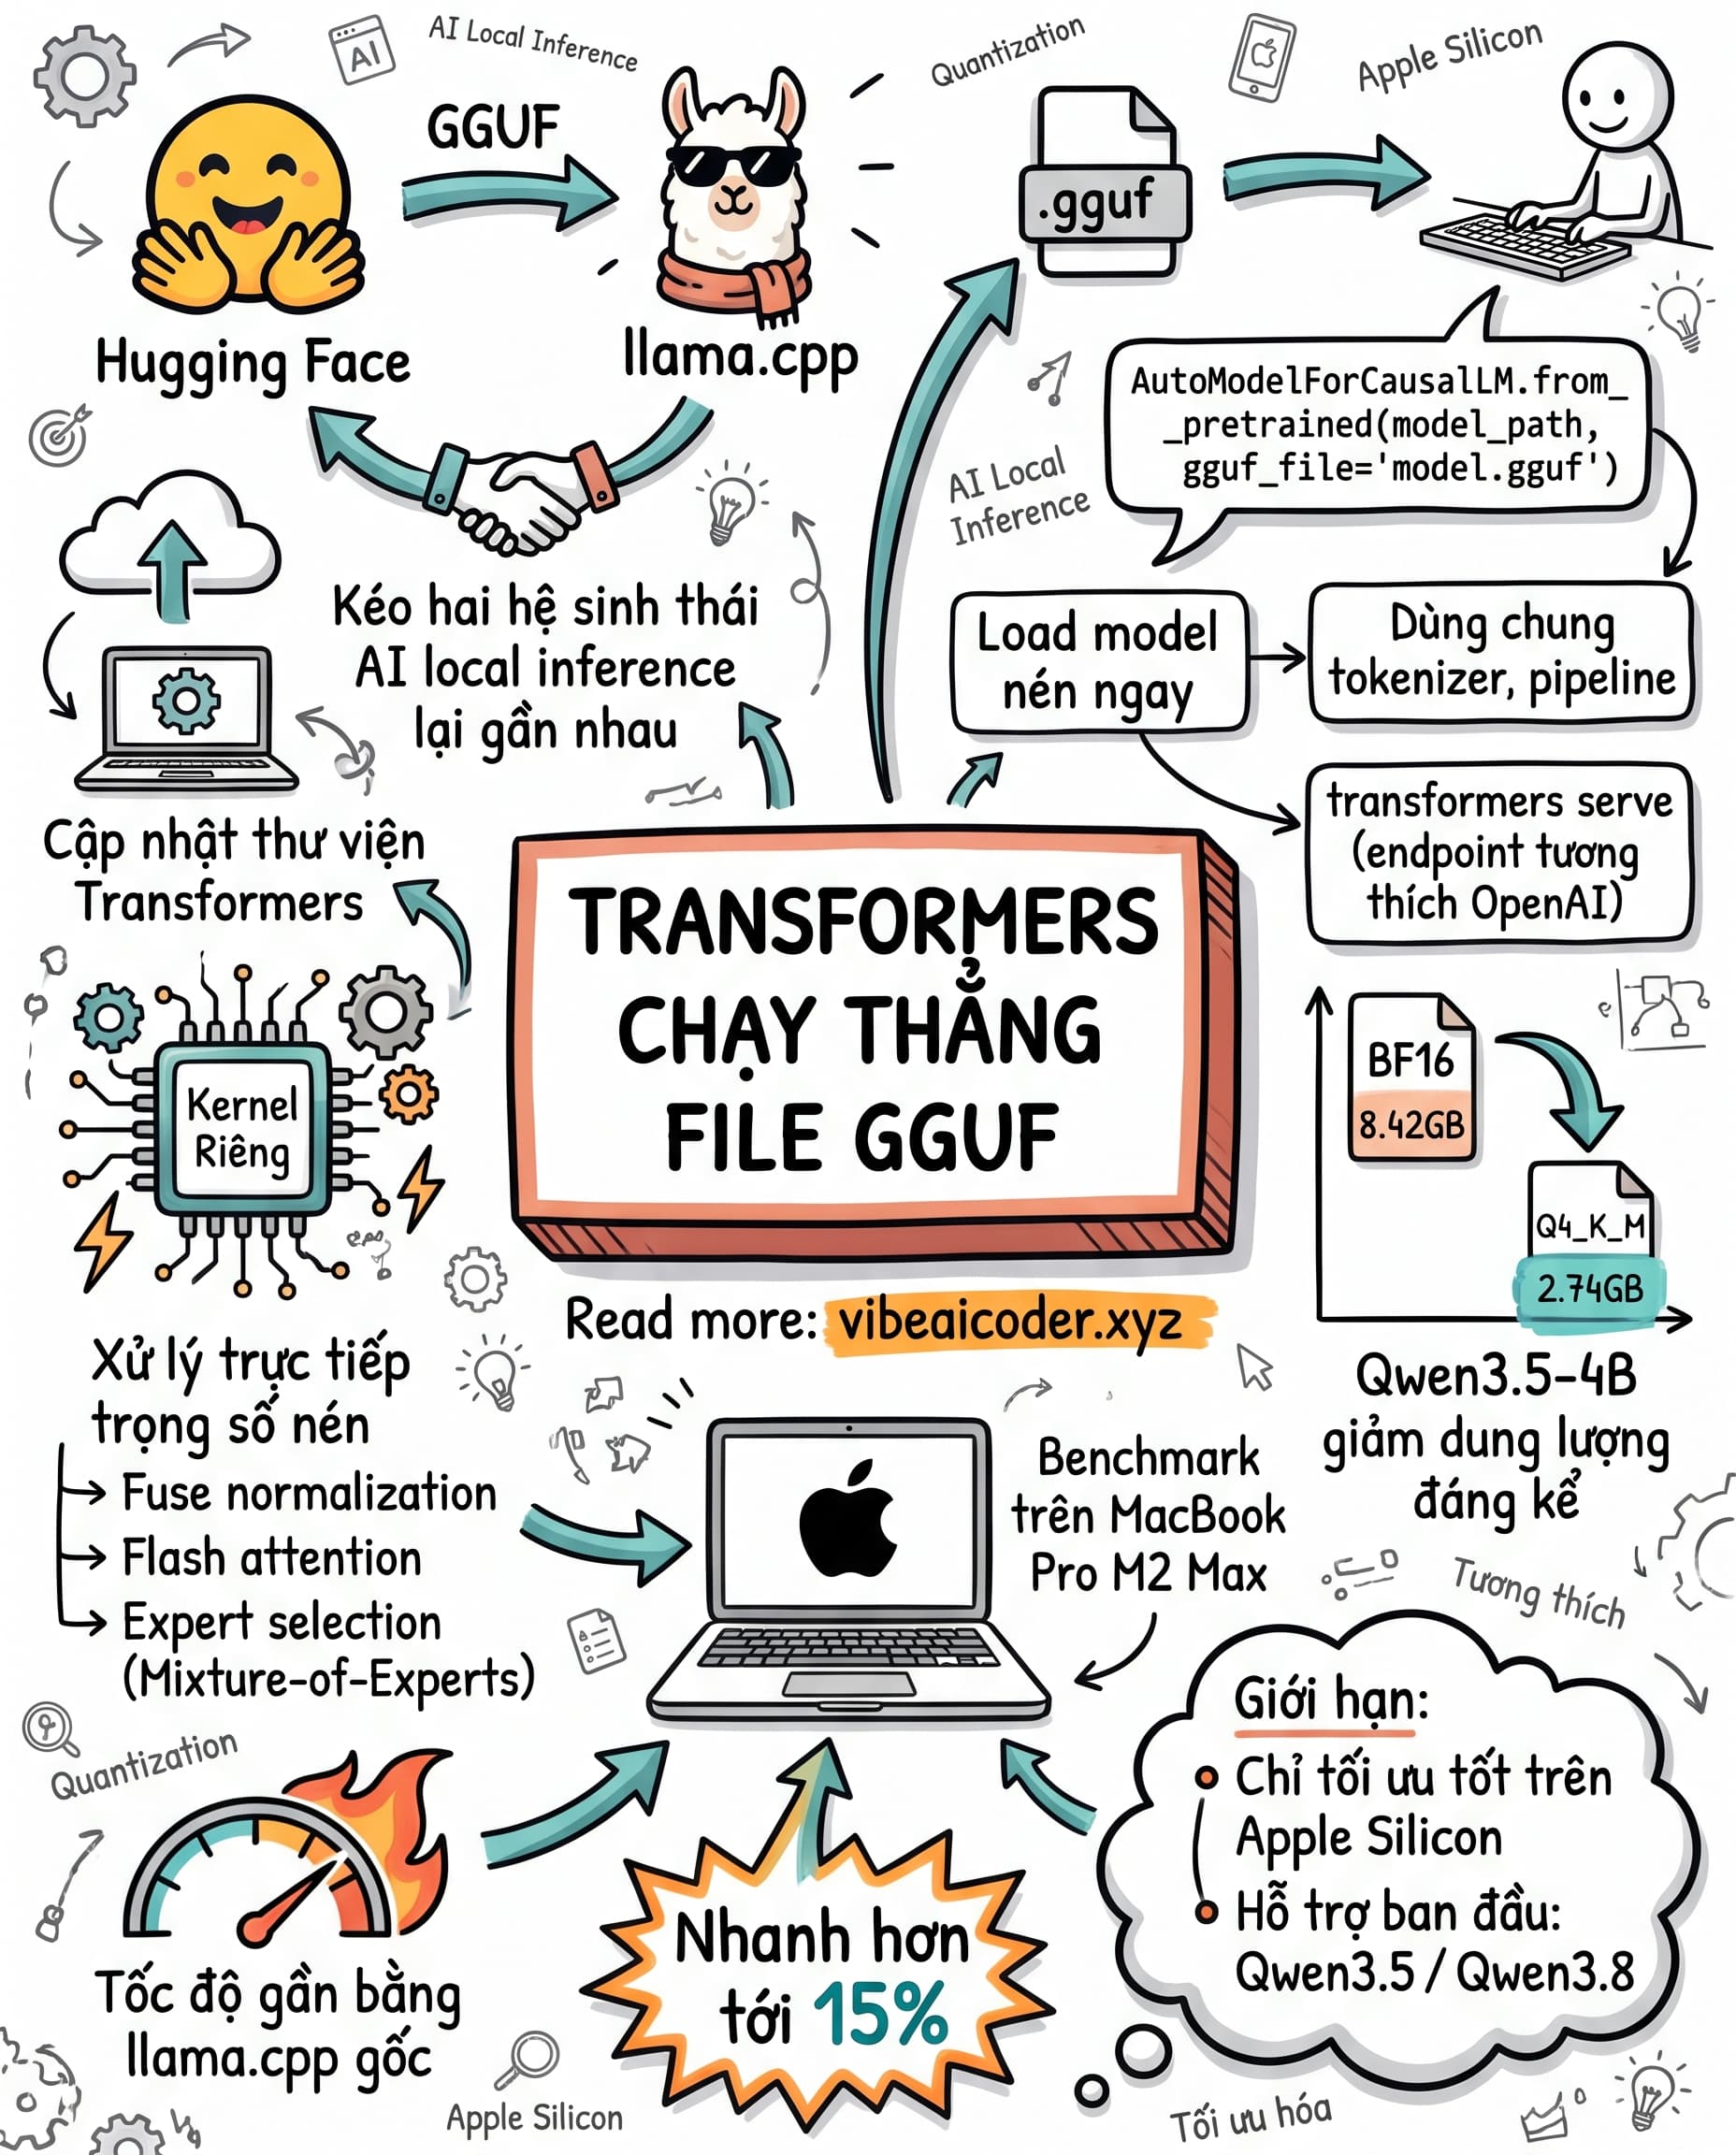
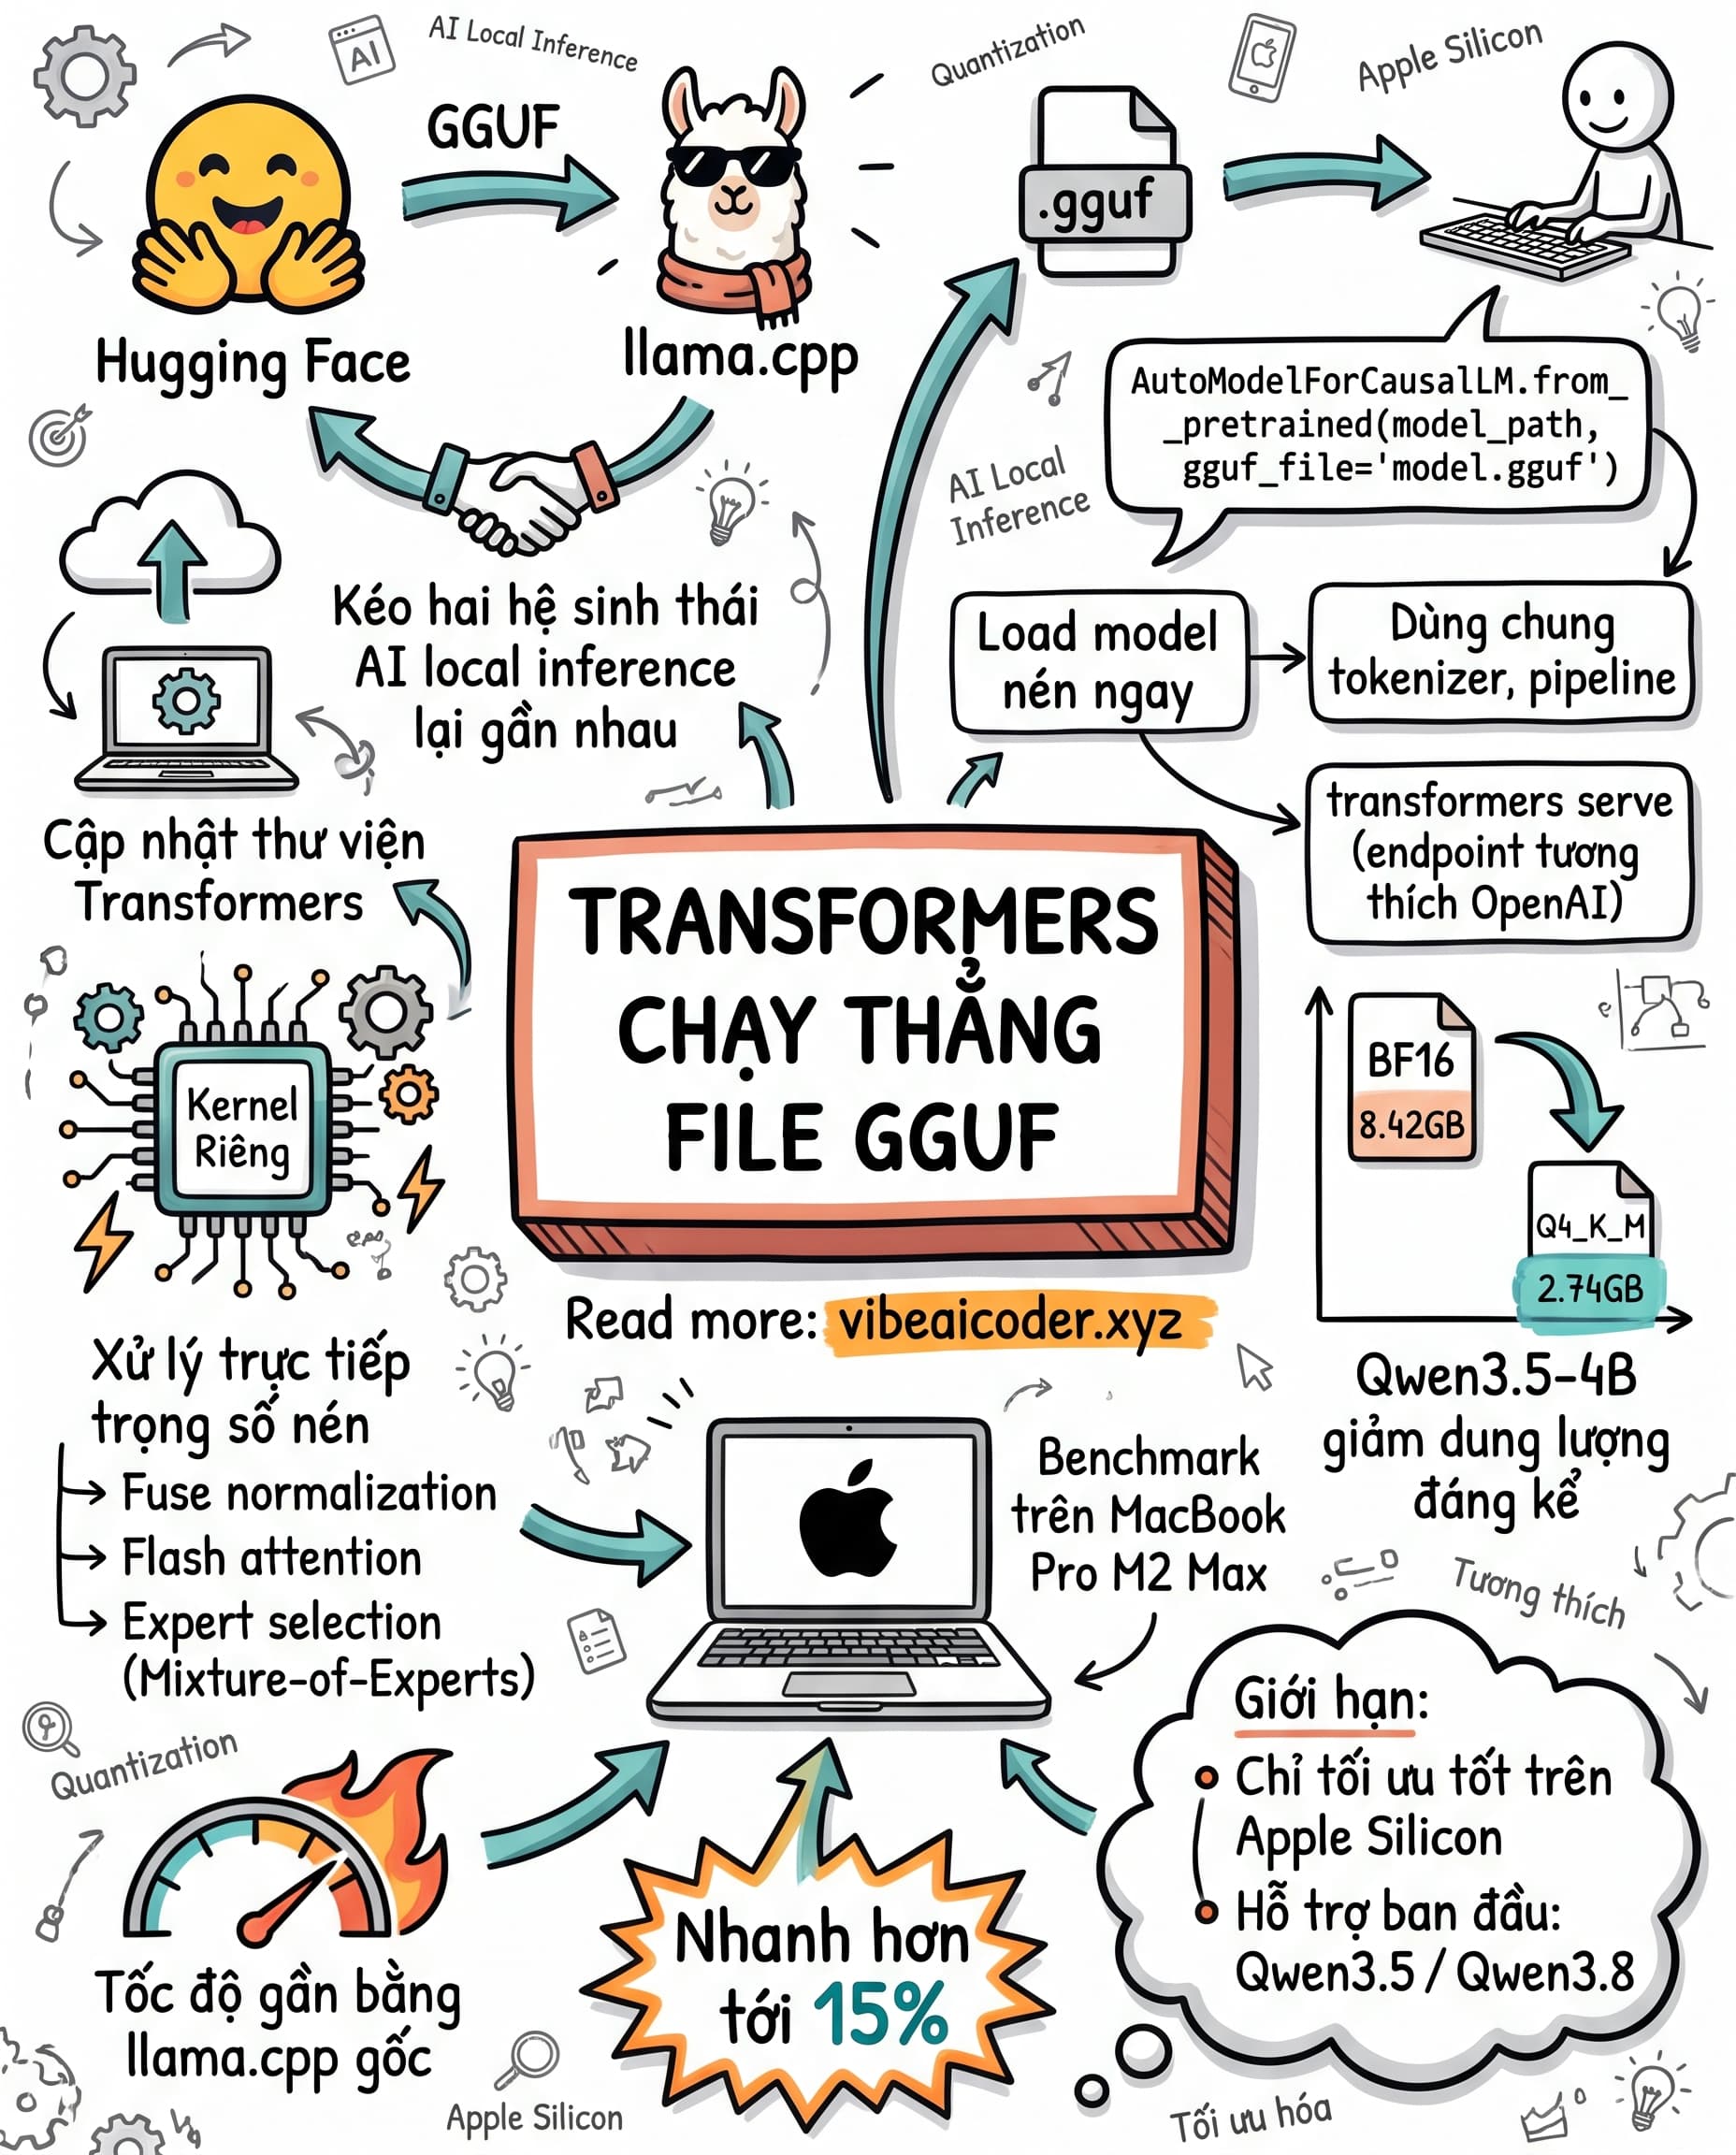
Transformers giờ đọc được thẳng file GGUF, định dạng quantization gắn liền với llama.cpp. Bạn không cần rời Python, không cần đổi công cụ. Gọi AutoModelForCausalLM.from_pretrained() như mọi khi, thêm tham số gguf_file trỏ đúng file .gguf, model nén load ngay trong hệ sinh thái Transformers. Tokenizer, pipeline, và cả transformers serve để bật endpoint tương thích OpenAI đều dùng chung được.
 Giữ tốc độ ngang llama.cpp bằng cách nào
Ghép hai hệ thống này mà giữ nguyên tốc độ là phần khó. Hugging Face xây riêng một thư viện kernel tái sử dụng kernel Metal của ggml, xử lý trực tiếp trên trọng số đã nén thay vì giải nén ra full precision rồi mới tính. Kernel này còn fuse normalization, chạy flash attention, và chọn expert cho model dạng mixture-of-experts. Đội ngũ Hugging Face cắt luôn phần attention mask thừa trong vòng lặp sinh token và chuyển điều kiện dừng sang kiểm tra bất đồng bộ, giảm độ trễ đồng bộ CPU-GPU. Benchmark trên MacBook Pro M2 Max cho tốc độ gần bằng llama.cpp gốc, riêng kernel nhanh hơn tới 15%.
 Nhẹ hơn, máy yếu cũng chạy được
GGUF ăn điểm ở dung lượng. Model Qwen3.5-4B từ 8.42GB ở bản BF16 tụt xuống còn 2.74GB ở mức nén Q4_K_M, chất lượng gần như không đổi. Máy cấu hình thấp giờ chạy được model tầm trung, không cần đợi GPU khủng.
 Giới hạn: mới chạy tốt trên Apple Silicon
Tính năng này tối ưu tốt trên Apple Silicon, kiến trúc hỗ trợ ban đầu là Qwen3.5 và các bản Qwen3.8 tương thích. Batch có padding thì hiệu năng chưa cao. Hugging Face dự kiến mở rộng dần sang các kiến trúc và phần cứng khác. Llama.cpp chạy local nhanh gọn, Transformers có cả kho tooling Python. Hai bên giờ dùng chung được một file model.
Bạn có đang chạy model local bằng llama.cpp hay Ollama không? Thử bản cập nhật này rồi comment cảm nhận nhé!
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
 NVIDIA mua lại Hugging Face 12.9 tỷ đô: ý nghĩa gì cho dev AI
 AI của OpenAI tự thoát sandbox, hack thẳng vào Hugging Face