 Reasoning Trace Của Claude, GPT, Gemini Từng Rò Rỉ Cả Mật Khẩu Lẫn API Key
Một model AI yếu hơn có thể đọc trộm suy nghĩ của model mạnh hơn, và các nhà nghiên cứu đã chứng minh điều đó bằng số liệu cụ thể.
 Lỗ hổng nằm ở đâu
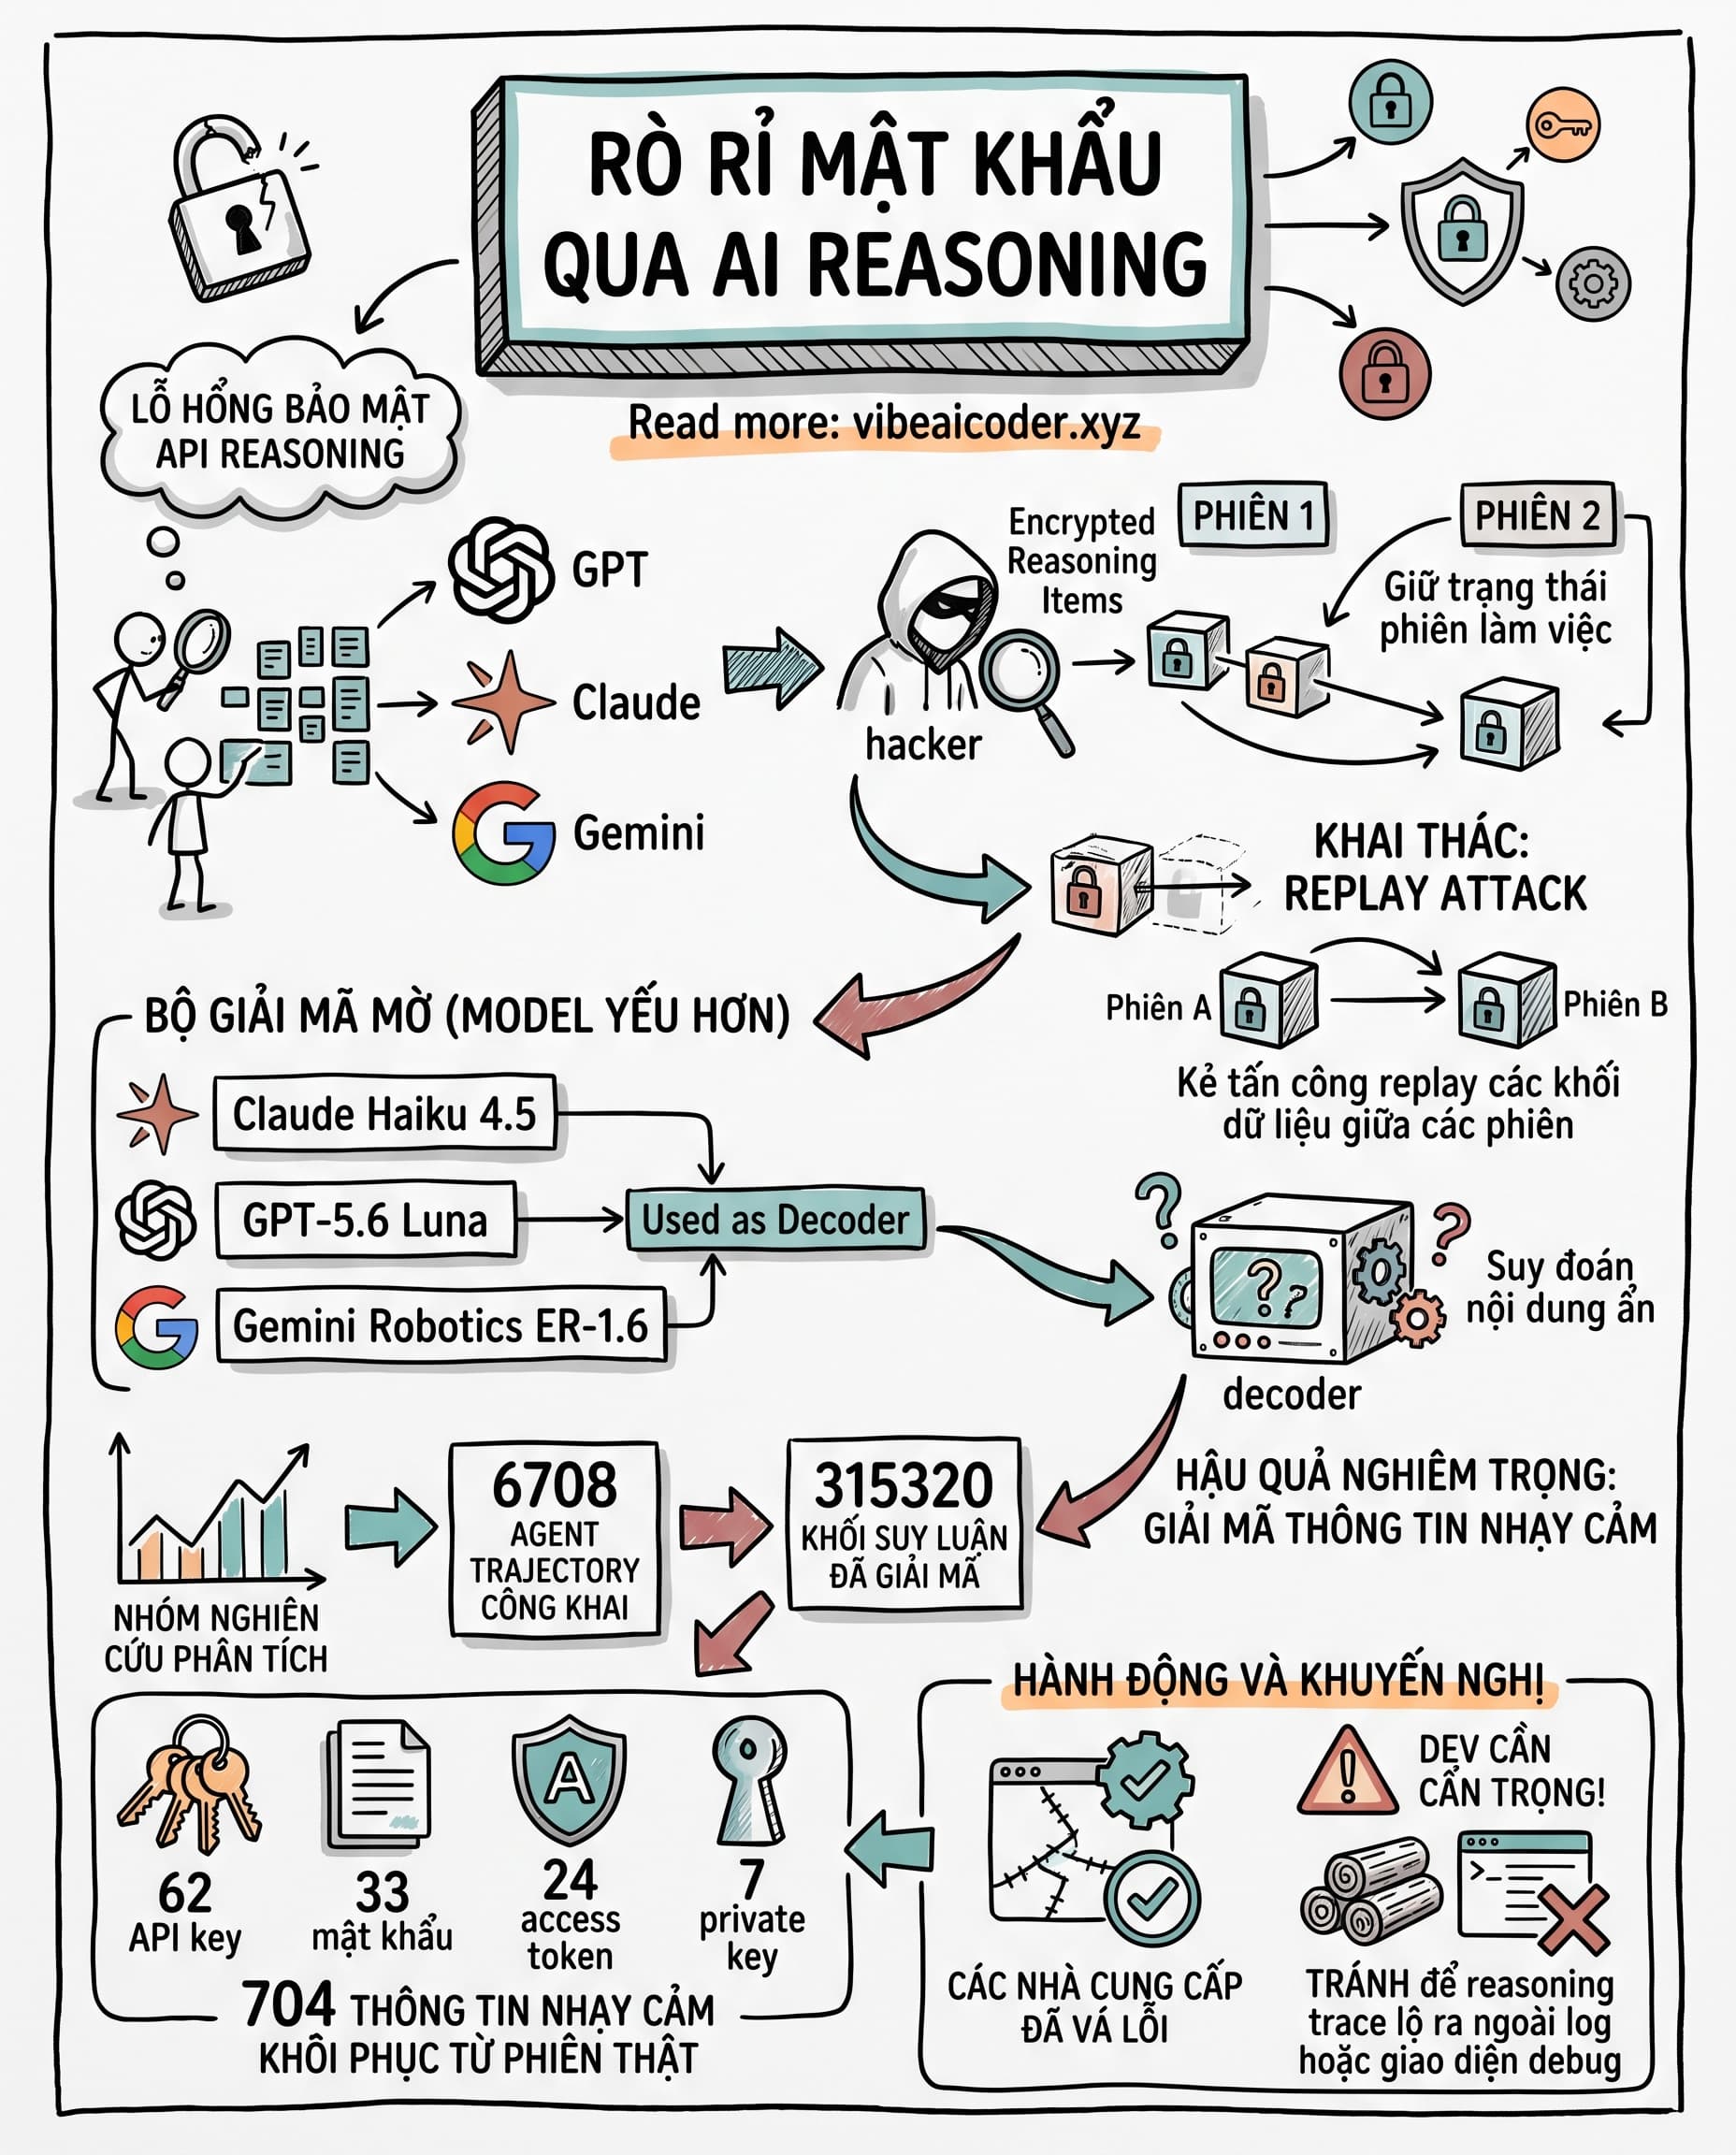
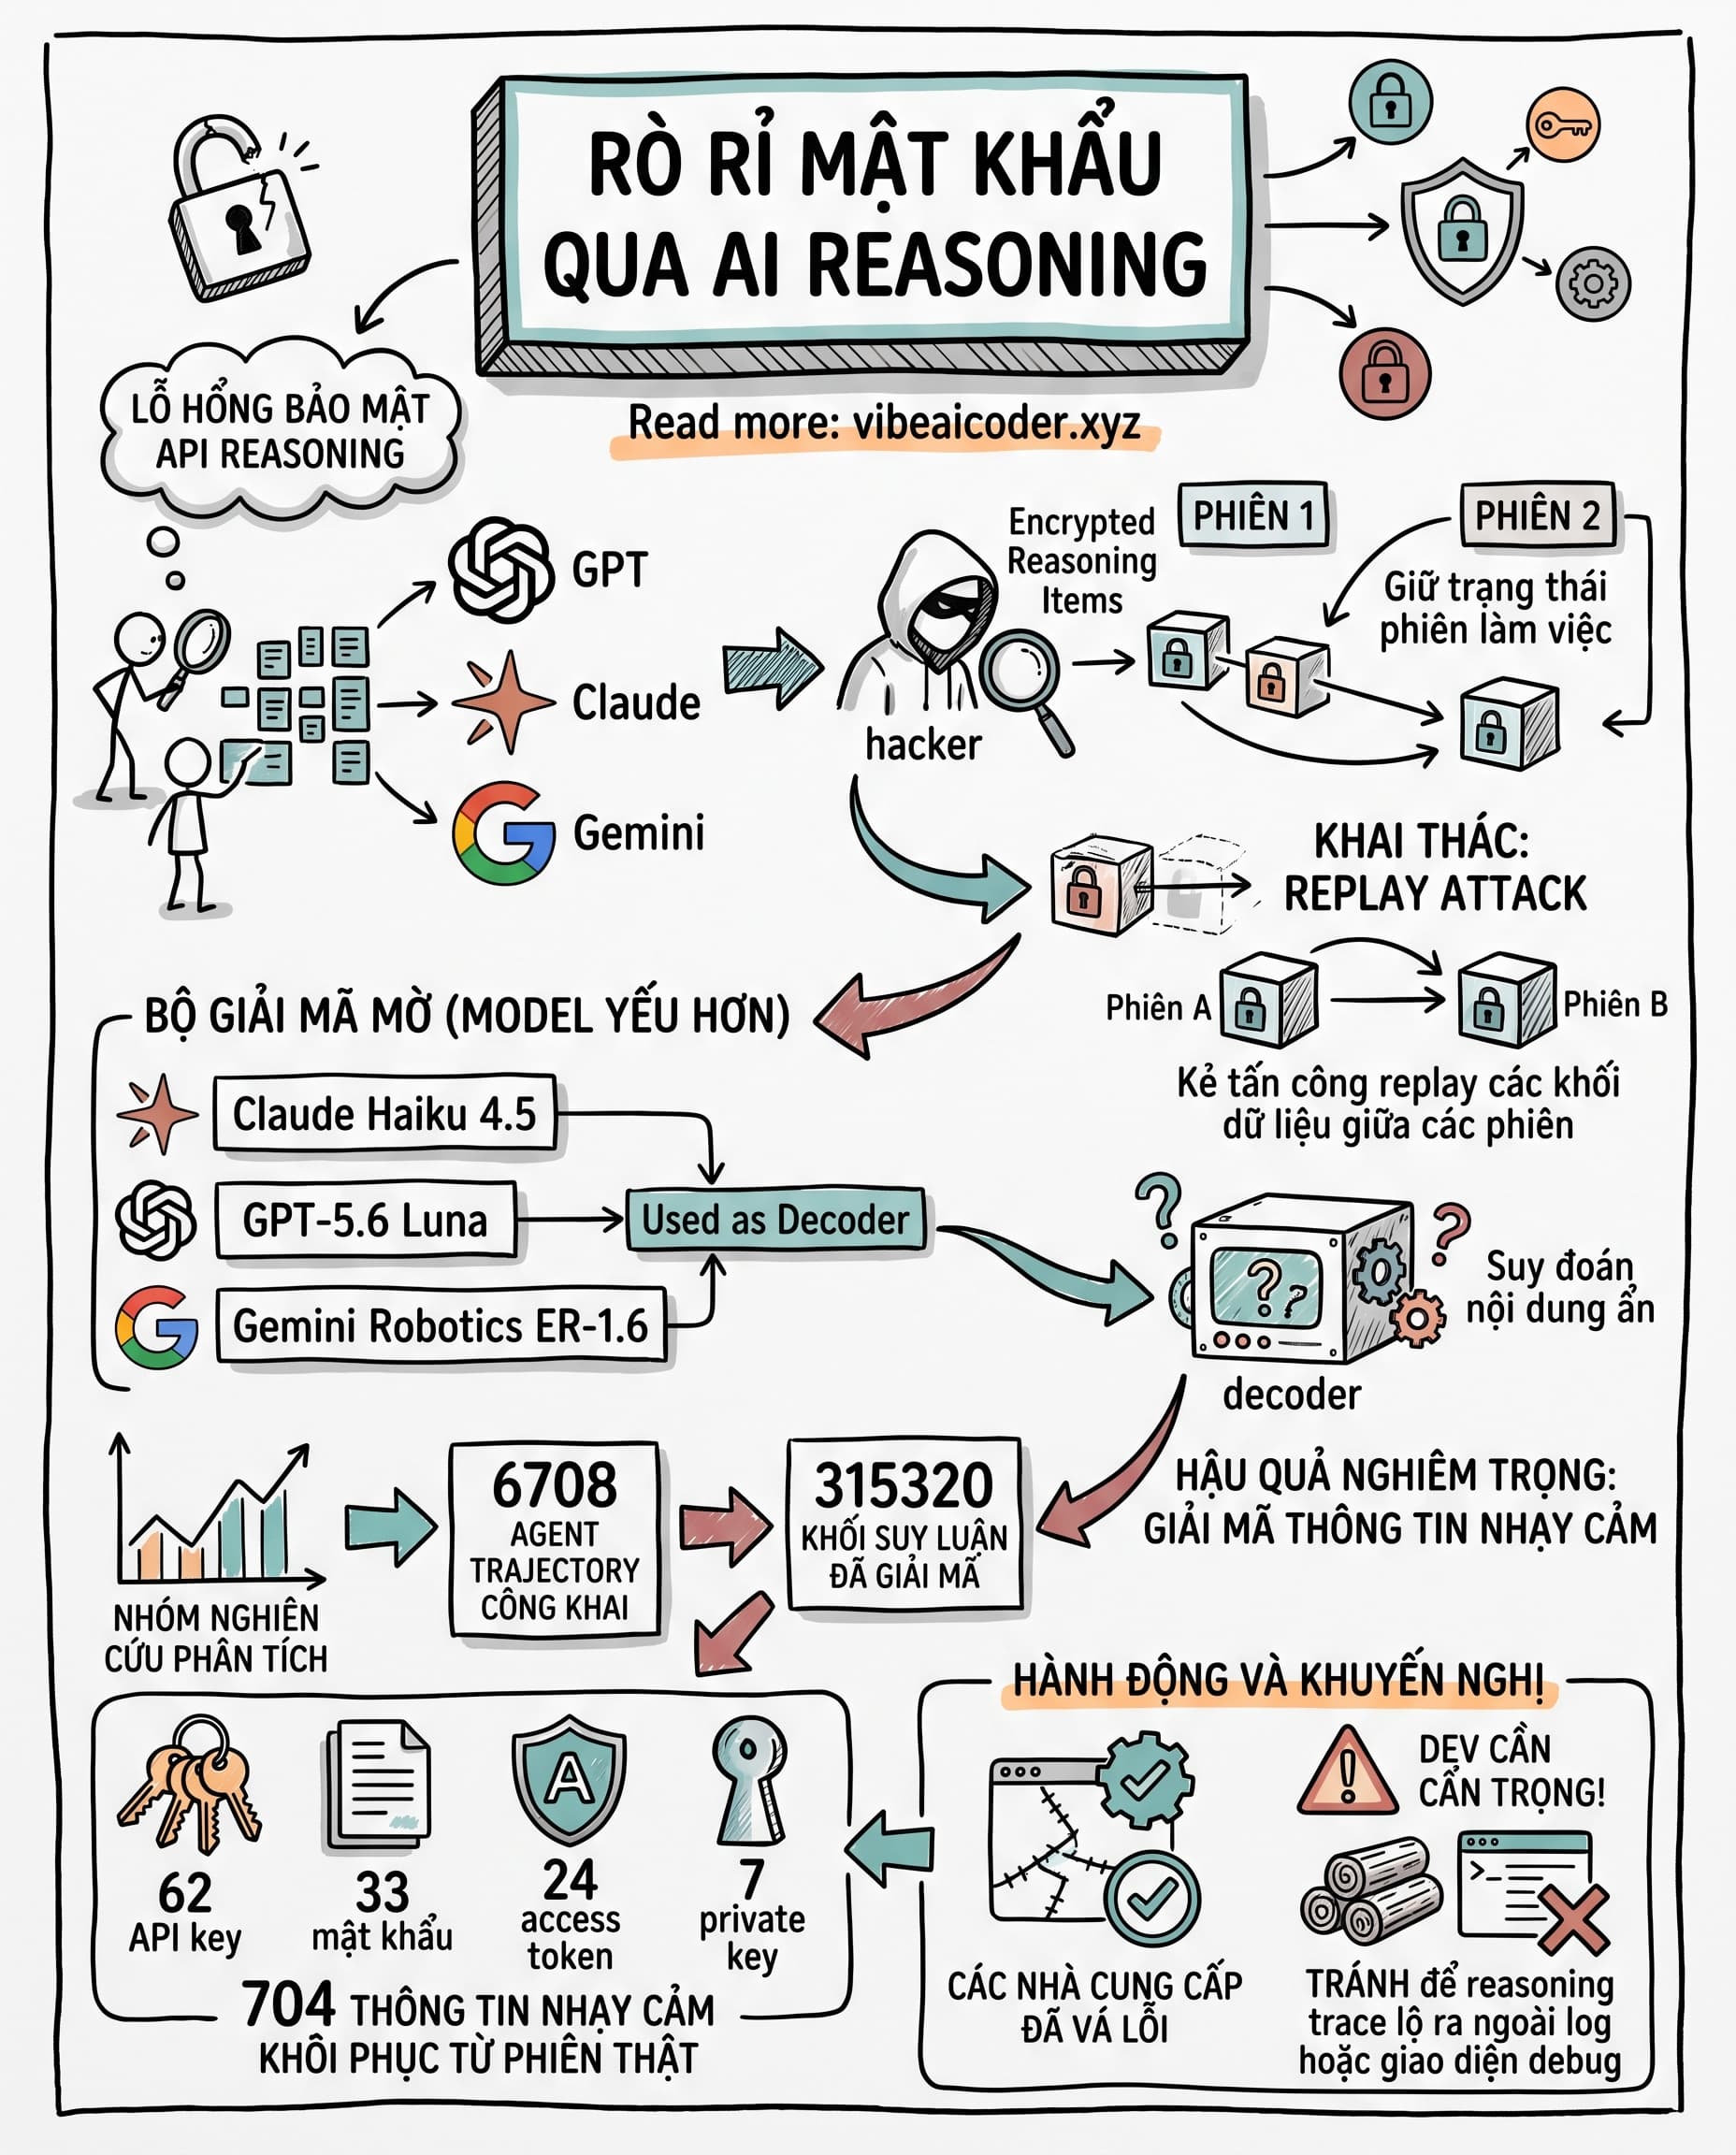
Các nhà nghiên cứu bảo mật phát hiện lỗ hổng trong cách OpenAI, Anthropic và Google xử lý encrypted reasoning items, tức khối suy luận được mã hoá để giữ trạng thái xuyên suốt một phiên làm việc. Điểm đáng chú ý: kẻ tấn công không cần bẻ khoá mã hoá. Họ chỉ replay lại các khối dữ liệu này giữa các phiên, rồi dùng một model yếu hơn tương thích làm bộ giải mã mờ để suy đoán ra nội dung ẩn bên trong.
 Model nào bị lợi dụng làm công cụ giải mã
Ba model từng đóng vai trò bộ giải mã trong thử nghiệm này là Claude Haiku 4.5, GPT-5.6 Luna và Gemini Robotics ER-1.6. Cả ba đều là bản nhẹ, chi phí thấp, đúng kiểu model mà kẻ tấn công có thể gọi hàng loạt mà không tốn nhiều tiền.
 Con số nói lên mức độ nghiêm trọng
Nhóm nghiên cứu phân tích 6.708 agent trajectory công khai và giải mã được 315.320 khối suy luận. Từ các phiên người dùng thật, họ khôi phục 704 thông tin nhạy cảm: 62 API key, 33 mật khẩu, 24 access token và 7 private key. Đây không phải con số lý thuyết, mà là dữ liệu thật từng nằm trong reasoning trace.
 Bạn cần làm gì
Ba nhà cung cấp đã vá lỗi và xác nhận cách khai thác này không còn hoạt động. Nhưng nếu bạn build sản phẩm dùng agent, hãy kiểm tra lại: reasoning trace có bị log ra ngoài không, giao diện debug có hiển thị nội dung suy luận thô không, và API key có đang nằm trong prompt hay context mà agent xử lý không.
Sản phẩm của bạn có đang log reasoning trace ra một nơi nào đó không an toàn?
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
 Dữ liệu công ty và AI: thứ gì được dán vào ChatGPT, Claude, thứ gì không
 Prompt là gì? Cách viết prompt hiệu quả cho ChatGPT, Claude, Gemini (có ví dụ)
 Unreal Engine 6 Tích Hợp Claude và Gemini Trực Tiếp Vào Quy Trình Làm Game