Model weights và checkpoint là gì? Vì sao chạy AI ở nhà phải tải file nặng hàng chục GB
 Model weights và checkpoint là gì? Vì sao chạy AI ở nhà phải tải file nặng hàng chục GB
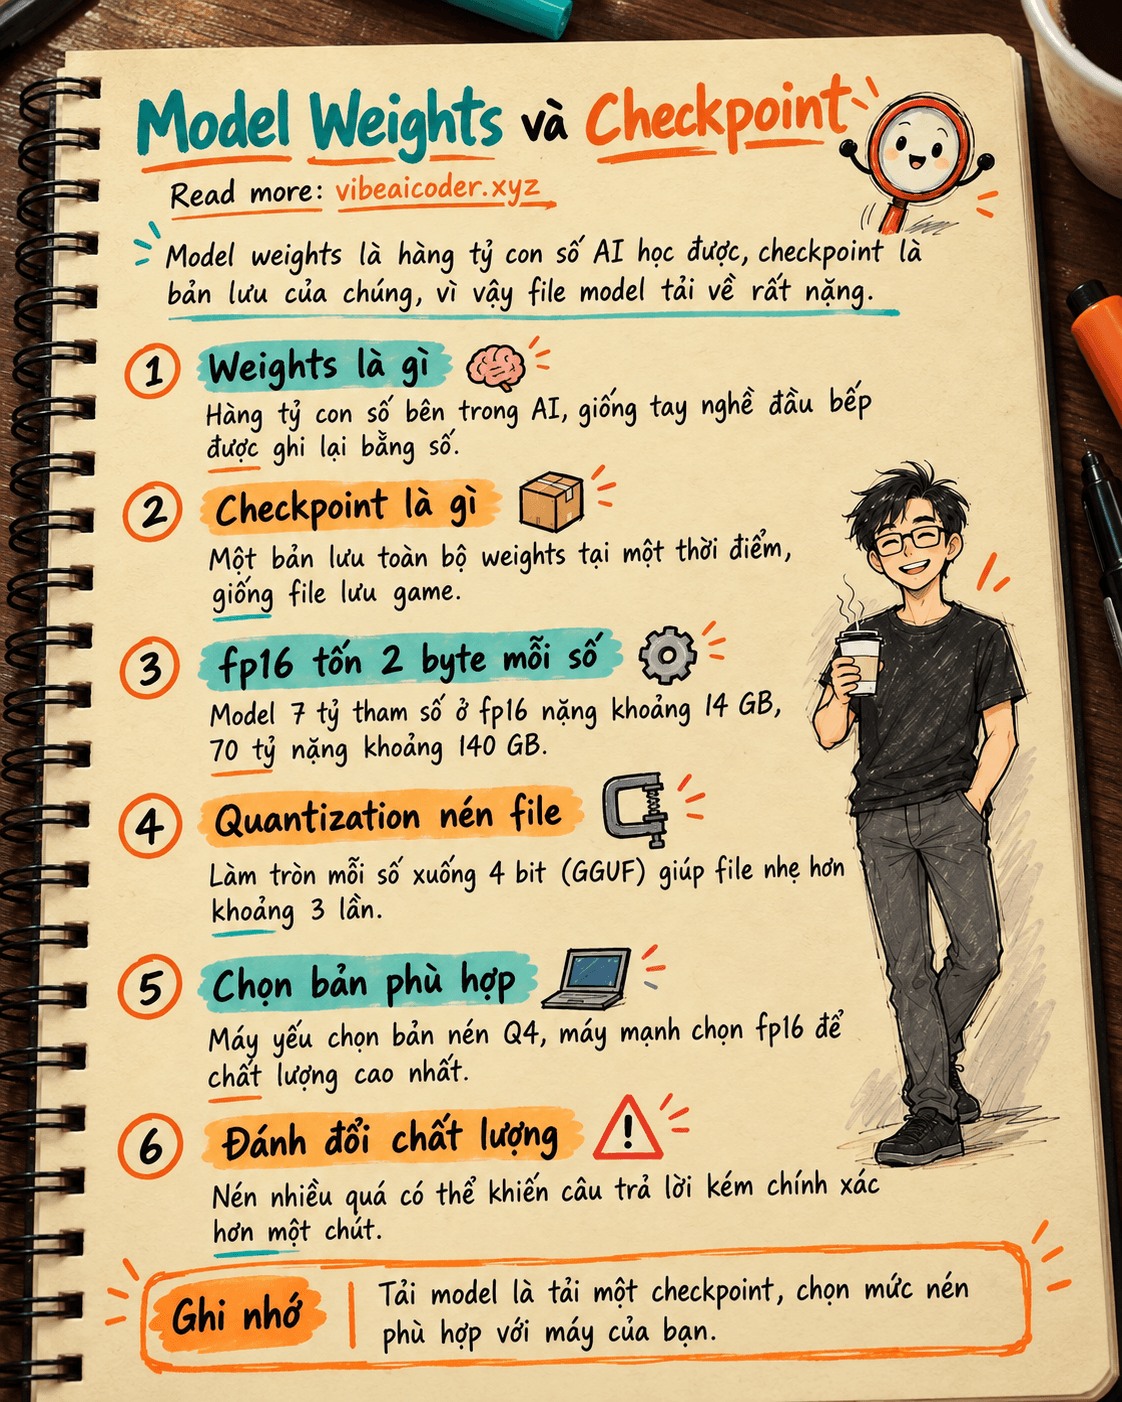
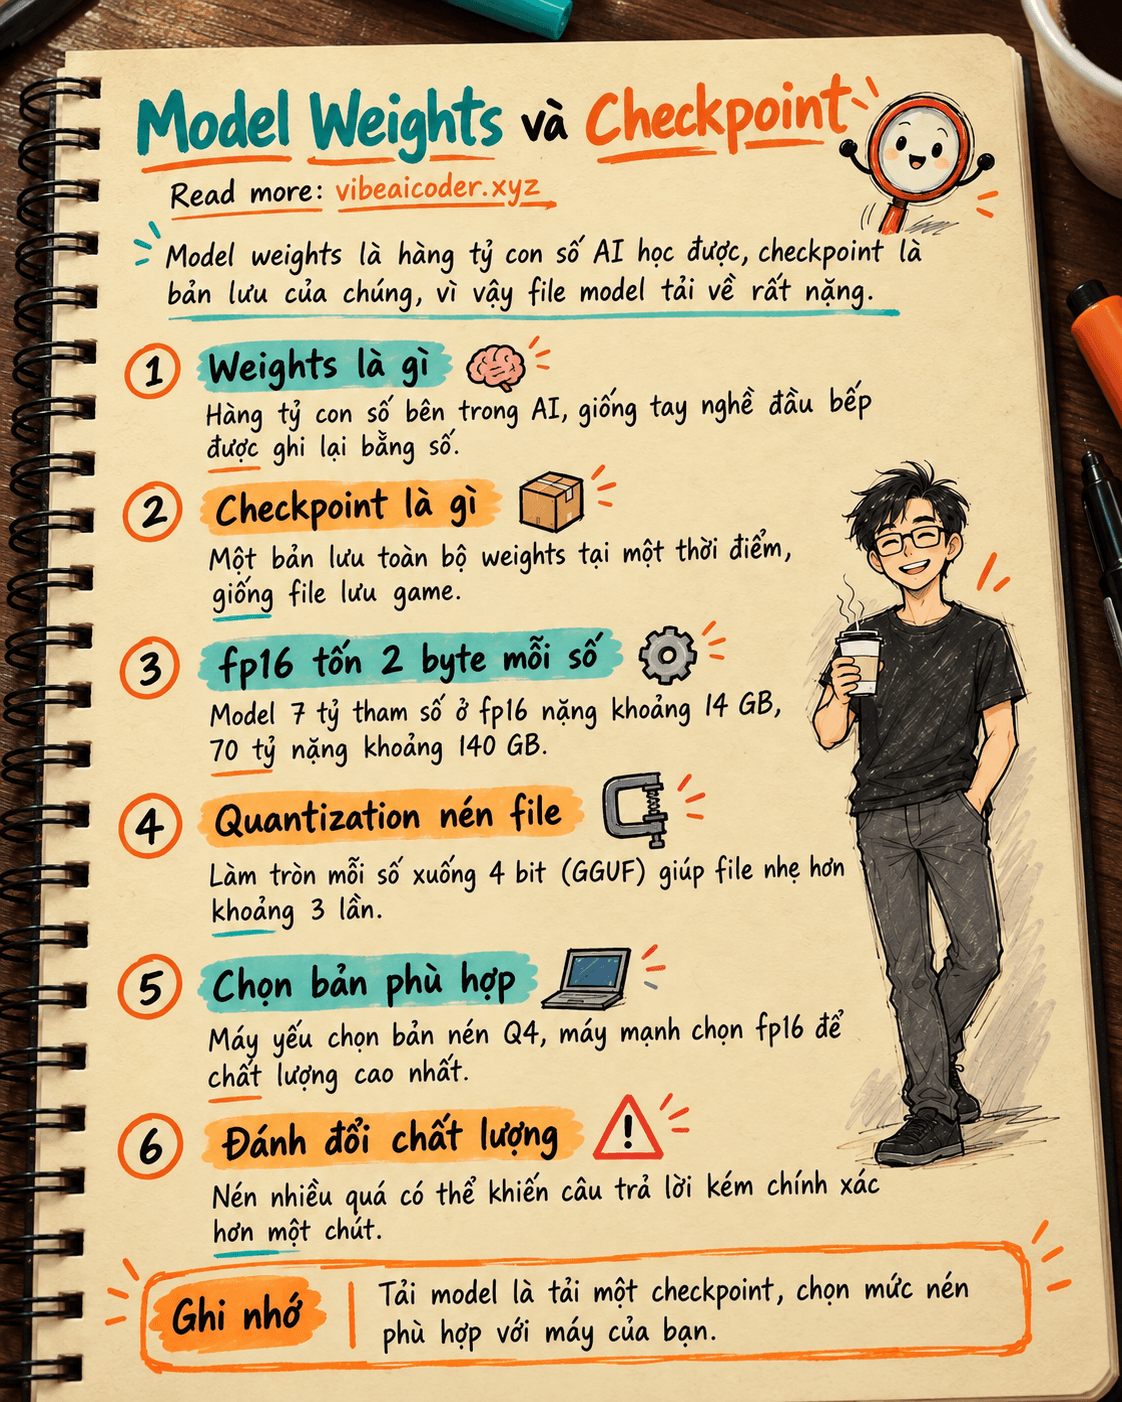
Model weights (trọng số mô hình) là hàng tỷ con số mà AI học được sau quá trình huấn luyện, chúng quyết định AI sẽ trả lời ra sao. Checkpoint là một bản lưu của toàn bộ các con số đó tại một thời điểm, giống như một file lưu game. Khi bạn tải một model về máy để chạy local, thứ bạn thực sự tải chính là file checkpoint chứa toàn bộ weights, và vì có hàng tỷ con số nên file đó nặng. Nếu bạn mới làm quen với AI nói chung, có thể đọc trước bài AI là gì để nắm khái niệm nền trước khi đi sâu vào phần này.
 Hiểu nhanh bằng ví dụ đời thường
Hãy tưởng tượng một đầu bếp học nấu ăn qua hàng triệu lần nấu thử. Sau mỗi lần nấu, đầu bếp chỉnh lại một chút: cho ít muối hơn, đảo đều tay hơn, nêm sớm hơn. Những điều chỉnh đó không nằm trong một cuốn sách công thức, mà nằm trong "cảm giác tay nghề" tích lũy dần.
Model weights chính là "cảm giác tay nghề" đó, nhưng được viết ra thành con số thay vì nằm trong đầu người. Một model nhỏ như 7 tỷ tham số có 7 tỷ con số kiểu vậy, một model lớn như 70 tỷ tham số thì nhiều hơn 10 lần. Checkpoint là lúc bạn "đóng băng" tay nghề của đầu bếp tại một mốc cụ thể, ví dụ sau 100.000 giờ luyện tập, rồi ghi toàn bộ cảm giác tay nghề đó ra một cuốn sổ để người khác có thể sao chép lại y hệt. Cuốn sổ càng ghi chi tiết (nhiều con số, mỗi con số ghi chính xác đến từng milimet) thì càng dày, đó là lý do file checkpoint có thể nặng tới vài chục GB.
Bài parameter của AI là gì đã giải thích vì sao số tham số nhiều thường giúp AI giỏi hơn. Bài này nói về chuyện khác: những tham số đó được lưu thành file như thế nào, và vì sao file đó nặng đến mức máy bạn tải về phải chờ rất lâu.
 Nó hoạt động thế nào
- Huấn luyện tạo ra weights. Trong lúc huấn luyện, model đọc rất nhiều dữ liệu và liên tục chỉnh sửa hàng tỷ con số bên trong nó, mỗi con số là một weight. Quá trình này có thể chạy nhiều tuần trên hàng nghìn chip GPU.
- Checkpoint là ảnh chụp của toàn bộ weights. Các công ty AI không đợi huấn luyện xong mới lưu một lần, họ lưu checkpoint định kỳ, ví dụ mỗi vài giờ, để nếu máy chủ bị lỗi thì chỉ mất vài giờ tiến độ thay vì mất trắng cả quá trình. Checkpoint cuối cùng, sau khi đã kiểm tra chất lượng, chính là bản được công bố ra ngoài cho người dùng tải về.
- Mỗi con số cần một lượng chỗ lưu trữ nhất định. Cách phổ biến nhất là lưu mỗi weight bằng 16 bit (gọi là fp16), tức 2 byte cho một con số. Một model 7 tỷ tham số ở định dạng này nặng khoảng 14 GB, một model 70 tỷ tham số nặng khoảng 140 GB.
- Quantization nén file lại để máy thường chạy nổi. Vì không phải ai cũng có máy đủ mạnh để tải và chạy một file 14 hay 140 GB, người ta phát minh ra quantization: làm tròn mỗi con số để nó chỉ cần 4 hoặc 8 bit thay vì 16 bit. Một model 7 tỷ tham số sau khi nén xuống 4 bit (định dạng phổ biến gọi là GGUF) chỉ còn khoảng 4 đến 5 GB, nhẹ hơn khoảng 3 lần.
- Đổi lại, model nén có thể trả lời kém chính xác hơn một chút. Làm tròn con số nghĩa là mất một phần chi tiết, giống như nén ảnh JPEG chất lượng thấp: ảnh vẫn xem được nhưng mất vài chi tiết nhỏ. Với hầu hết việc dùng hằng ngày, sự khác biệt này khó nhận ra bằng mắt thường.
 Điều này có ý nghĩa gì với bạn
- Khi bạn thấy một model trên các trang chia sẻ model có nhiều bản tải khác nhau cùng tên, ví dụ "Q4", "Q8", "fp16", đó chính là các mức nén khác nhau của cùng một checkpoint. Chọn bản Q4 nếu máy bạn ít RAM, chọn fp16 nếu máy khỏe và muốn chất lượng cao nhất.
- Nếu bạn định chạy AI ngay trên máy tính cá nhân (xem thêm bài chạy AI tại chỗ cần máy mạnh cỡ nào), hãy kiểm tra dung lượng ổ cứng còn trống và RAM trước, vì file checkpoint vài chục GB phải nằm gọn trong bộ nhớ khi chạy chứ không chỉ nằm trên ổ cứng.
- Khi tải model từ các kho model mã nguồn mở (xem bài mã nguồn mở và mã nguồn đóng trong AI), bạn sẽ thấy nhiều "checkpoint" của cùng một model được đăng ở các thời điểm huấn luyện khác nhau, bản mới hơn thường trả lời tốt hơn bản cũ dù cùng kích thước.
- Nếu đường mạng chậm hoặc ổ cứng nhỏ, việc tải nhầm bản chưa nén (fp16) thay vì bản đã nén (GGUF 4 bit) là lý do phổ biến khiến một lần tải model mất nhiều giờ một cách không cần thiết.
 Hiểu lầm thường gặp
- "Checkpoint chỉ là một thuật ngữ kỹ thuật, không liên quan đến tôi." Thực ra bất cứ khi nào bạn tải một model về máy, ví dụ từ các kho model mã nguồn mở, file bạn bấm tải chính là một checkpoint. Hiểu khái niệm này giúp bạn biết vì sao có nhiều phiên bản cùng tên và nên chọn bản nào.
- "Model nén (quantized) là bản rút gọn tính năng, thiếu khả năng so với bản gốc." Không đúng. Quantization chỉ làm tròn con số để file nhẹ hơn và chạy nhanh hơn, model vẫn giữ nguyên toàn bộ kiến trúc và hầu như toàn bộ khả năng, chỉ có độ chính xác của từng câu trả lời giảm đi một chút.
- "File model nặng vì nó chứa dữ liệu huấn luyện bên trong." Sai. Checkpoint không chứa lại các văn bản, hình ảnh mà model từng học, nó chỉ chứa các con số weights kết quả của việc học đó. Đây cũng là lý do một model không thể "trích xuất nguyên văn" dữ liệu huấn luyện của nó một cách đáng tin cậy, nó chỉ còn giữ lại các con số đã được điều chỉnh.
 Câu hỏi thường gặp
Weights và parameters có phải là một không? Gần như là một. Parameters là tên gọi chung cho các con số bên trong model, còn weights là loại parameter phổ biến nhất (còn có một loại nhỏ khác gọi là bias). Trong giao tiếp hằng ngày, hai từ này thường được dùng thay cho nhau.
Tại sao không công bố mỗi checkpoint ở một định dạng duy nhất cho gọn? Vì người dùng có nhu cầu khác nhau. Người chạy trên máy chủ mạnh muốn chất lượng cao nhất nên cần bản fp16 hoặc fp32, người chạy trên laptop cá nhân cần bản đã nén để vừa với RAM. Nhiều cộng đồng mã nguồn mở còn tự nén lại checkpoint gốc để chia sẻ các mức nén khác nhau cho người khác chọn.
Checkpoint có giống với việc lưu lịch sử chat của tôi không? Không liên quan. Checkpoint là bản lưu của chính model AI (phần "não" dùng chung cho mọi người), còn lịch sử chat là cuộc hội thoại riêng giữa bạn và AI, được lưu ở một nơi hoàn toàn khác và không làm thay đổi weights của model.
Tải một checkpoint về máy có đồng nghĩa với việc "sở hữu" model đó không? Không hẳn. Bạn có file để chạy, nhưng quyền sử dụng vẫn theo giấy phép đi kèm model đó, có model cho phép dùng tự do kể cả cho mục đích thương mại, có model chỉ cho phép dùng nghiên cứu hoặc cá nhân. Nên đọc giấy phép trước khi dùng cho công việc.
Vì sao model đóng như của các công ty lớn không cho tải checkpoint về? Vì công ty coi checkpoint là tài sản cốt lõi, tốn rất nhiều chi phí huấn luyện để tạo ra. Với model đóng, bạn chỉ gọi model qua API hoặc ứng dụng, checkpoint luôn nằm trên máy chủ của công ty, không bao giờ được gửi ra ngoài.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ