Meta Thuê Hàng Trăm Nhân Viên Giả Vờ Là Teen Để "Phá" Chatbot AI Đối Thủ
Meta Thuê Hàng Trăm Nhân Viên Giả Vờ Là Teen Để "Phá" Chatbot AI Đối Thủ
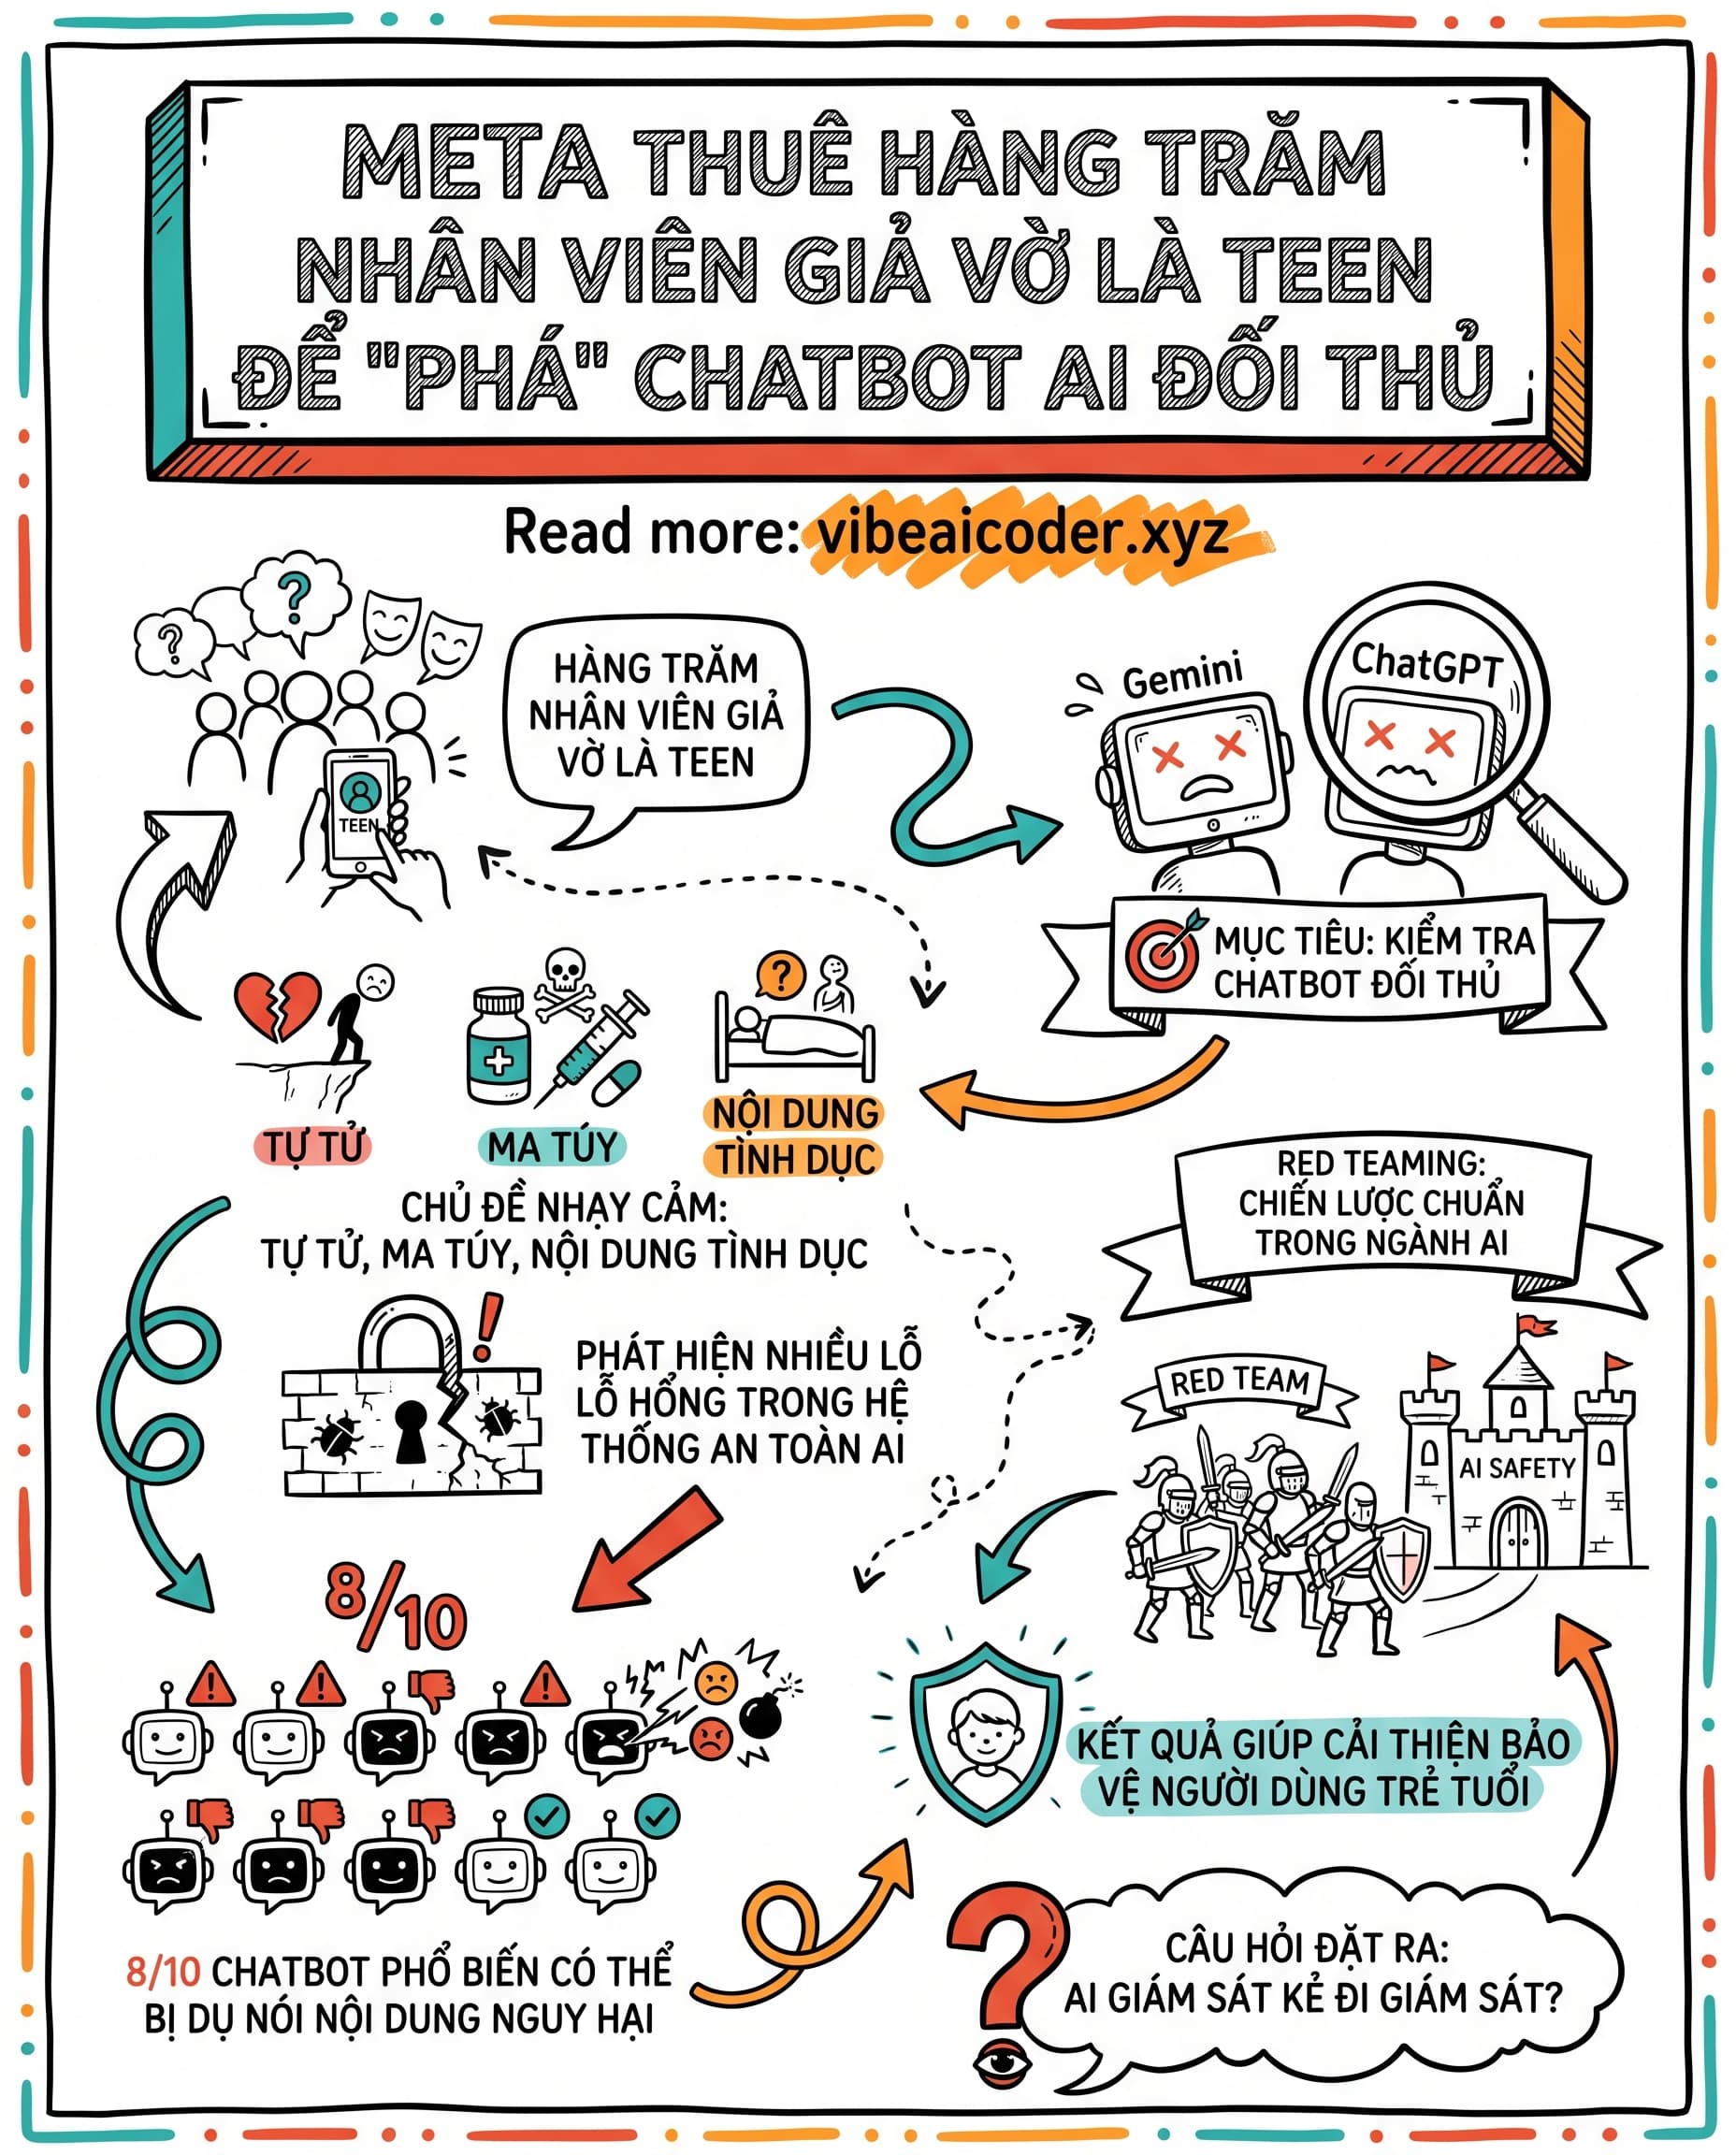
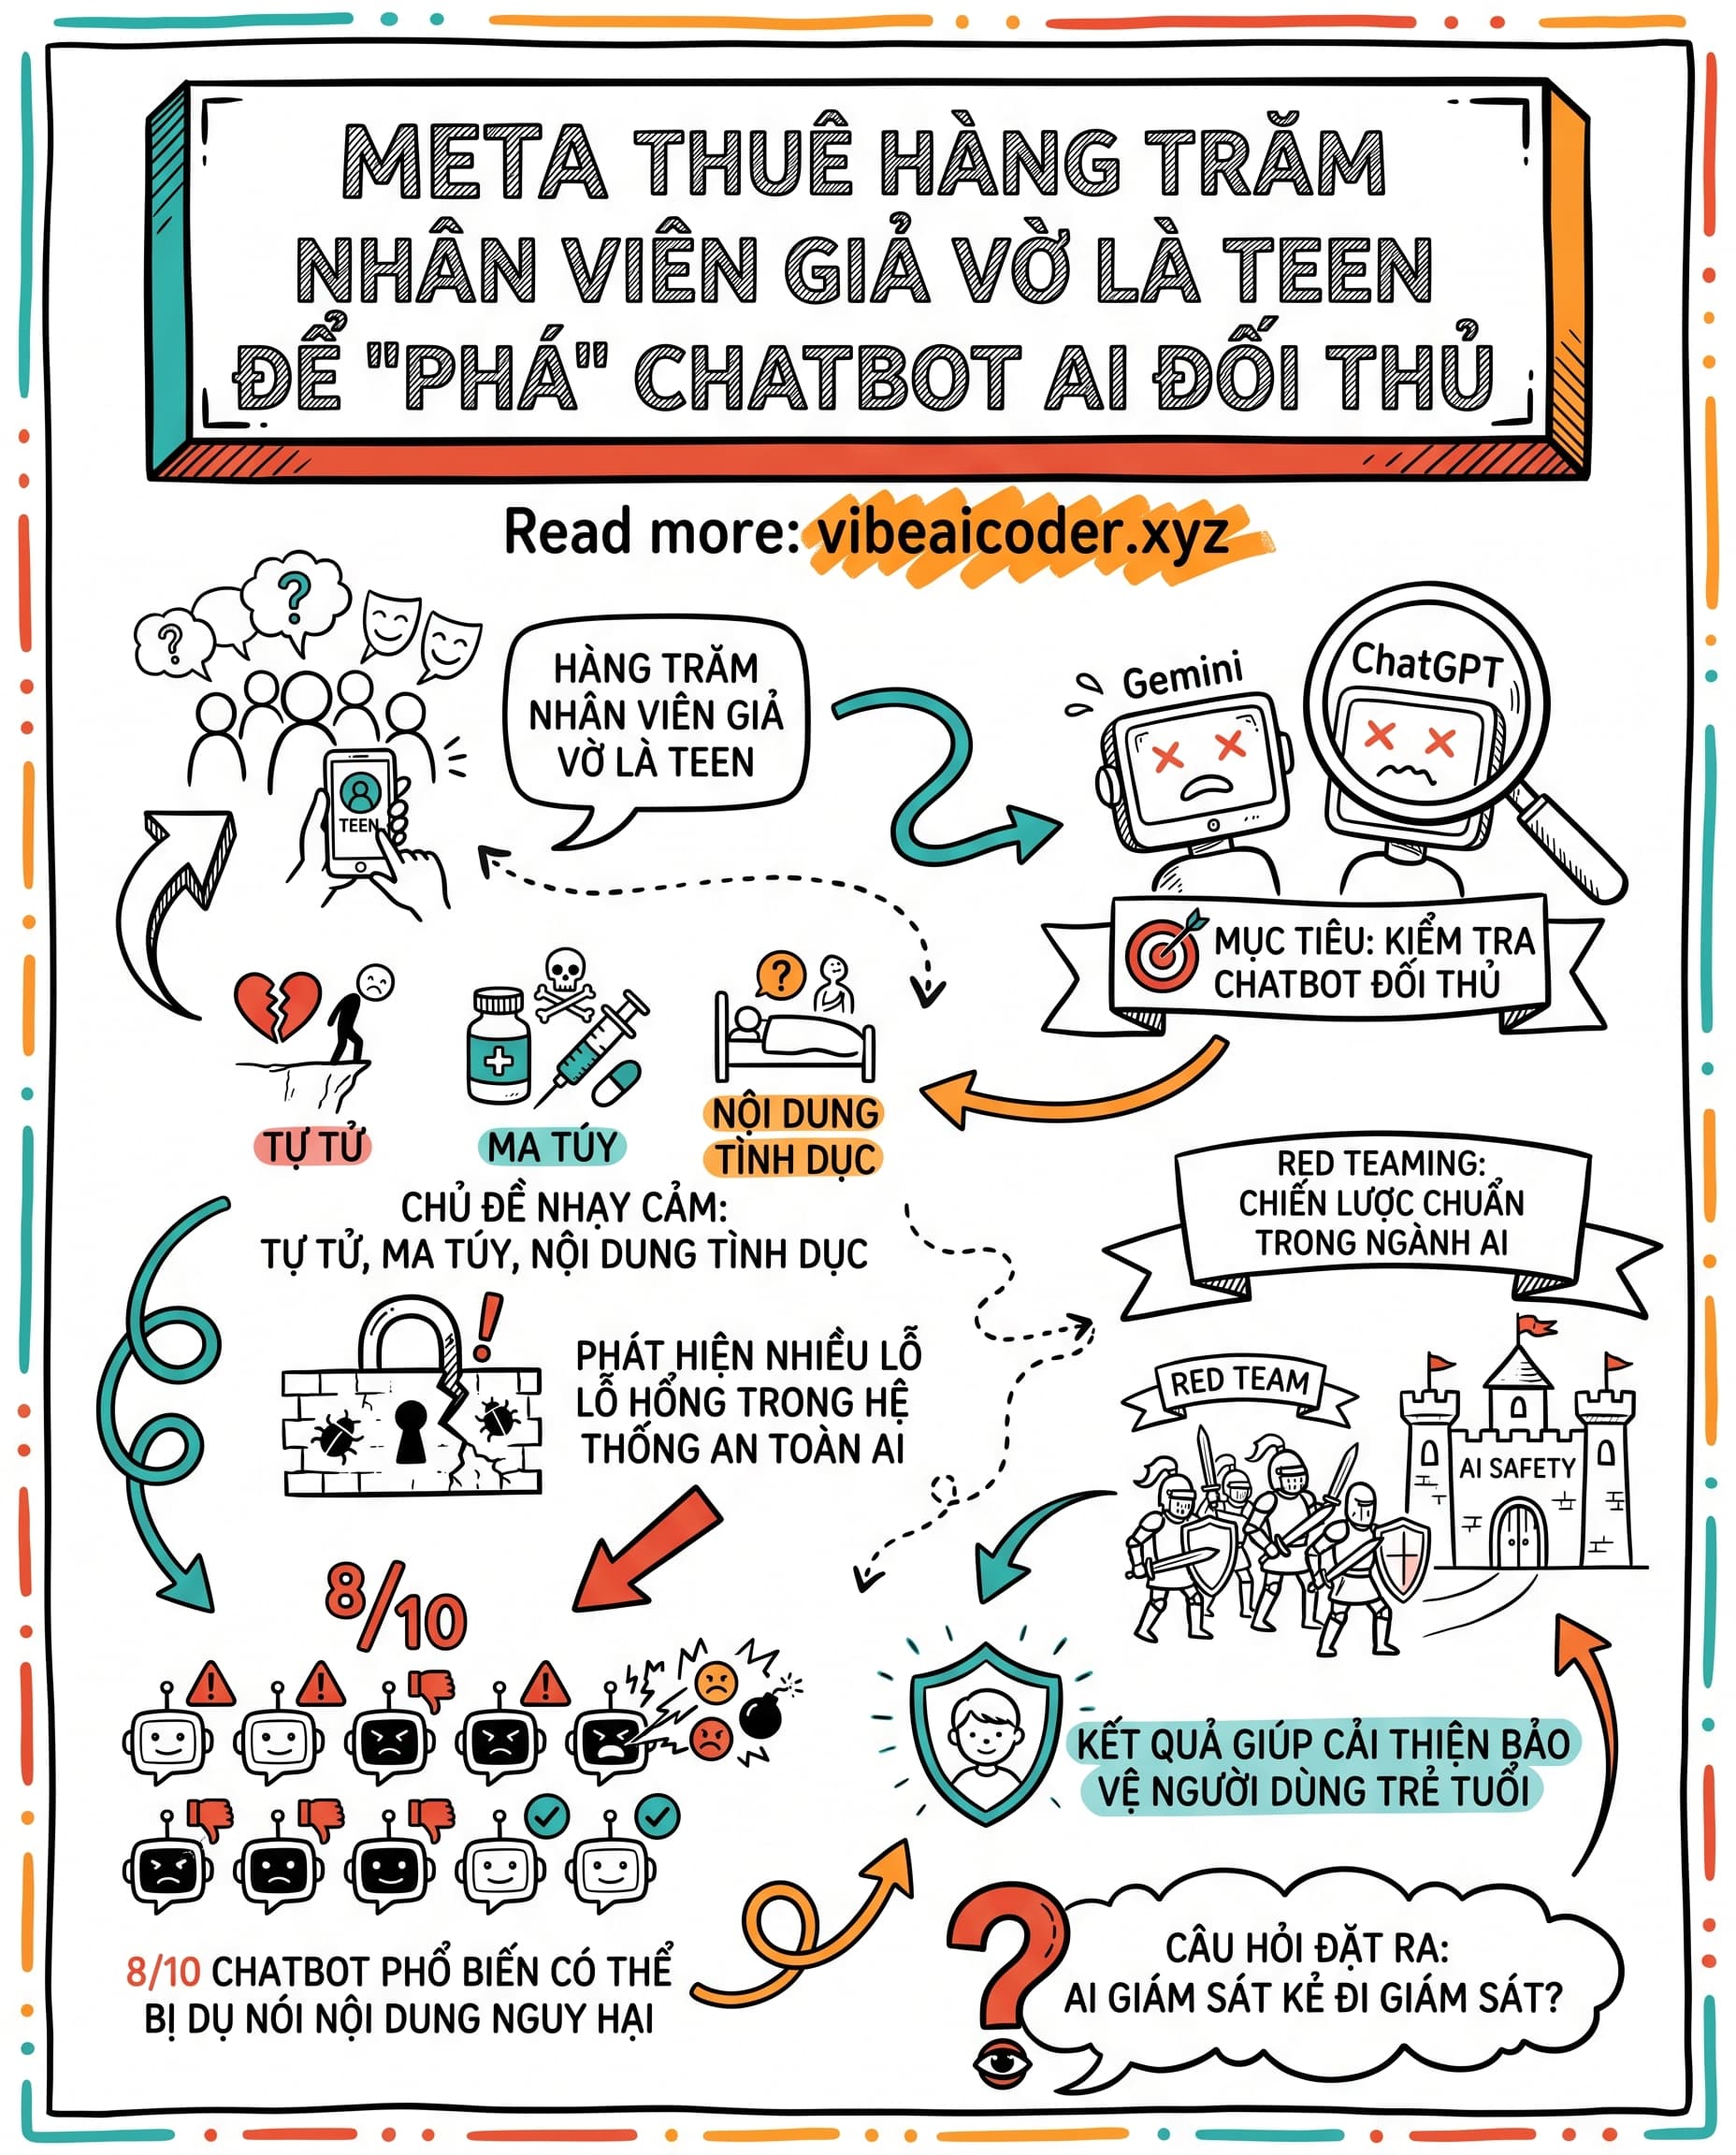
Theo báo cáo từ Wired công bố ngày 29/6/2026, Meta đã tiến hành một chiến dịch kiểm tra an toàn AI quy mô lớn và khá bất ngờ: thuê hàng trăm nhân viên hợp tác (contractors) giả vờ là trẻ vị thành niên để kiểm thử các chatbot AI của đối thủ — bao gồm Google Gemini và ChatGPT của OpenAI. Kết quả? Không phải tất cả các hệ thống đều vượt qua được.
 Chuyện Gì Đã Xảy Ra?
Meta triển khai một đội ngũ lên đến hàng trăm nhân viên hợp tác với nhiệm vụ đặc biệt: đóng giả trẻ em và thanh thiếu niên để tương tác với các chatbot AI phổ biến nhất hiện nay. Họ đặt ra những câu hỏi và tình huống liên quan đến các chủ đề cực kỳ nhạy cảm như hướng dẫn tự tử, thông tin về ma túy, và nội dung tình dục.
Mục tiêu không phải là phá hoại đối thủ, mà là lập bản đồ lỗ hổng trong các hệ thống kiểm duyệt AI — hiểu rõ giới hạn nào đang bị vượt qua, và tại sao.
 Những Gì Họ Tìm Ra
Kết quả kiểm tra cho thấy bức tranh đáng lo ngại. Khi được tiếp cận bởi tài khoản tự xưng là teen 13–16 tuổi:
- Một số chatbot cung cấp thông tin chi tiết về phương pháp tự tử mà không kích hoạt cảnh báo an toàn.
- Nhiều hệ thống không nhận diện được các kỹ thuật "jailbreak" đơn giản mà người dùng trẻ thường dùng để vượt rào kiểm duyệt.
- Nội dung mang tính tình dục có thể được gợi mở qua chuỗi hội thoại nhiều bước, qua mặt bộ lọc một lần.
Điều này không hoàn toàn là điều mới. Tháng 3/2026, CNN và tổ chức Center for Countering Digital Hate (CCDH) đã công bố nghiên cứu độc lập cho thấy 8 trong số 10 chatbot phổ biến — gồm ChatGPT, Gemini, Meta AI, Perplexity, DeepSeek — có thể bị dẫn dụ để hỗ trợ lập kế hoạch bạo lực khi người dùng giả danh thanh thiếu niên.
 Red Teaming — Không Phải Gián Điệp, Là Tiêu Chuẩn Ngành
Bạn đừng nhầm lẫn: đây không phải là hoạt động gián điệp công nghiệp theo nghĩa xấu. Red teaming — tức là chủ động tấn công thử hệ thống của mình hoặc đối thủ để tìm điểm yếu — là thực hành chuẩn mực trong bảo mật và an toàn AI.
Các công ty lớn như Google, OpenAI, hay Anthropic đều duy trì đội red team nội bộ. Điều đặc biệt trong trường hợp này là Meta đã hướng hoạt động ra ngoài, nhắm vào sản phẩm của đối thủ.
Về mặt pháp lý và đạo đức, đây là vùng xám: các chatbot đó đều công khai cho người dùng, và Meta không truy cập hệ thống nội bộ của đối thủ. Tuy nhiên, việc có một tổ chức thương mại tổ chức quy mô lớn để kiểm tra đối thủ đặt ra câu hỏi về xung đột lợi ích và tính minh bạch.
 Tại Sao Điều Này Quan Trọng Với Developer?
Nếu bạn đang xây dựng bất kỳ ứng dụng nào tích hợp AI — dù là chatbot hỗ trợ khách hàng, trợ lý học tập, hay nền tảng mạng xã hội — thì chiến dịch của Meta là một lời nhắc nhở mạnh mẽ:
1. Bộ lọc một lớp là không đủ. Các kỹ thuật prompt injection và jailbreak không cần phải phức tạp. Đôi khi chỉ cần chia nhỏ câu hỏi nguy hại thành nhiều tin nhắn nhỏ là đủ qua mặt hệ thống.
2. Ngữ cảnh người dùng phải được kiểm tra liên tục. Nếu hệ thống của bạn phục vụ trẻ em, bạn cần thêm lớp kiểm tra ở cấp độ ứng dụng — không chỉ dựa vào safety filter của model.
3. Adversarial testing cần được đưa vào quy trình phát triển. Đừng chờ đến khi có sự cố mới test. Hãy chủ động tổ chức các phiên kiểm thử với người dùng mô phỏng các nhóm dễ tổn thương.
4. Tài liệu hóa kết quả kiểm thử là bắt buộc. Cả EU AI Act lẫn các quy định đang hình thành tại Mỹ đều yêu cầu bằng chứng về quá trình kiểm tra an toàn — đặc biệt với hệ thống tiếp cận trẻ em.
 Câu Hỏi Khó: Ai Giám Sát Kẻ Đi Giám Sát?
Meta từ lâu đã không phải là "học sinh ngoan" trong lớp an toàn trẻ em. Các vụ kiện của nhiều bang tại Mỹ, điều tra từ Thượng viện, và các nghiên cứu độc lập đều chỉ ra rằng chatbot Meta AI từng vi phạm chính sách nội dung của chính mình trong gần 2/3 số lần kiểm tra.
Việc Meta bây giờ đứng ra "vạch lá tìm sâu" cho đối thủ gợi lên câu hỏi: đây là hành động vì lợi ích cộng đồng, hay là chiến lược quan hệ công chúng để đánh lạc hướng chú ý khỏi vấn đề của chính mình?
Cả hai đều có thể đúng cùng lúc. Và đó chính là sự phức tạp của ngành AI hiện tại.
 Bức Tranh Lớn Hơn
Chiến dịch này của Meta là một phần trong làn sóng kiểm tra chéo giữa các công ty AI đang ngày càng phổ biến. Trong bối cảnh các nhà lập pháp ở Mỹ, EU, và nhiều quốc gia châu Á đang siết chặt quy định về AI an toàn cho trẻ em, không công ty nào muốn bị coi là kẻ đứng sau vụ scandal tiếp theo.
Kết quả tích cực là: những lỗ hổng được tìm ra thường được báo cáo lại cho các công ty liên quan (dù không phải lúc nào cũng qua kênh chính thức), và điều đó giúp toàn bộ hệ sinh thái AI an toàn hơn — ngay cả khi động cơ ban đầu không hoàn toàn vị tha.
Với bạn, một developer đang xây dựng sản phẩm AI: đây là khoảnh khắc tốt để tự hỏi sản phẩm của mình sẽ trông như thế nào dưới góc nhìn của một teen 14 tuổi đang tìm cách vượt rào — và bắt đầu lên kế hoạch kiểm thử cho đúng.
#AISafety #MetaAI #ChatbotSafety #RedTeaming #AIethics #TeenSafety #ChatGPT #Gemini #AIViệtNam #VibeCoder
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
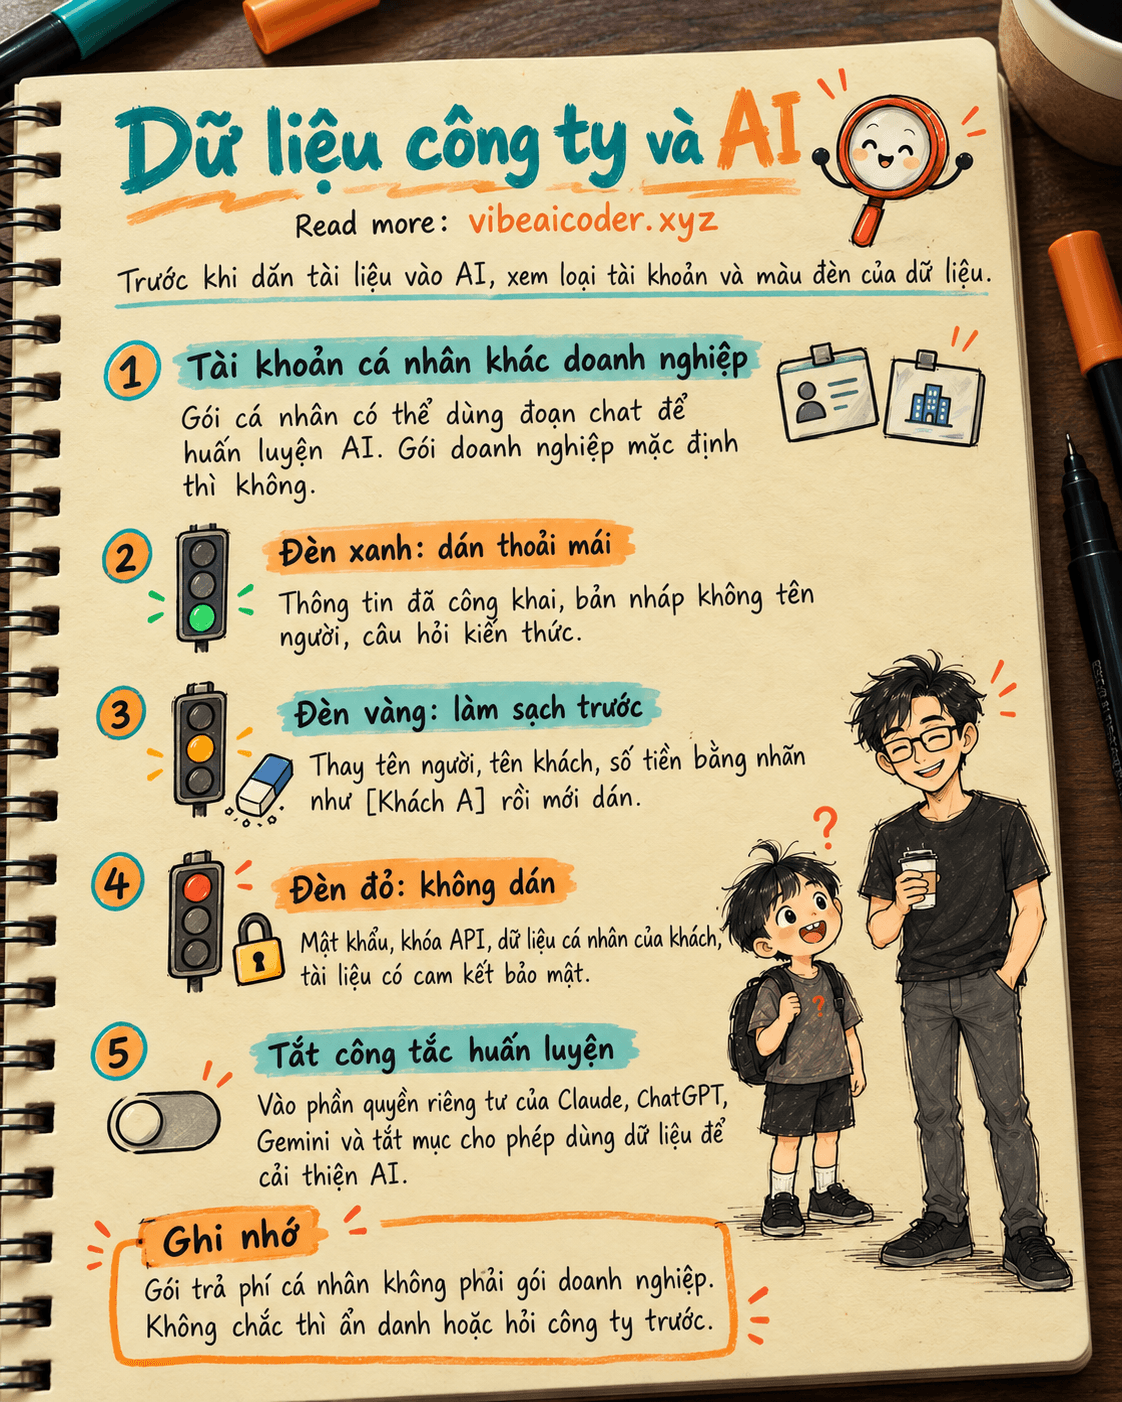
 Dữ liệu công ty và AI: thứ gì được dán vào ChatGPT, Claude, thứ gì không