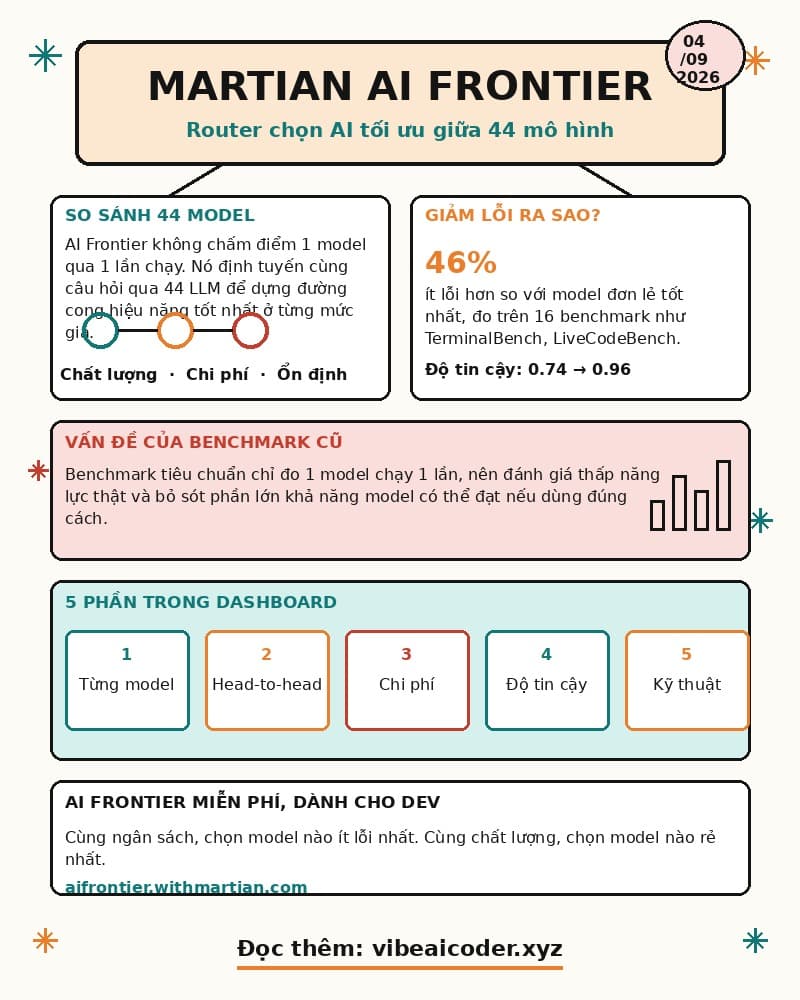
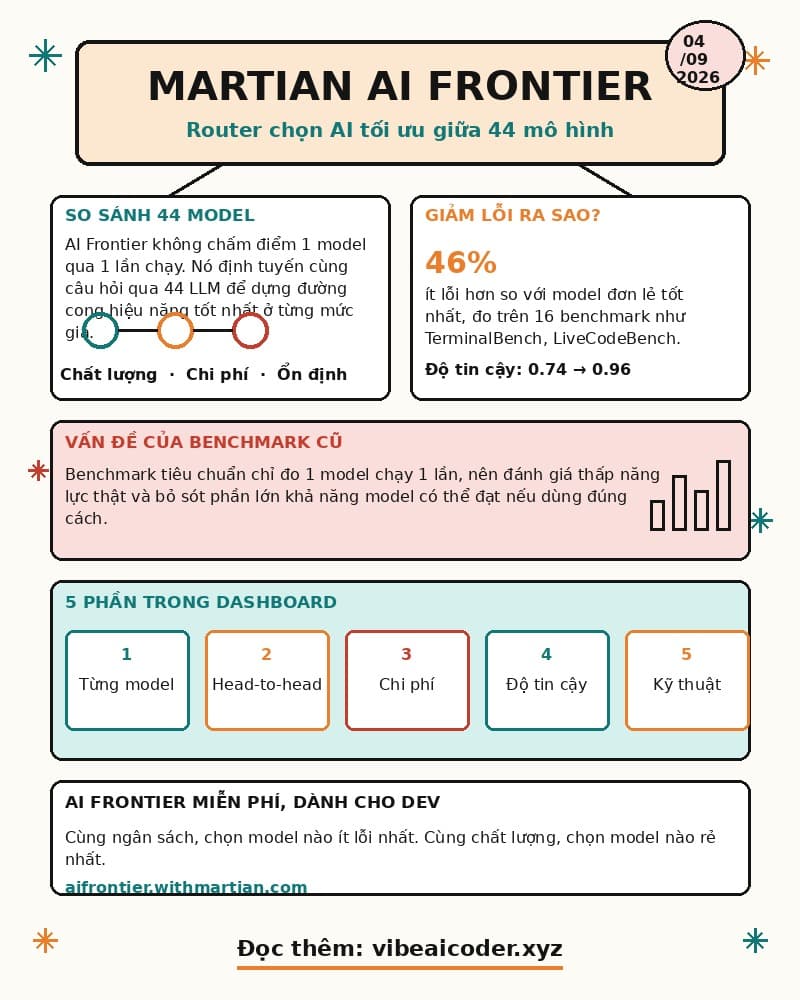
 Martian ra mắt dashboard so 44 AI cùng lúc, giảm 46% lỗi
Bạn đang trả tiền cho GPT, Claude hay Gemini mà không chắc model nào thực sự đáng đồng tiền bát gạo?
AI Frontier là gì
Martian vừa ra mắt AI Frontier, một dashboard so sánh 44 mô hình ngôn ngữ lớn cùng lúc trên ba tiêu chí: chất lượng, chi phí và độ ổn định. Thay vì chấm điểm một model qua một lần chạy như benchmark truyền thống, hệ thống định tuyến cùng một câu hỏi qua toàn bộ 44 model để dựng nên đường Capability Frontier, tức hiệu năng tốt nhất mà bạn đạt được ở từng mức giá.
 46% lỗi biến mất khi nào
Theo Martian, cách định tuyến này giảm 46% lỗi so với model đơn lẻ tốt nhất, đo trên 16 benchmark phổ biến như TerminalBench và LiveCodeBench. Điểm độ tin cậy của các model dao động từ 0.74 đến 0.96, tùy vào việc bạn dùng một model cố định hay để hệ thống tự định tuyến theo từng câu hỏi.
 Benchmark cũ bỏ sót điều gì
Martian chỉ thẳng vấn đề gốc rễ: benchmark tiêu chuẩn chỉ đo một model chạy một lần, nên đánh giá thấp năng lực thật và bỏ sót phần lớn khả năng model đạt được nếu dùng đúng cách. Martian chia AI Frontier làm 5 phần để bù lại chỗ thiếu đó: phân tích từng model, so sánh đối đầu, chi phí, độ tin cậy và kết quả kỹ thuật, kèm link paper gốc cho ai muốn đọc sâu.
 Khác gì so với việc chọn đại một model
Cách làm cũ là chọn một model rồi dùng cho mọi tác vụ, chấp nhận model đó mạnh chỗ này yếu chỗ kia. Model routing đảo ngược cách đó: hệ thống gửi mỗi câu hỏi tới model phù hợp nhất ở thời điểm đó, dựa trên dữ liệu benchmark thực tế thay vì đoán mò.
 Ai nên quan tâm
Đội nào đang chi hàng chục nghìn đô mỗi tháng cho API LLM có thể dùng AI Frontier để trả lời hai câu hỏi: cùng ngân sách nên chọn model nào ít lỗi nhất, cùng chất lượng nên chọn model nào rẻ nhất. Bạn xem dữ liệu miễn phí tại aifrontier.withmartian.com, không cần đăng ký.
Bạn đang chọn model AI cho sản phẩm của mình dựa trên gì? Kể mình nghe ở phần bình luận nhé!
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
 Patronus AI gọi 50 triệu USD để soi lỗi cho AI agent

 GLM-5.2 Ra Mắt: 1 Triệu Token Context, MIT License, Ngang Ngửa Claude Opus Nhưng Miễn Phí