 LMCache: Giải Pháp Giữ KV Cache LLM Không Bao Giờ Bị Mất Nữa
Mỗi lần restart engine, toàn bộ KV cache bay đi. Mọi prompt tương tự phải tính lại từ đầu. LMCache sinh ra để chấm dứt chuyện đó.
 KV Cache Là Gì Và Tại Sao Nó Quan Trọng
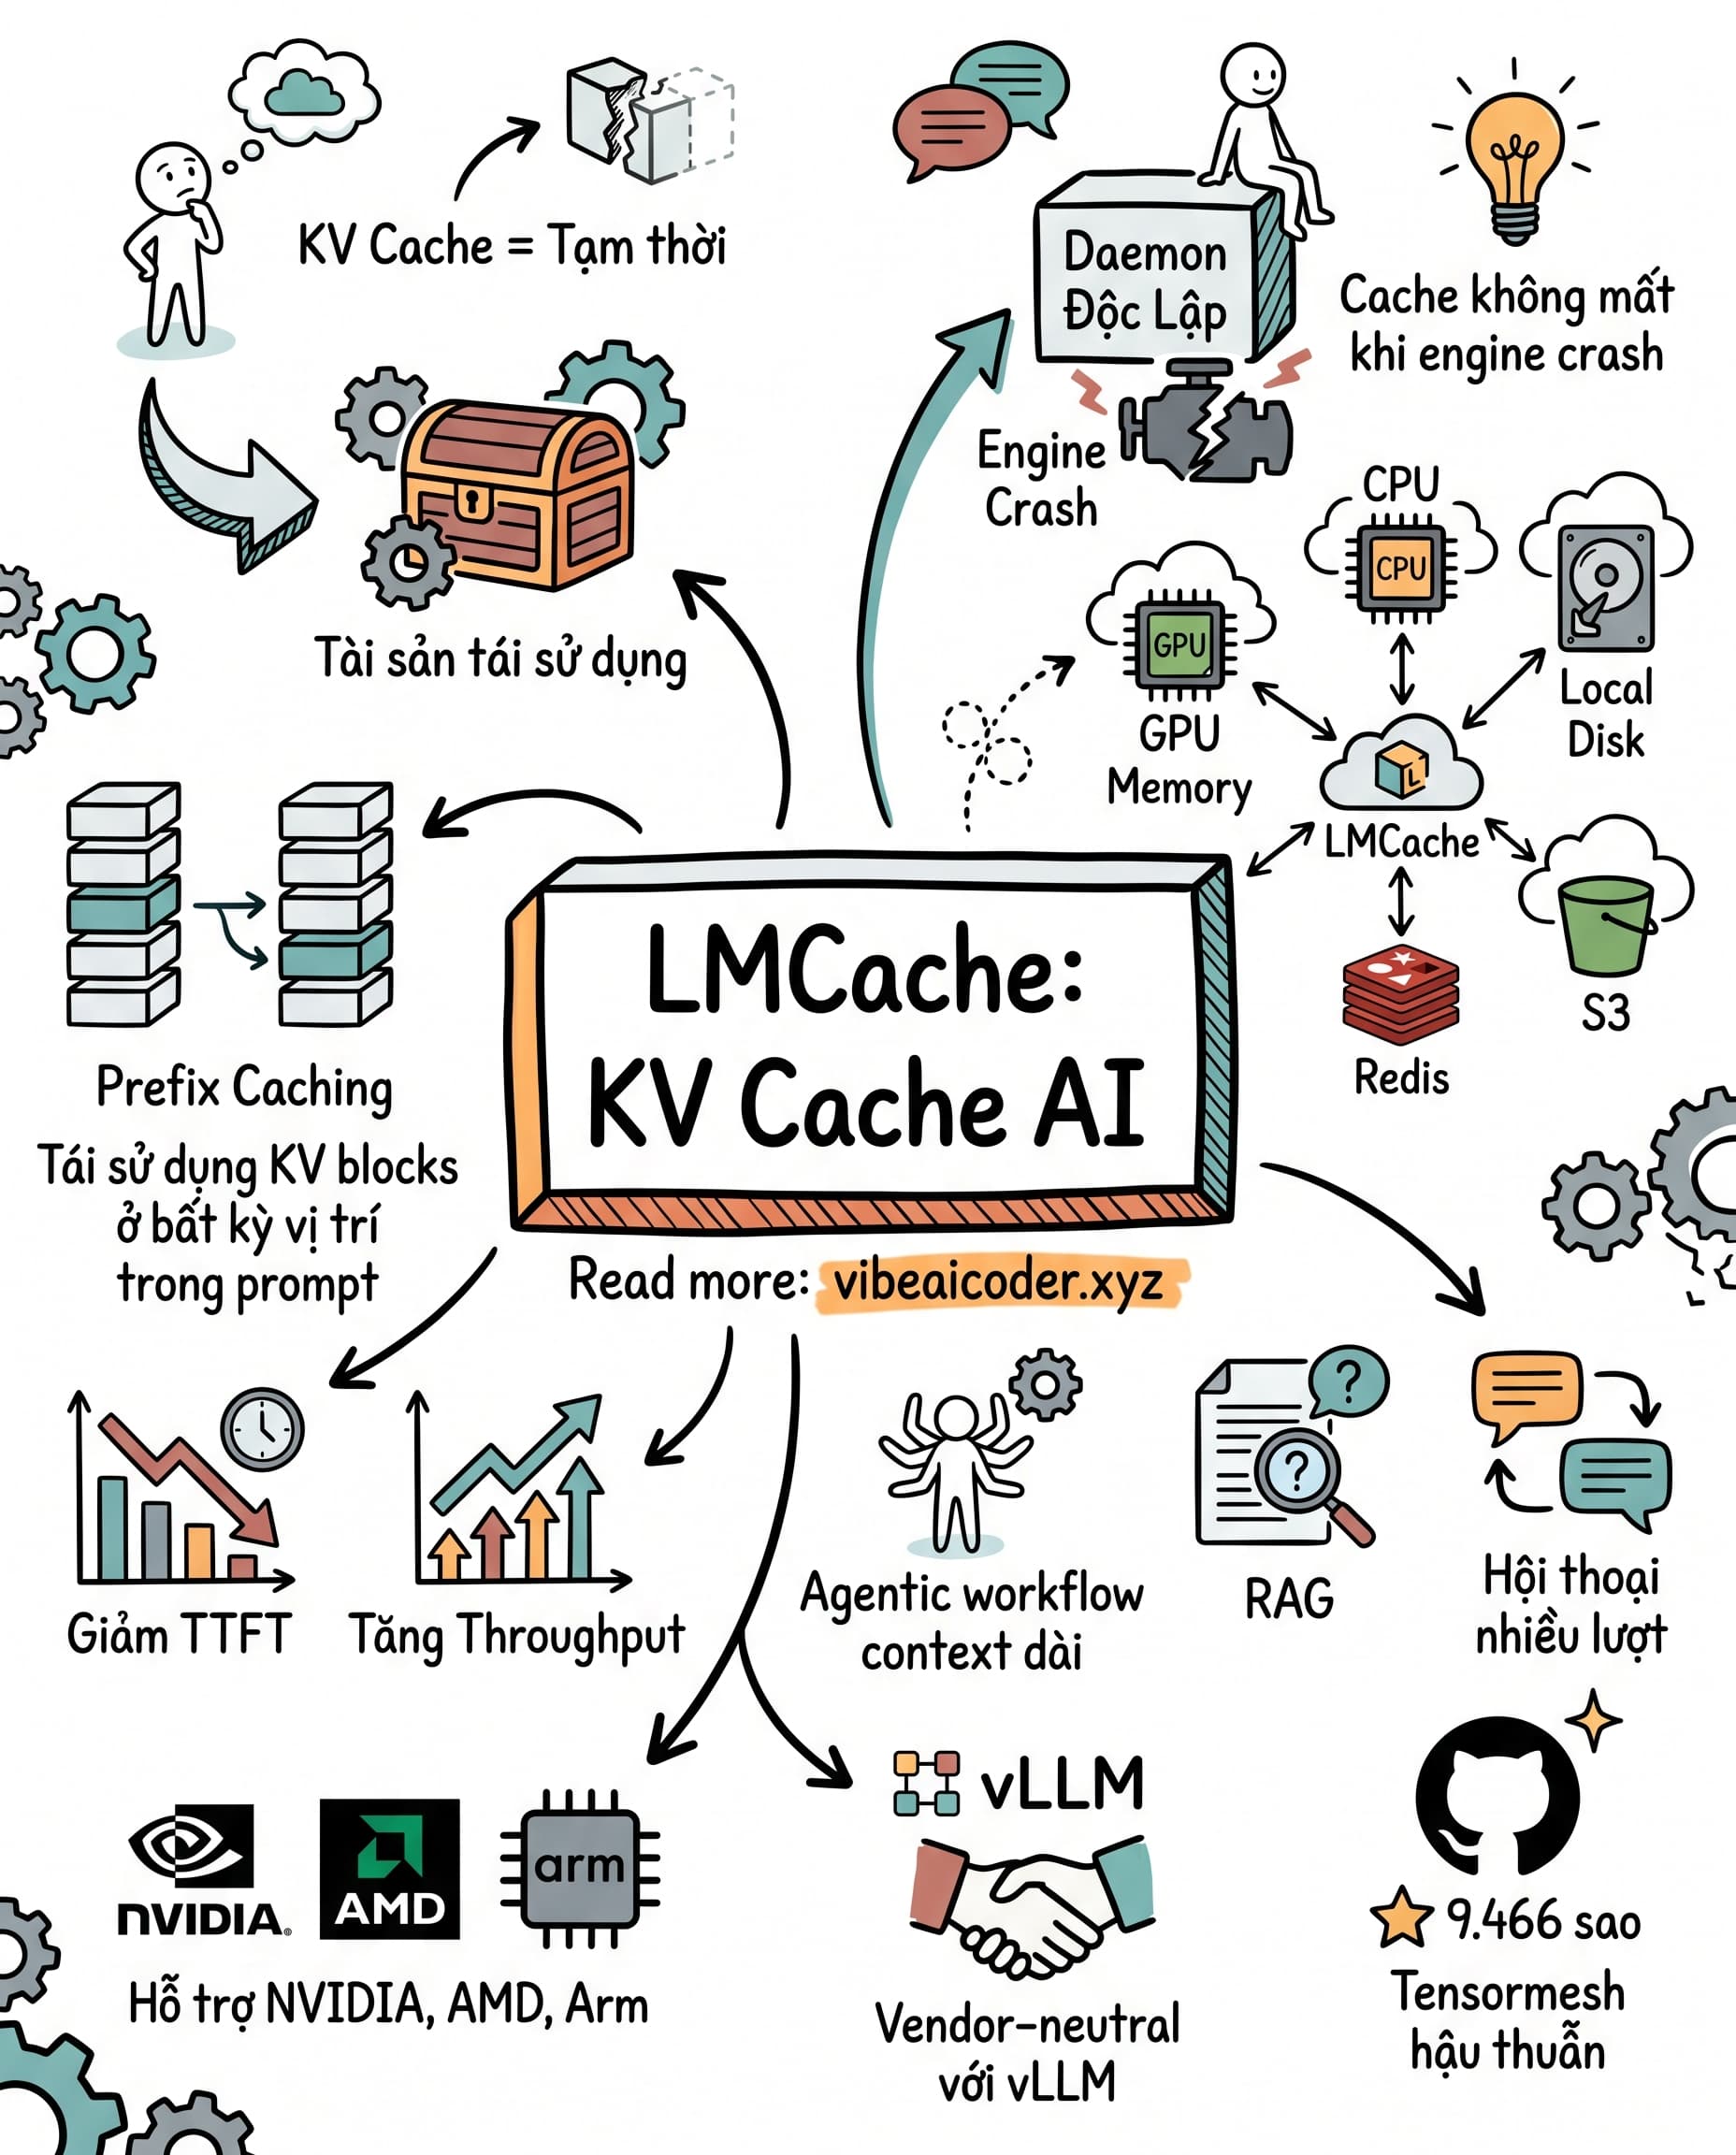
Khi LLM xử lý một prompt, nó tạo ra KV cache (Key-Value cache) để lưu trung gian tính toán của từng token. Lần sau nếu prompt có phần giống nhau, engine có thể dùng lại cache đó thay vì tính lại từ đầu, tiết kiệm đáng kể thời gian và tài nguyên GPU.
Vấn đề là: cache này chỉ tồn tại trong bộ nhớ của engine. Engine crash, cache mất. Engine restart, cache mất. Chạy nhiều instance song song, mỗi instance giữ cache riêng, không ai dùng chung được. Với hệ thống production chạy hàng triệu request mỗi ngày, đây là lãng phí khổng lồ.
 Ba Vấn Đề LMCache Giải Quyết
Vấn đề 1: Cache mất sau mỗi lần restart. Engine vLLM hoặc bất kỳ serving engine nào đều giữ KV cache trong VRAM. Khi process chết, toàn bộ cache bốc hơi. LMCache chạy như một daemon độc lập, tách biệt hoàn toàn khỏi inference engine. Cache tồn tại ngay cả khi engine crash, khởi động lại hay cập nhật phiên bản.
Vấn đề 2: Không share được giữa nhiều instance. Khi bạn scale out với 4 GPU node chạy song song, mỗi node tự build cache riêng. Node A cache xong một prompt dài, Node B vẫn phải tính lại cái đó từ đầu. LMCache cho phép phân tán KV cache qua GPU memory, CPU RAM, local disk, Redis hoặc S3, tất cả instance đều truy cập được cùng một pool cache.
Vấn đề 3: Prefix caching quá giới hạn. Các engine hiện tại chỉ cache được phần đầu của prompt (prefix caching). Nếu context dài và phần giống nhau nằm ở giữa hoặc cuối prompt, cache vô dụng. LMCache mở rộng thành token-level reuse, tái sử dụng KV block ở bất kỳ vị trí nào trong prompt, không chỉ phần mở đầu.
 Con Số Thực Tế
LMCache đo được hai chỉ số quan trọng nhất trong LLM serving:
TTFT (Time-to-First-Token) giảm đáng kể nhờ không phải recompute phần context đã cache. Với agentic workflow có system prompt dài vài nghìn token, lợi ích này rõ rệt ngay từ request đầu tiên.
Throughput tăng vì GPU không lãng phí cycle tính lại những gì đã biết. Tài nguyên dành cho token mới thay vì recompute token cũ.
Ba use case hưởng lợi nhiều nhất là agentic context dài, RAG, và multi-turn conversation.
 Kiến Trúc Và Tích Hợp
LMCache thiết kế theo hướng vendor-neutral: hoạt động với vLLM và các serving engine phổ biến khác. Hardware hỗ trợ gồm NVIDIA, AMD và Arm, phủ gần hết các setup production thực tế.
Tầng lưu trữ linh hoạt theo nhu cầu và budget: GPU VRAM cho tốc độ tối đa, CPU RAM cho dung lượng lớn hơn, local disk cho persistence rẻ, Redis cho distributed cache có TTL, S3 cho lưu trữ dài hạn giá thấp.
Monitoring được tích hợp sẵn với metrics đầy đủ, không cần tự build dashboard từ đầu.
 Tại Sao Đáng Để Thử
Dự án có 9.466 sao trên GitHub dưới repo LMCache/LMCache, được Tensormesh hậu thuẫn.
Nếu bạn đang chạy LLM inference ở production, đặc biệt với context dài hoặc workload lặp lại nhiều, LMCache giải quyết đúng điểm đau mà các serving engine hiện tại bỏ ngỏ. Chi phí tích hợp thấp, lợi ích đo được ngay.
Bạn đang dùng vLLM hay serving engine nào để chạy LLM production? Cache management có phải vấn đề bạn đang đau đầu không?
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
 GStack: Biến Claude Code Thành Cả Đội Kỹ Thuật AI Với 23 Kỹ Năng

 Kho Tài Liệu AI 26k Sao Giúp Bạn Học Từ Zero Đến Ship Sản Phẩm