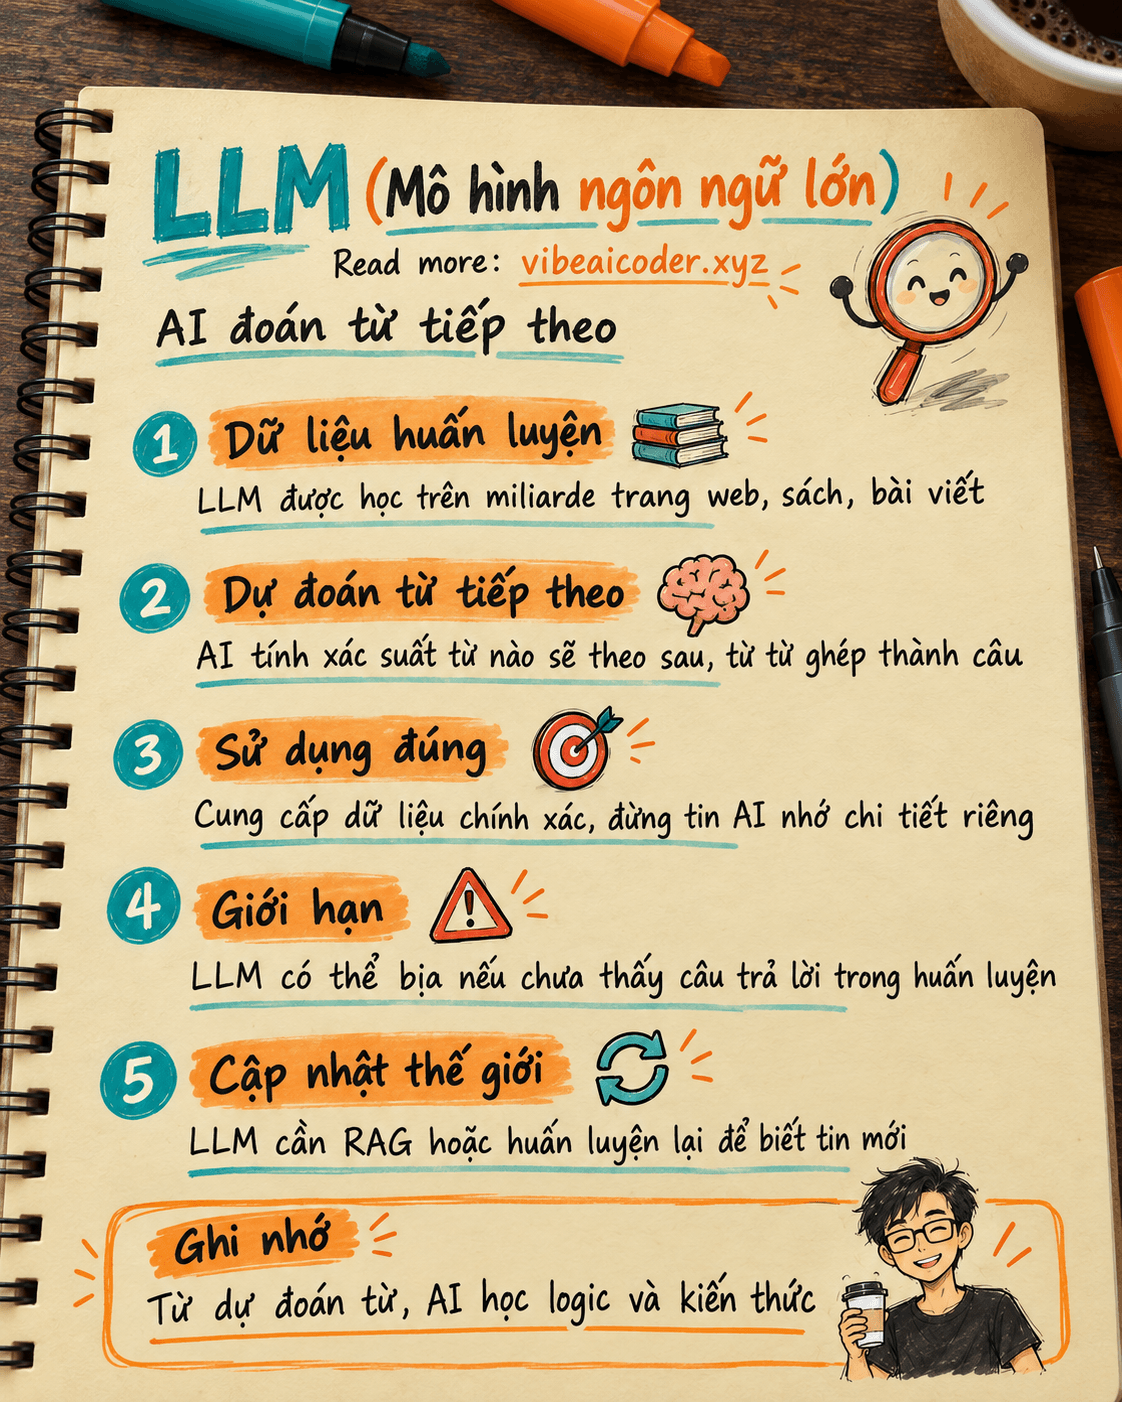
 LLM (Mô hình ngôn ngữ lớn) là gì? Tại sao AI "đoán chữ tiếp theo" lại thông minh thế
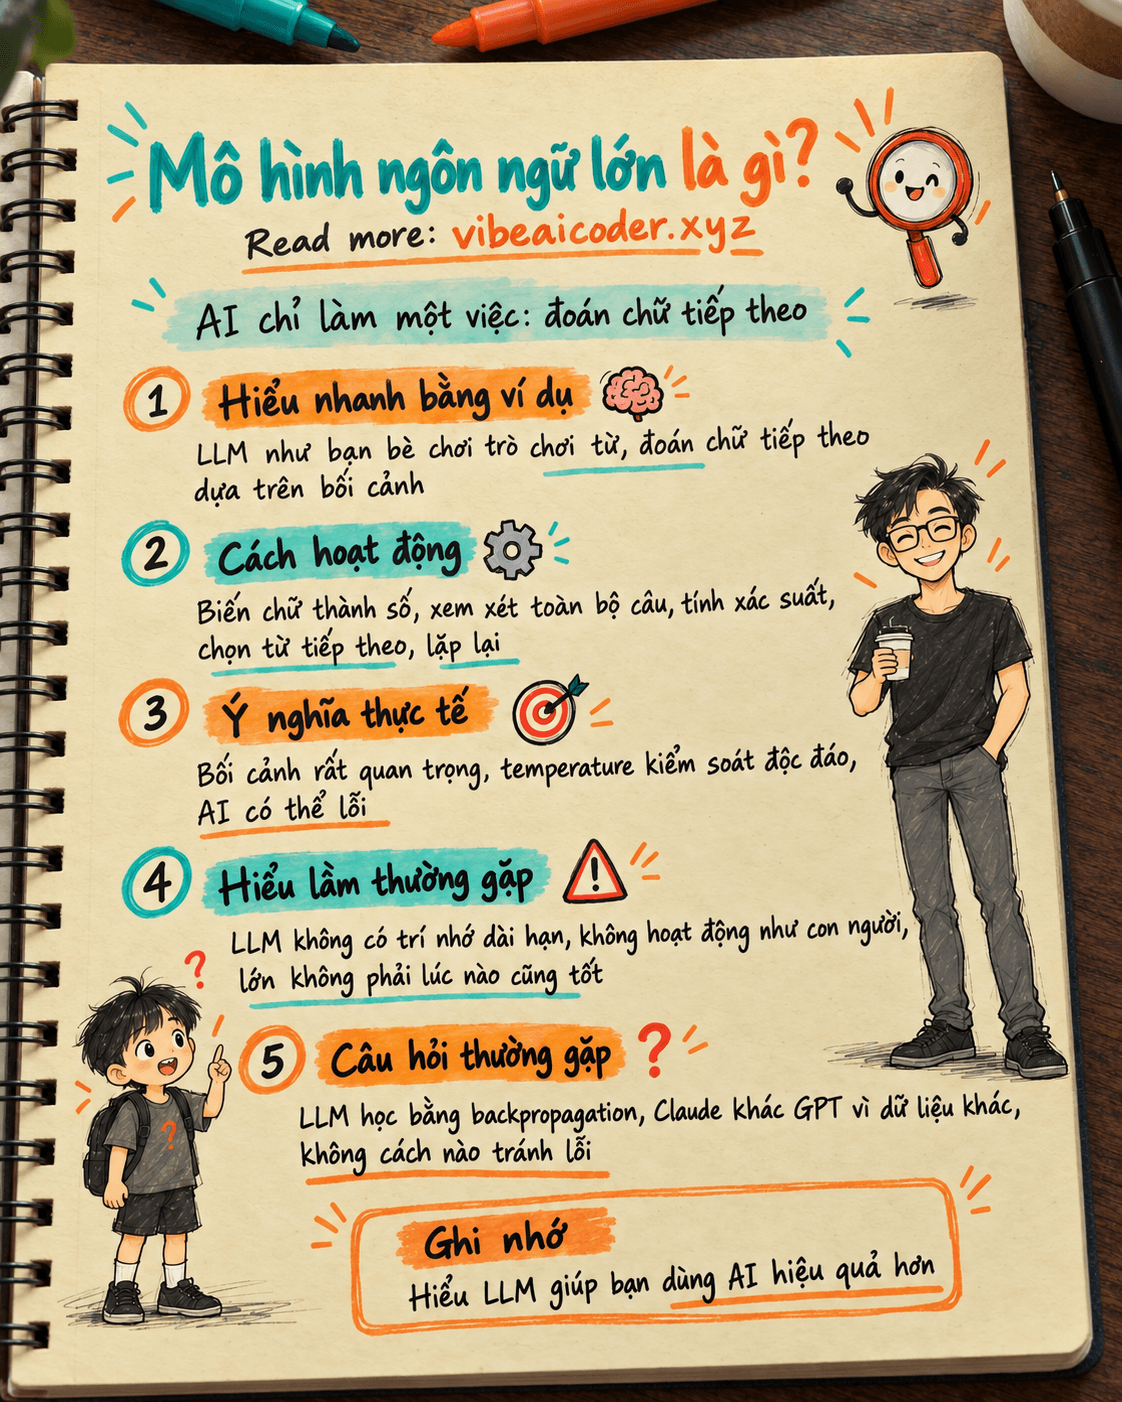
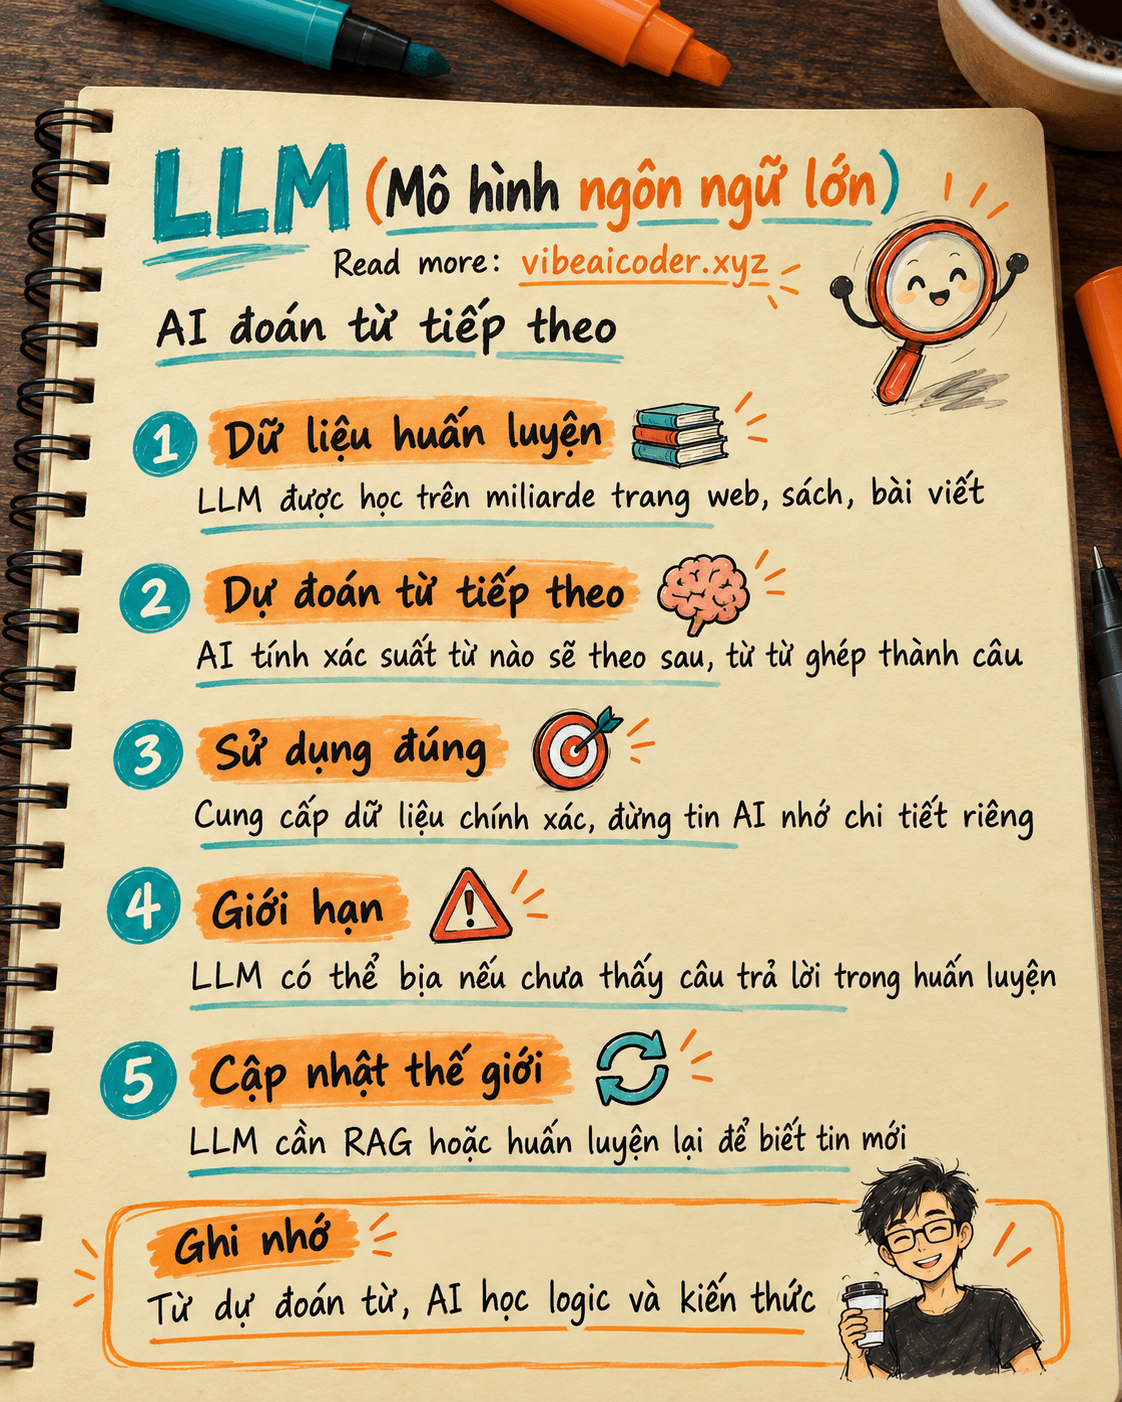
LLM là viết tắt của "Large Language Model", một chương trình AI được huấn luyện trên miliarde từ văn bản để dự đoán từ hoặc từ cụm tiếp theo. Mỗi khi bạn nhắn tin với ChatGPT hay Claude, thực chất AI đang "đoán" từng ký tự tiếp theo, từ từ ghép thành câu, rồi thành bài viết hoàn chỉnh. Từ việc đoán từ liên tiếp, AI học được logic, kiến thức, thậm chí cả cách suy luận của con người.
Hiểu nhanh bằng ví dụ đời thường
Hình dung bạn vừa đọc hàng ngàn cuốn sách rồi ai hỏi bạn một câu hỏi. Bạn không cần "nhớ" câu trả lời từng từ. Bạn biết từ nào sẽ theo sau từ khác vì đã thấy hàng triệu lần trong sách. Nếu ai hỏi "Thủ đô của Pháp là?", bạn tự động biết từ "Paris" sẽ theo sau vì bạn đã đọc nó rất nhiều lần. Bạn không lý giải từng bước, chỉ "cảm nhận" nó là tự nhiên.
LLM cũng vậy. Nó đã "đọc" miliarde trang web, sách, bài viết trên internet. Từ đó, nó học được những từ nào thường đi cùng nhau, câu nào có ý nghĩa đúng trong hoàn cảnh này. Khi bạn hỏi "Tiền tệ của Nhật là?", LLM không "nhớ" mà "biết" từ "yên" sẽ theo sau vì đã thấy nó xuất hiện sau câu hỏi tương tự hàng triệu lần.
 Nó hoạt động thế nào
LLM hoạt động qua ba bước:
1. Huấn luyện (Training): Các kỹ sư công nghệ đổ hàng tỷ trang văn bản vào chương trình AI. AI học từ cặp từ cạnh nhau: từ "Chào" nó học "mình" hay "bạn" thường theo sau; từ "Đã" nó học động từ thường theo. Sau hàng tuần chạy trên siêu máy tính, AI có thể "dự đoán" từ tiếp theo với độ chính xác cao.
2. Dự đoán (Prediction): Khi bạn nhắn "Giải thích cho tôi", AI tìm xem trong dữ liệu huấn luyện, sau cụm "Giải thích cho tôi" thường theo gì. Nó chọn một từ tiếp theo (thường là từ có xác suất cao nhất, ví dụ "làm thế nào", "điều gì", v.v.) và viết ra. Rồi nó lặp lại: dùng toàn bộ câu đã viết để dự đoán từ tiếp theo.
3. Dừng khi xong: AI tiếp tục "đoán" từ tiếp theo cho tới khi nó cảm thấy câu trả lời đủ hoặc bạn bảo dừng.
Quy trình này xảy ra rất nhanh. Bạn nhìn thấy đoạn văn hiện ra từng từ trong vài giây.
 Điều này có ý nghĩa gì với bạn
Hiểu rằng LLM chỉ "đoán từ tiếp theo" giúp bạn:
Biết khi nào ai không thể làm được việc mà bạn muốn: Nếu công việc cần phải ghi nhớ chi tiết chính xác (ví dụ: số điện thoại khách hàng cụ thể, hay giá hàng của tháng trước), AI không thể vì LLM chỉ "đoán" từ hợp lý nhất, không "nhớ" dữ liệu cụ thể. Bạn cần cung cấp dữ liệu đó cho AI.
Ghi hoa hồng cách dùng AI tốt hơn: Khi bạn viết prompt, bạn đang dạy AI "sau cụm này, từ loại này thường theo". Ví dụ: "Viết cho tôi email chuyên nghiệp về hóa đơn chưa thanh toán:" - bạn đã gợi ý cho AI biết từ tiếp theo sẽ là "Kính gửi", "Anh/chị", hoặc những từ văn phòng, chứ không phải "haha" hay "đại loại".
Hiểu tại sao AI đôi khi "bịa" thông tin: Nếu LLM chưa bao giờ thấy câu trả lời chính xác trong dữ liệu huấn luyện, nó sẽ "đoán" một từ hợp lý nhất, nhưng có thể sai. Ví dụ, nếu bạn hỏi "Giám đốc của công ty XYZ là ai?", mà câu hỏi này không xuất hiện trong dữ liệu huấn luyện, AI sẽ đoán một cái tên "hợp lý" nhưng có thể hoàn toàn sai.
 Hiểu lầm thường gặp
Lầm: "AI đang nghĩ như người." Sự thật: AI không "nghĩ". Nó chỉ tính toán xác suất của từ tiếp theo dựa trên những gì nó đã "thấy" trong huấn luyện. Nó không có ý tưởng riêng, chỉ là ghép những mẫu nó học được.
Lầm: "AI nhớ những gì tôi hỏi lần trước." Sự thật: LLM không có trí nhớ dài hạn ngoài phạm vi của một cuộc trò chuyện. Mỗi lần bạn mở chat mới, AI quên hết những gì bạn hỏi trước, trừ khi bạn ghi lại trong chat hiện tại. Claude hay ChatGPT có "memory" nhưng đó là tính năng thêm vào, không phải LLM ban đầu.
Lầm: "LLM lớn hơn = thông minh hơn." Sự thật: Kích thước chỉ một phần. LLM lớn hơn (nhiều tham số hơn) thường tốt hơn, nhưng chất lượng dữ liệu huấn luyện và cách huấn luyện còn quan trọng hơn. Một LLM "nhỏ" được huấn luyện tốt có thể vượt trội một LLM "lớn" nhưng kém chất.
 Câu hỏi thường gặp
Tại sao LLM lại được gọi là "mô hình ngôn ngữ lớn"? "Ngôn ngữ" vì nó làm việc với text (ngôn ngữ con người). "Lớn" vì nó chứa hàng tỷ đến hàng chục tỷ bộ tham số (những con số AI sử dụng để quyết định từ tiếp theo). Con số này tăng qua từng năm.
LLM khác gì với chatbot? LLM là chương trình cơ bản, chỉ biết "đoán từ tiếp theo". Chatbot là ứng dụng xây dựng trên LLM, có thêm tính năng như nhớ, tìm kiếm web, hoặc gọi công cụ khác. ChatGPT là chatbot sử dụng GPT (một LLM). Claude là chatbot sử dụng Claude (một LLM khác).
Huấn luyện LLM tốn bao nhiêu tiền? Huấn luyện một LLM lớn từ đầu tốn 10-100 triệu USD tùy kích thước, tháng năm, và máy tính. Đó là lý do chỉ các công ty lớn như OpenAI, Google, Anthropic mới huấn luyện LLM từ đầu. Hầu hết các công ty khác "điều chỉnh" (fine-tune) một LLM hiện có thay vì huấn luyện từ đầu.
Sau bao lâu LLM phải "học" lại vì dữ liệu thế giới thay đổi? LLM hiện nay thường được huấn luyện một lần rồi "dừng". Chúng không tự động cập nhật. Nếu bạn hỏi ai là Tổng thống Mỹ năm nay, LLM được huấn luyện năm 2022 sẽ trả lời sai. Để cập nhật, công ty phải:
- Huấn luyện lại từ đầu (tốn tiền, mất thời gian)
- Hoặc dùng "RAG" (Retrieval-Augmented Generation): AI vừa sử dụng LLM vừa tìm kiếm dữ liệu mới từ web trước khi trả lời
Tôi có thể huấn luyện LLM riêng không? Có, nhưng khó. Bạn cần:
- Hàng tỷ từ dữ liệu (hoặc ít nhất hàng triệu)
- Siêu máy tính chuyên dụng (GPU, TPU)
- Kiến thức sâu về machine learning
- Tiền (hàng triệu USD)
Đó là lý do hầu hết mọi người chỉ "fine-tune" (điều chỉnh) LLM có sẵn để dạy nó về dữ liệu riêng của họ.
#LLM #ModelNgônNgữLớn #AILàGì #CóBảoAI #LearnWithAI
Internal links
Bài này liên quan đến các chủ đề cơ bản:
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ