LLM (Large Language Model) là gì? Sao AI biết dự đoán chữ tiếp theo?
LLM (Large Language Model) là gì? Sao AI biết "dự đoán chữ tiếp theo"?
Bạn mở ChatGPT, gõ "Xin chào", và nó trả lời liền. Bạn tò mò: AI thực ra biết gì? Nó thật sự "nghĩ" không?
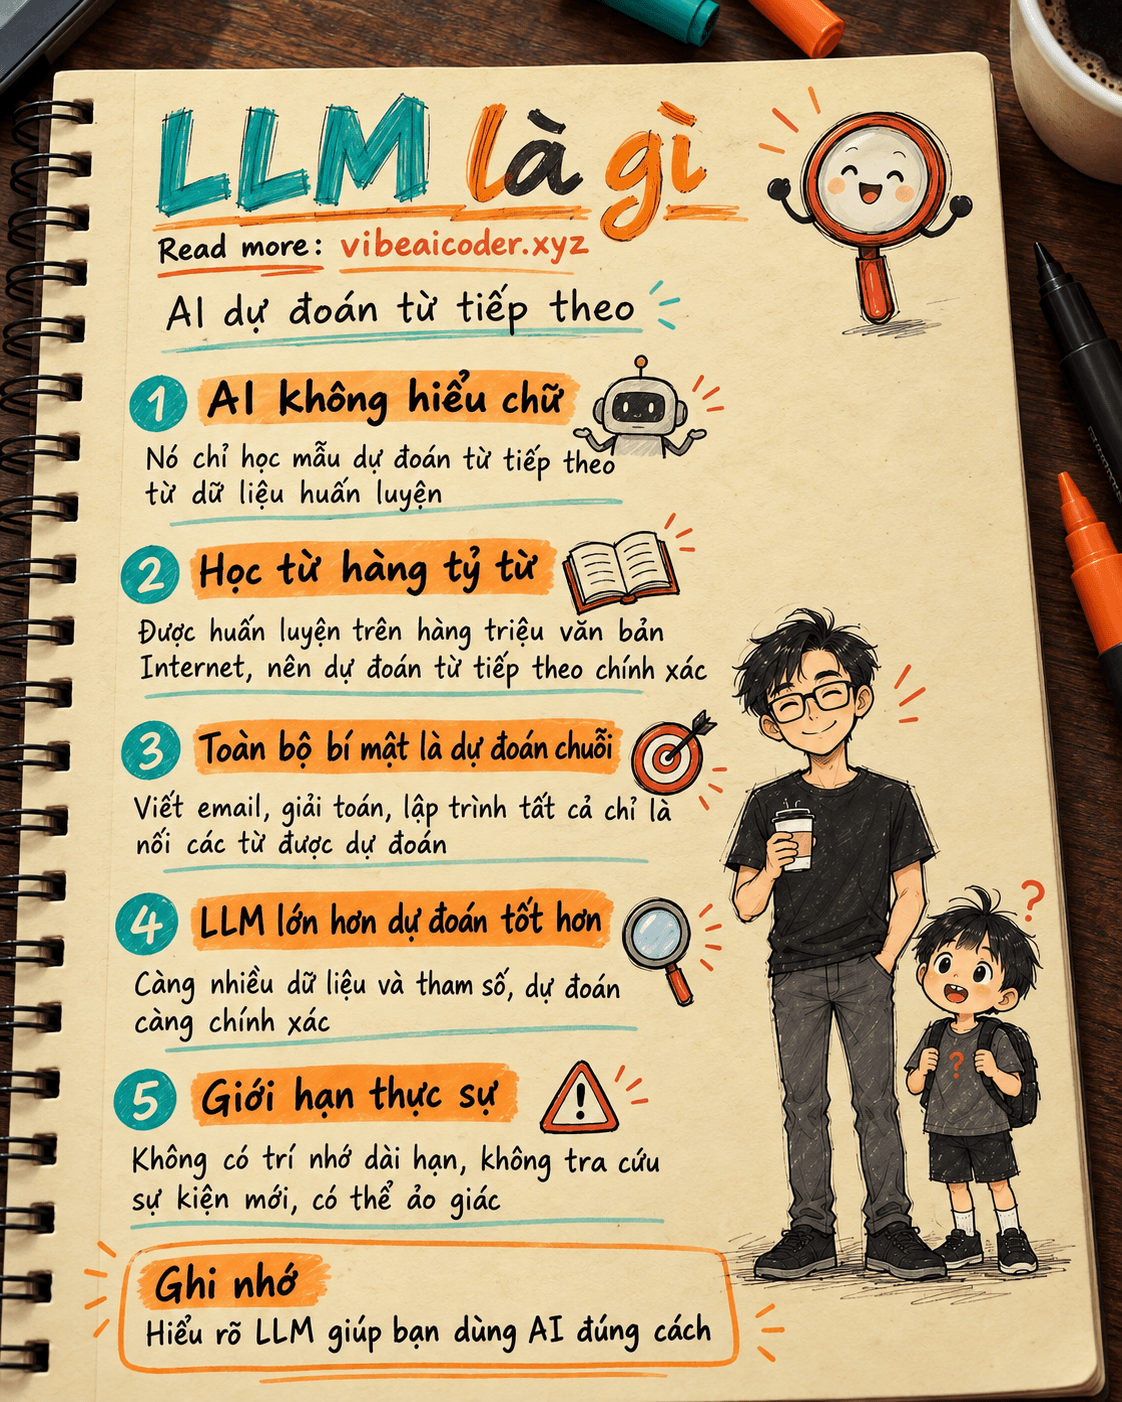
Câu trả lời ở một khái niệm đơn giản nhưng mạnh mẽ: LLM (Large Language Model) là những mô hình AI chỉ biết làm một việc duy nhất: dự đoán từ tiếp theo.
AI không "hiểu" chữ, nó "học" mẫu
Khi bạn gõ "Tiếng Việt là", ChatGPT không tra từ điển mà:
- Nhìn lại hàng triệu văn bản trên Internet mà nó đã "học"
- Tìm mẫu: "Tiếng Việt là" thường theo sau bởi "ngôn ngữ", "dễ học", "khó đối với người nước ngoài"...
- Chọn từ nào có khả năng cao nhất → trả lời "ngôn ngữ"
Sau đó, nó lại lặp lại: với "Tiếng Việt là ngôn ngữ", chữ tiếp theo có thể là "tuyệt đẹp" hoặc "khó"? Nó cứ tiếp tục cho đến khi dừng.
Đây là toàn bộ bí mật.
Tại sao nó hoạt động?
Bạn tìm mẫu từ những dữ liệu khổng lồ:
- 1 cộng 1 bằng → 2 (từ tất cả bài toán trên mạng)
- "Tôi cần viết email cho sếp" → bạn dự đoán phần tiếp sẽ nói về lịch họp, bản báo cáo...
- Câu hỏi logic → câu trả lời logic
LLM cũng vậy. Nó nhìn thấy hàng tỷ ví dụ từ con người, nên có thể dự đoán từ tiếp theo một cách chính xác.
"Từ tiếp theo" = tất cả những gì AI làm?
Đúng. Nhưng hãy xem điều gì xảy ra khi bạn nối các từ đó lại:
- Viết email: dự đoán từ tiếp theo → tiếp theo → ... → xong một email chuyên nghiệp
- Giải toán: dự đoán từ "2" sau "1 + 1 =", rồi giải thích các bước
- Lập trình: dự đoán từ mã tiếp theo, viết hàm hoàn chỉnh
- Trả lời câu hỏi phức tạp: dự đoán chuỗi từ, tạo thành câu trả lời logic
Không phải AI thông minh, mà là nó có thể dự đoán từ tiếp theo tốt. Thực ra, thông minh chỉ là khả năng dự đoán từ tiếp theo khi dữ liệu đủ lớn.
Tại sao LLM lớn (Large) lại tốt hơn?
Càng nhiều dữ liệu, càng nhiều mẫu → dự đoán càng chính xác.
- ChatGPT 3.5: đã "học" từ vài trăm tỉ từ, model có hàng tỉ tham số (weights) lưu lại mẫu đó
- Claude 3 Opus: học nhiều hơn, model lớn hơn → dự đoán chính xác hơn, sâu sắc hơn
Điều này giống như:
- Bạn đọc 5 cuốn sách → trả lời câu hỏi có thể sai
- Bạn đọc 5.000 cuốn sách → câu trả lời chính xác, có luận cứ
Giới hạn của "dự đoán từ tiếp theo"
LLM tốt nhưng không hoàn hảo:
- Nó không có "trí nhớ dài hạn" ngoài những gì bạn đặt trong câu hỏi (context)
- Nó không tra cứu sự kiện mới vì được huấn luyện tới một ngày nhất định
- Nó có thể "ảo giác" (hallucinate): dự đoán một từ chính xác về mặt ngữ pháp nhưng sai nội dung
- Nó không suy luận mà chỉ "ôm dồm" từ các mẫu
Ví dụ: bạn hỏi "AI có hơn 200 tỷ tham số có thông minh gấp 2 lần AI có 100 tỷ tham số không?" → LLM không tính toán; nó dự đoán từ tiếp theo từ "các bài viết về so sánh AI" và có thể trả lời "không nhất thiết vì phụ thuộc vào dữ liệu huấn luyện".
Tại sao bạn cần biết điều này?
- Hiểu giới hạn: AI không phải công thức siêu phàm, nó là "cái máy đoán từ tiếp theo" thông minh
- Dùng AI đúng cách: biết khi nào tin, khi nào kiểm tra (nó có thể lừa bạn nếu từ "tiếp theo" được dự đoán sai)
- Không sợ AI: khi bạn hiểu nó chỉ làm một việc, bạn không sợ nó "sẽ thay thế công việc bạn" mà sẽ tối ưu sử dụng
Kết luận
LLM là mô hình AI dự đoán từ tiếp theo dựa vào những mẫu bạn huấn luyện cho nó. Nó nhìn lại hàng tỷ từ, nhận ra cách con người nói chuyện, và "đoán" từ tiếp theo có thể sẽ nói gì.
Cách dùng: nếu bạn muốn AI trả lời chính xác, bạn cần:
- Câu hỏi rõ ràng (vì nó dự đoán dựa vào những gì bạn gõ)
- Kiểm tra câu trả lời (nó có thể dự đoán sai)
- Dùng kèm công cụ (search web, chạy code) để nó không chỉ dự đoán mà có "sự thật"
Lần sau khi dùng ChatGPT, hãy nhớ: bạn đang nói chuyện với một "cái máy ăn hàng tỷ từ từ Internet", chứ không phải một bộ não thật.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
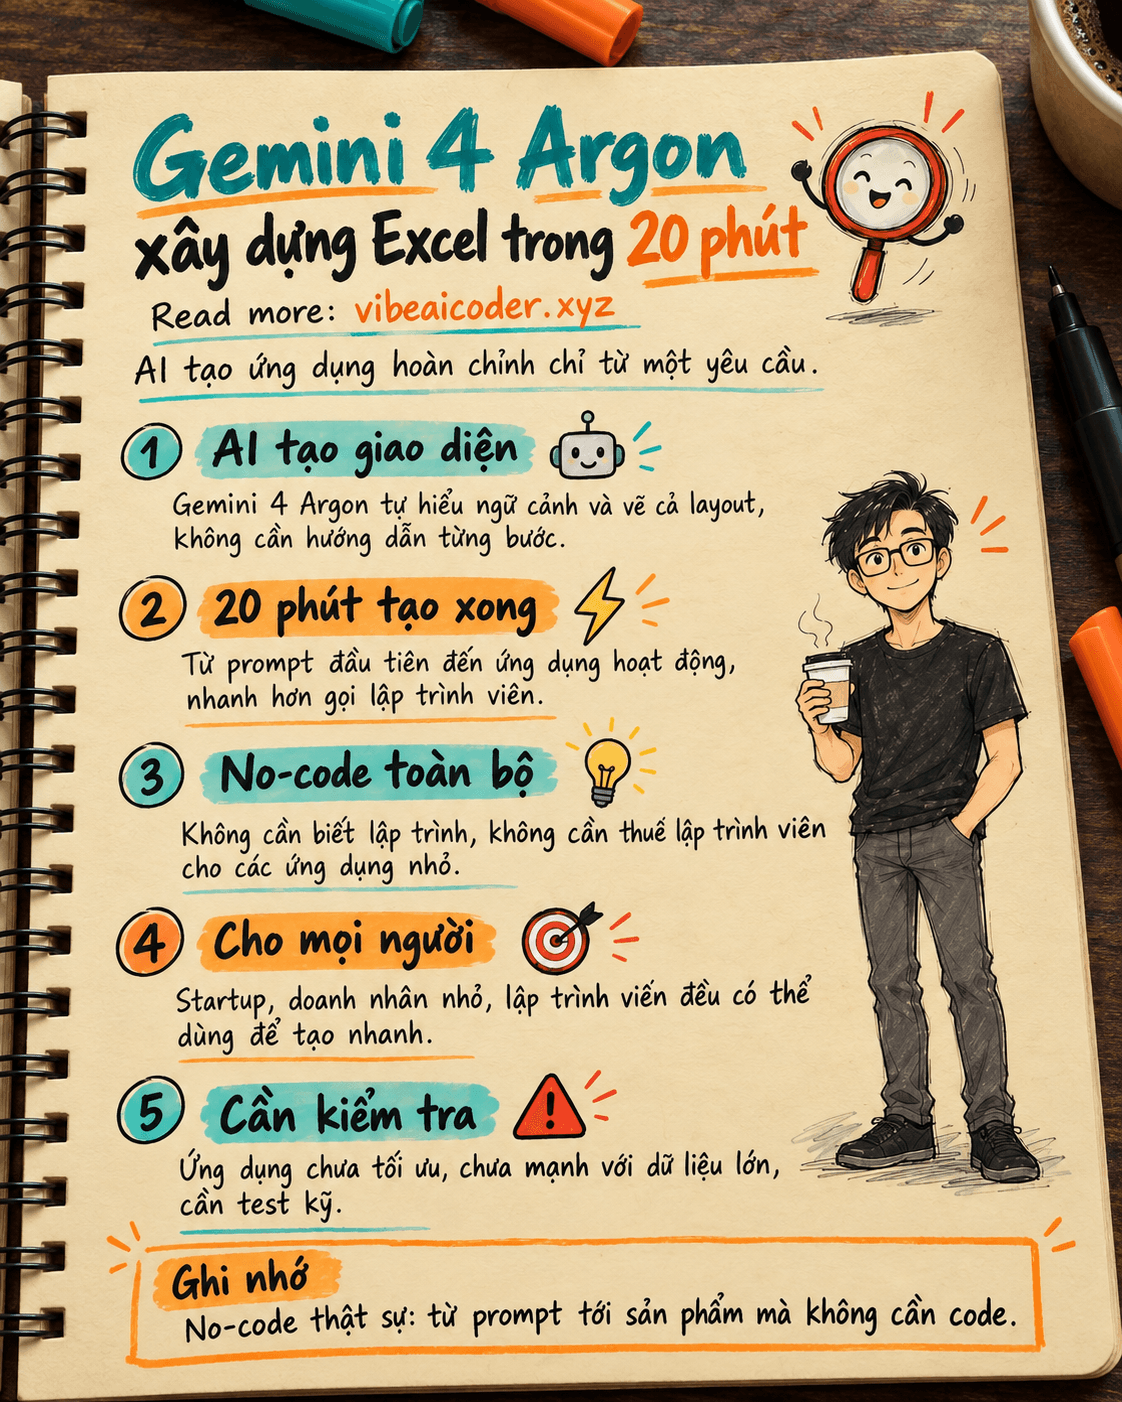
 Gemini 4 Argon vừa xây dựng ứng dụng Excel trong 20 phút
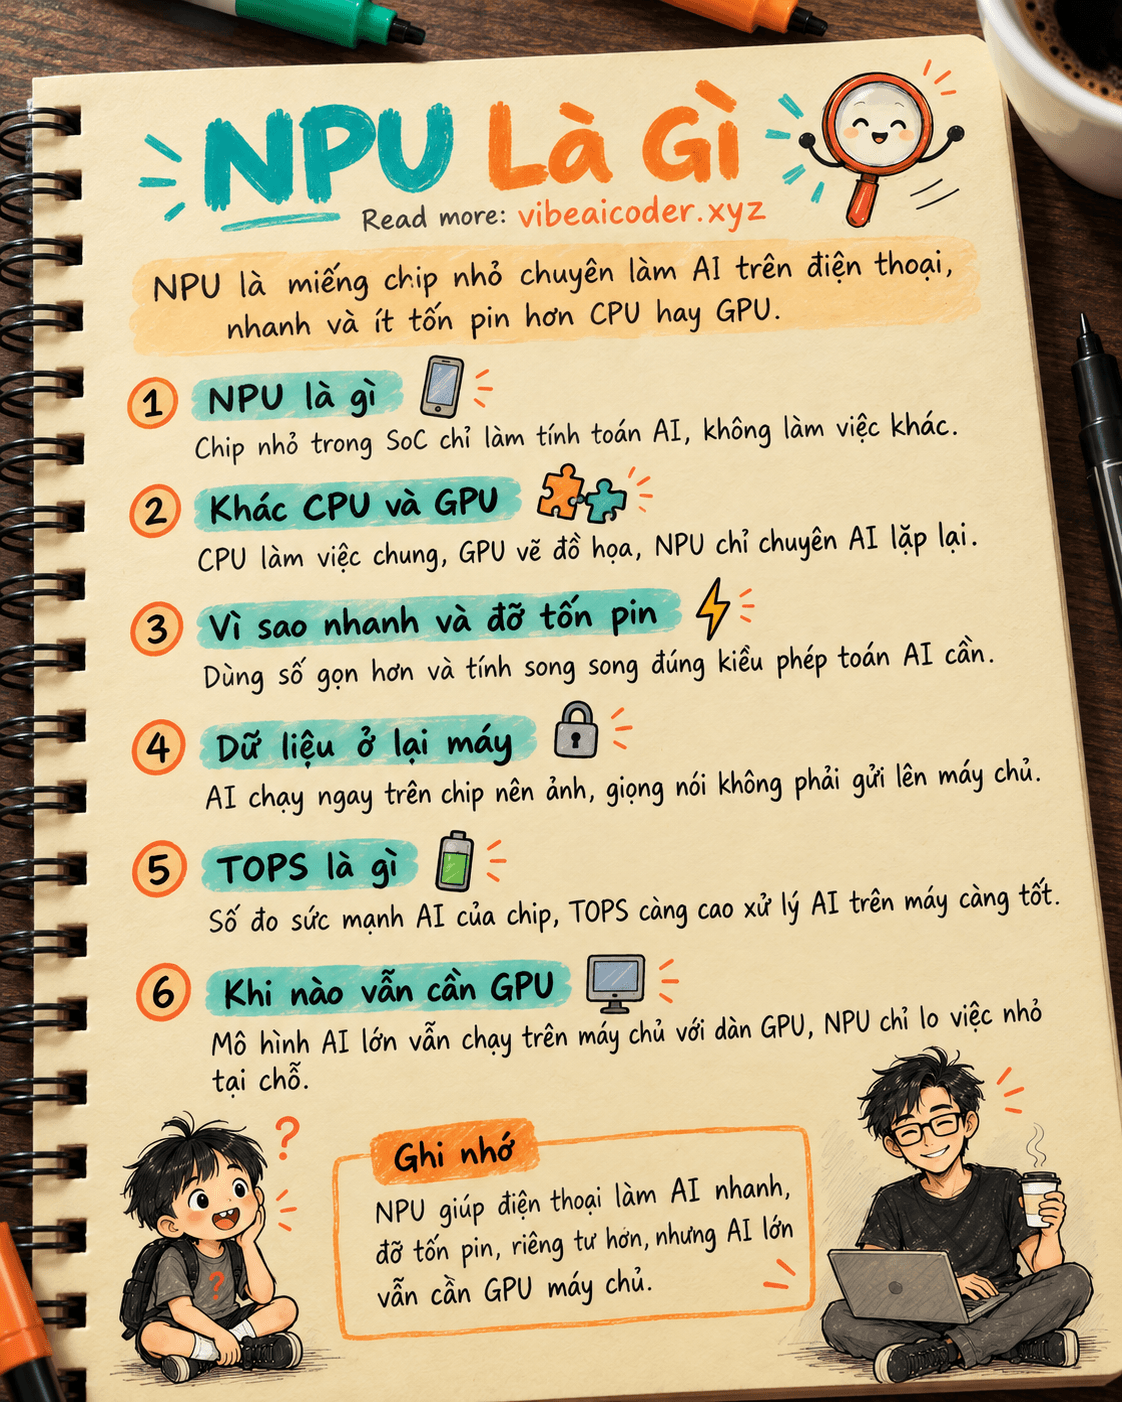
 NPU Là Gì? Vì Sao Điện Thoại Đời Mới Có Chip AI Riêng
 Dùng ChatGPT hoặc Claude biến bài viết blog thành bản tin email (newsletter) trong 15 phút