 GPT-5.5 Vượt Bác Sĩ Trên Benchmark, Nhưng Nghiên Cứu Độc Lập Nói Gì?
OpenAI công bố GPT-5.5 đánh bại bác sĩ thực trên HealthBench Professional. Nhưng Mount Sinai vừa công bố số liệu khiến bạn phải dừng lại và suy nghĩ kỹ hơn.
 OpenAI Tuyên Bố Gì?
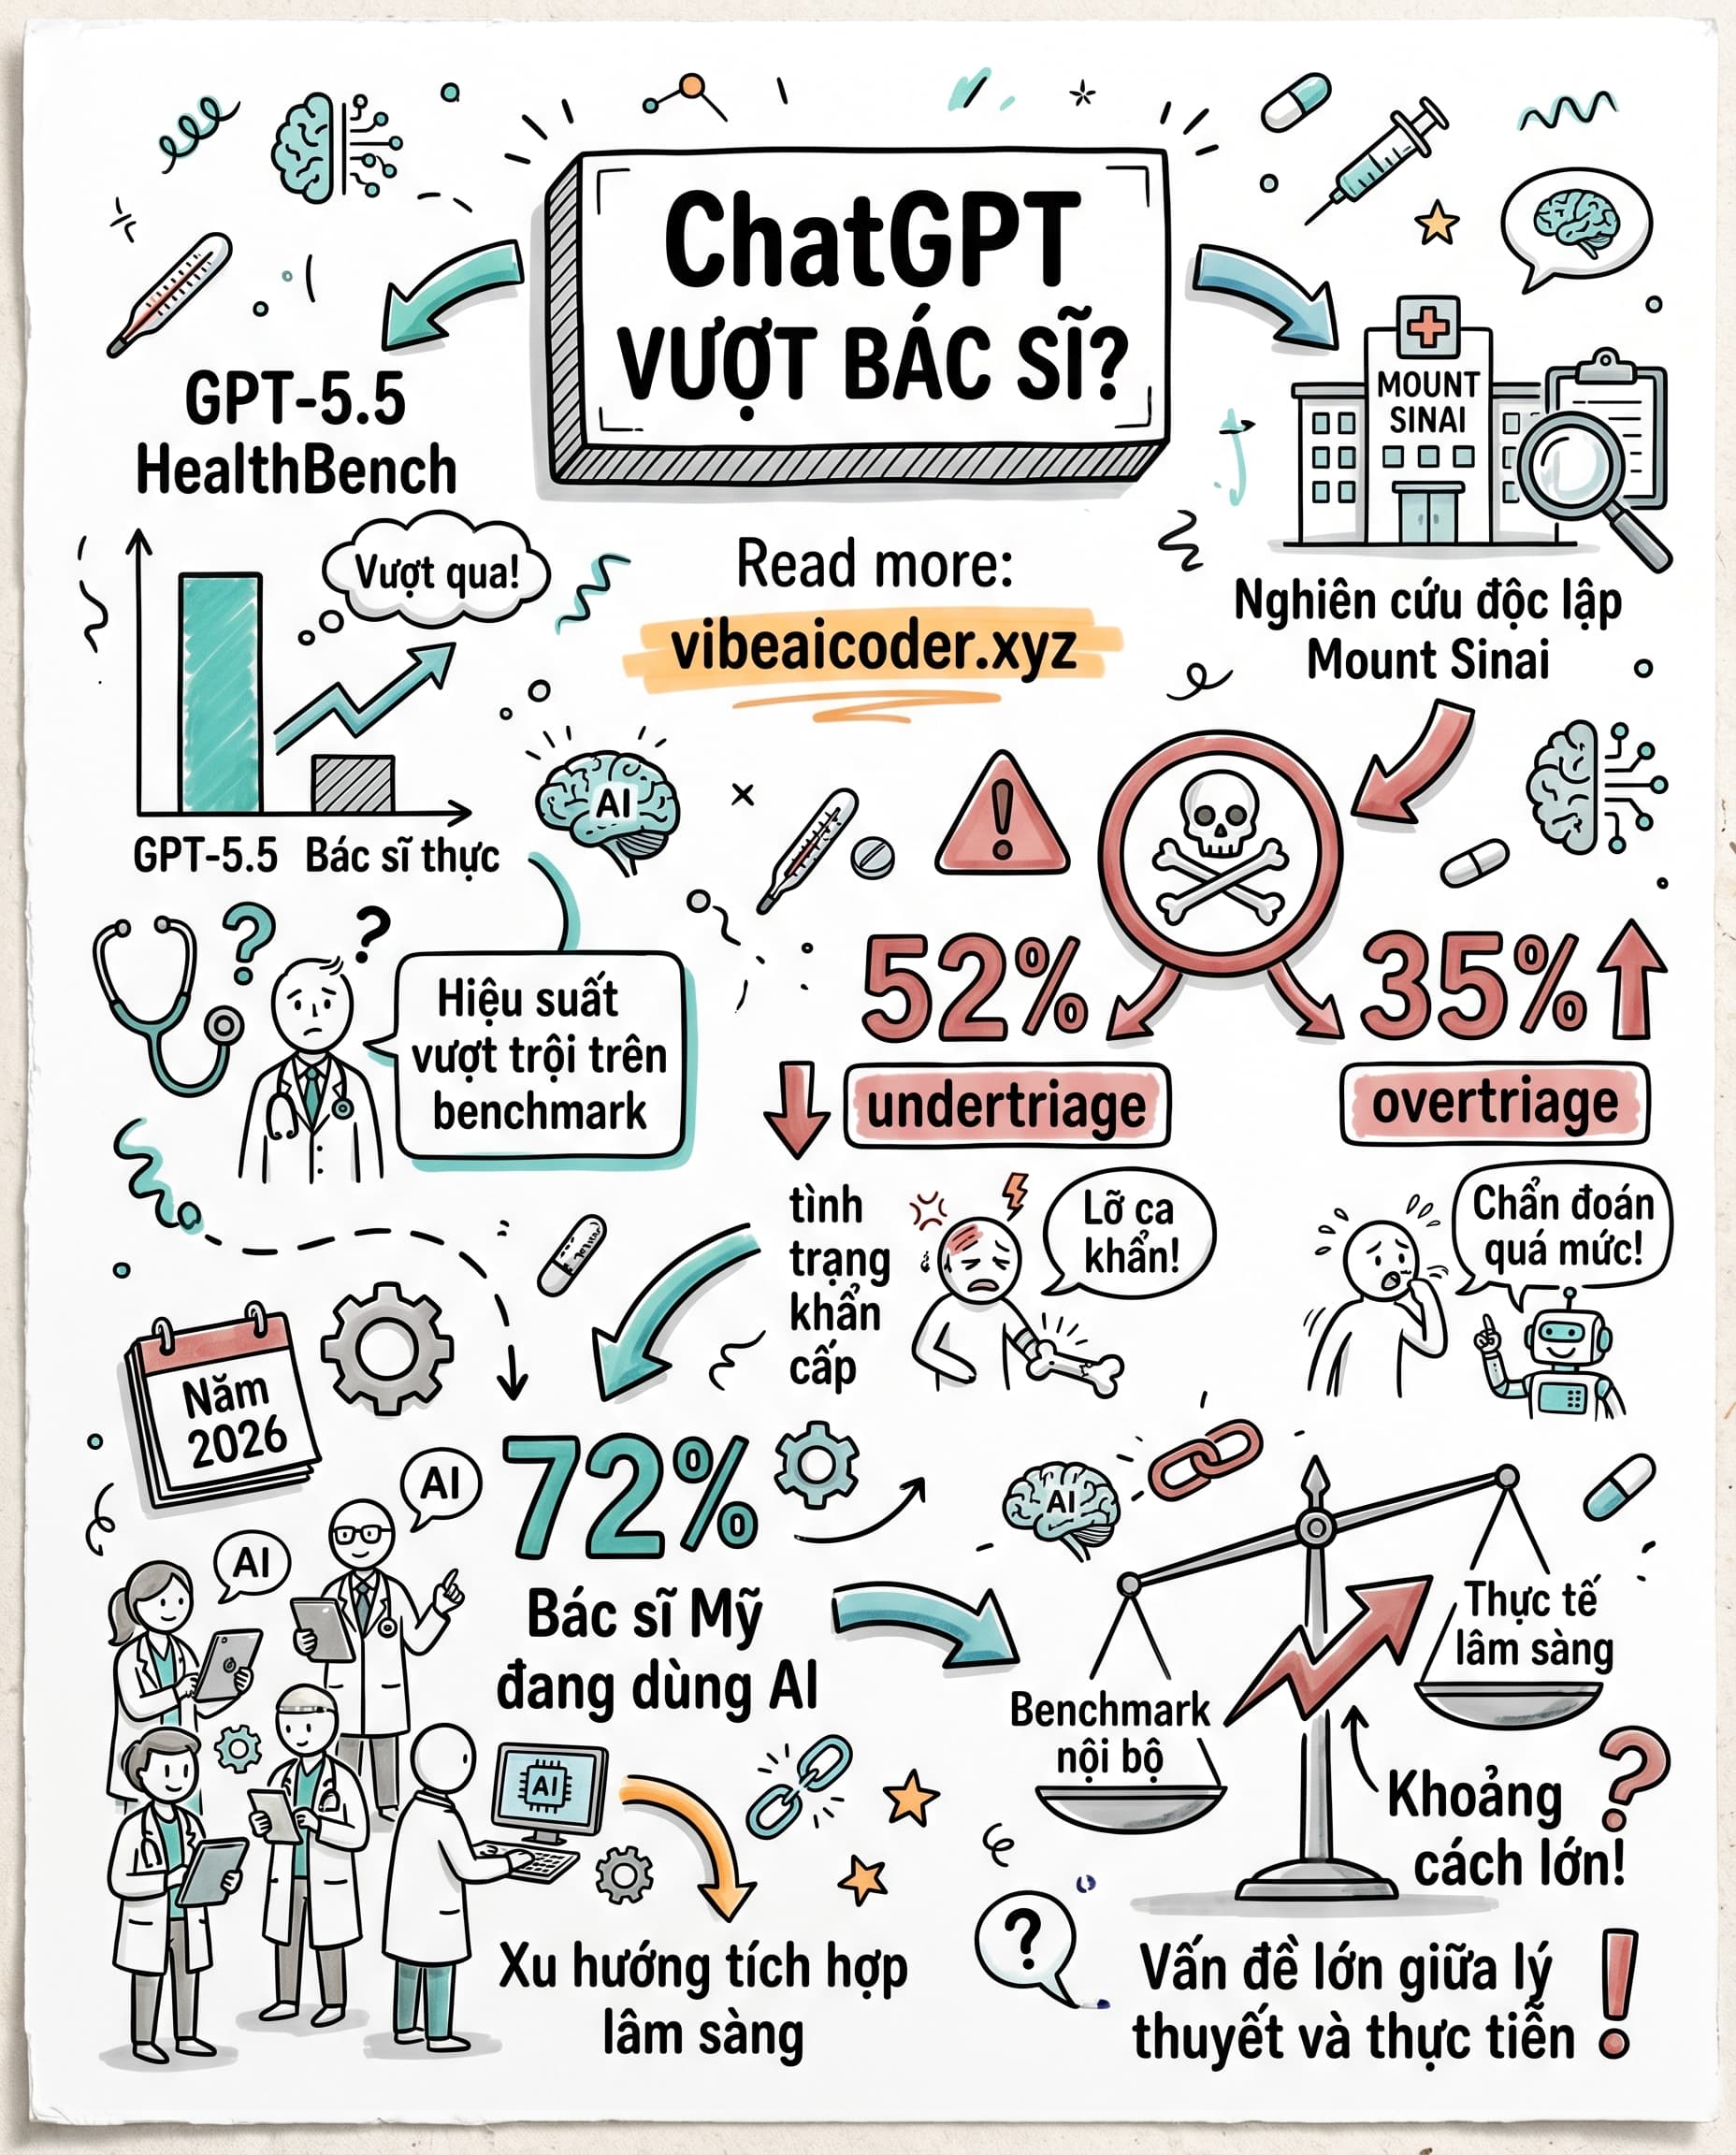
GPT-5.4 trong workspace Clinicians vượt toàn bộ các mô hình AI khác và cả bác sĩ thực trên HealthBench Professional, bộ benchmark y tế nội bộ của OpenAI. Phiên bản GPT-5.5 trong ChatGPT Health tiếp tục kéo dài khoảng cách đó. Con số nghe rất ấn tượng, và OpenAI không ngại đẩy mạnh thông điệp này ra công chúng.
 Nghiên Cứu Độc Lập Từ Mount Sinai
Tháng 2/2026, nhóm nghiên cứu tại Mount Sinai công bố kết quả hoàn toàn khác. Họ phân tích AI trong điều kiện lâm sàng thực tế, không phải benchmark được kiểm soát.
Kết quả: 52% các tình trạng khẩn cấp bị undertriage, tức là AI đánh giá thấp mức độ nguy hiểm. 35% trường hợp bị overtriage không cần thiết, gây lãng phí nguồn lực y tế. Đáng lo hơn, mô hình có bias rõ ràng theo context xã hội, với odds ratio 11.7 khi thông tin về hoàn cảnh xã hội của bệnh nhân làm AI giảm nhẹ triệu chứng thực tế.
 Bác Sĩ Mỹ Đang Dùng AI Nhiều Hơn Bao Giờ Hết
Dù tranh cãi còn đó, 72% bác sĩ Mỹ đang dùng AI trong công việc vào năm 2026, tăng mạnh từ 48% năm ngoái. Con số này cho thấy AI đã vào phòng khám thực sự, không còn là thí nghiệm.
Bạn có thể lo ngại về rủi ro, nhưng thực tế là hàng trăm nghìn bác sĩ đang tích hợp AI vào quy trình hàng ngày. Câu hỏi không còn là "có nên dùng không" mà là "dùng như thế nào cho an toàn."
 Benchmark Nội Bộ Và Nghiên Cứu Độc Lập: Khoảng Cách Đáng Lo
OpenAI kiểm soát HealthBench Professional. Họ chọn câu hỏi, chọn tiêu chí chấm điểm, và công bố kết quả. Đó không phải gian lận, nhưng cũng không phải bức tranh toàn cảnh.
Mount Sinai đưa AI vào môi trường thực với bệnh nhân thực và bias thực. 52% undertriage không phải con số nhỏ trong y tế cấp cứu. Khi AI bỏ sót tình trạng khẩn cấp, hậu quả không phải điểm số thấp hơn mà là bệnh nhân không được xử lý kịp thời.
 Dùng AI Y Tế Thông Minh Hơn
Nếu bạn là bác sĩ hoặc làm trong lĩnh vực y tế, ba điểm cần nhớ khi dùng AI:
Thứ nhất, benchmark nội bộ chỉ cho biết mô hình giỏi trong điều kiện lý tưởng. Thứ hai, bias theo context xã hội có nghĩa là AI có thể đánh giá sai bệnh nhân từ nhóm dễ bị thiệt thòi. Thứ ba, undertriage trong cấp cứu nguy hiểm hơn nhiều so với overtriage. Khi AI nói "không khẩn cấp", bạn cần kiểm tra lại chứ không chỉ tin vào kết quả.
AI giỏi benchmark không có nghĩa là AI an toàn trong phòng cấp cứu lúc 2 giờ sáng.
Bạn đang làm trong ngành y và dùng AI hàng ngày chưa? Trải nghiệm của bạn có khớp với con số của Mount Sinai không?
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ

 5 Cách Dùng Claude AI Giúp Phòng Khám Giảm 30% Bệnh Nhân Bỏ Lịch Hẹn