 Fugu Ultra Vượt Claude Fable 5 Trên Benchmark Nhưng Chậm Hơn 30 Phút
Sakana AI vừa tung ra một hệ thống AI đánh bại Claude Fable 5 trên bảng xếp hạng. Nhưng Ethan Mollick dùng thử xong và nói thẳng: kết quả thực chiến thua xa.
 Fugu Ultra Là Gì
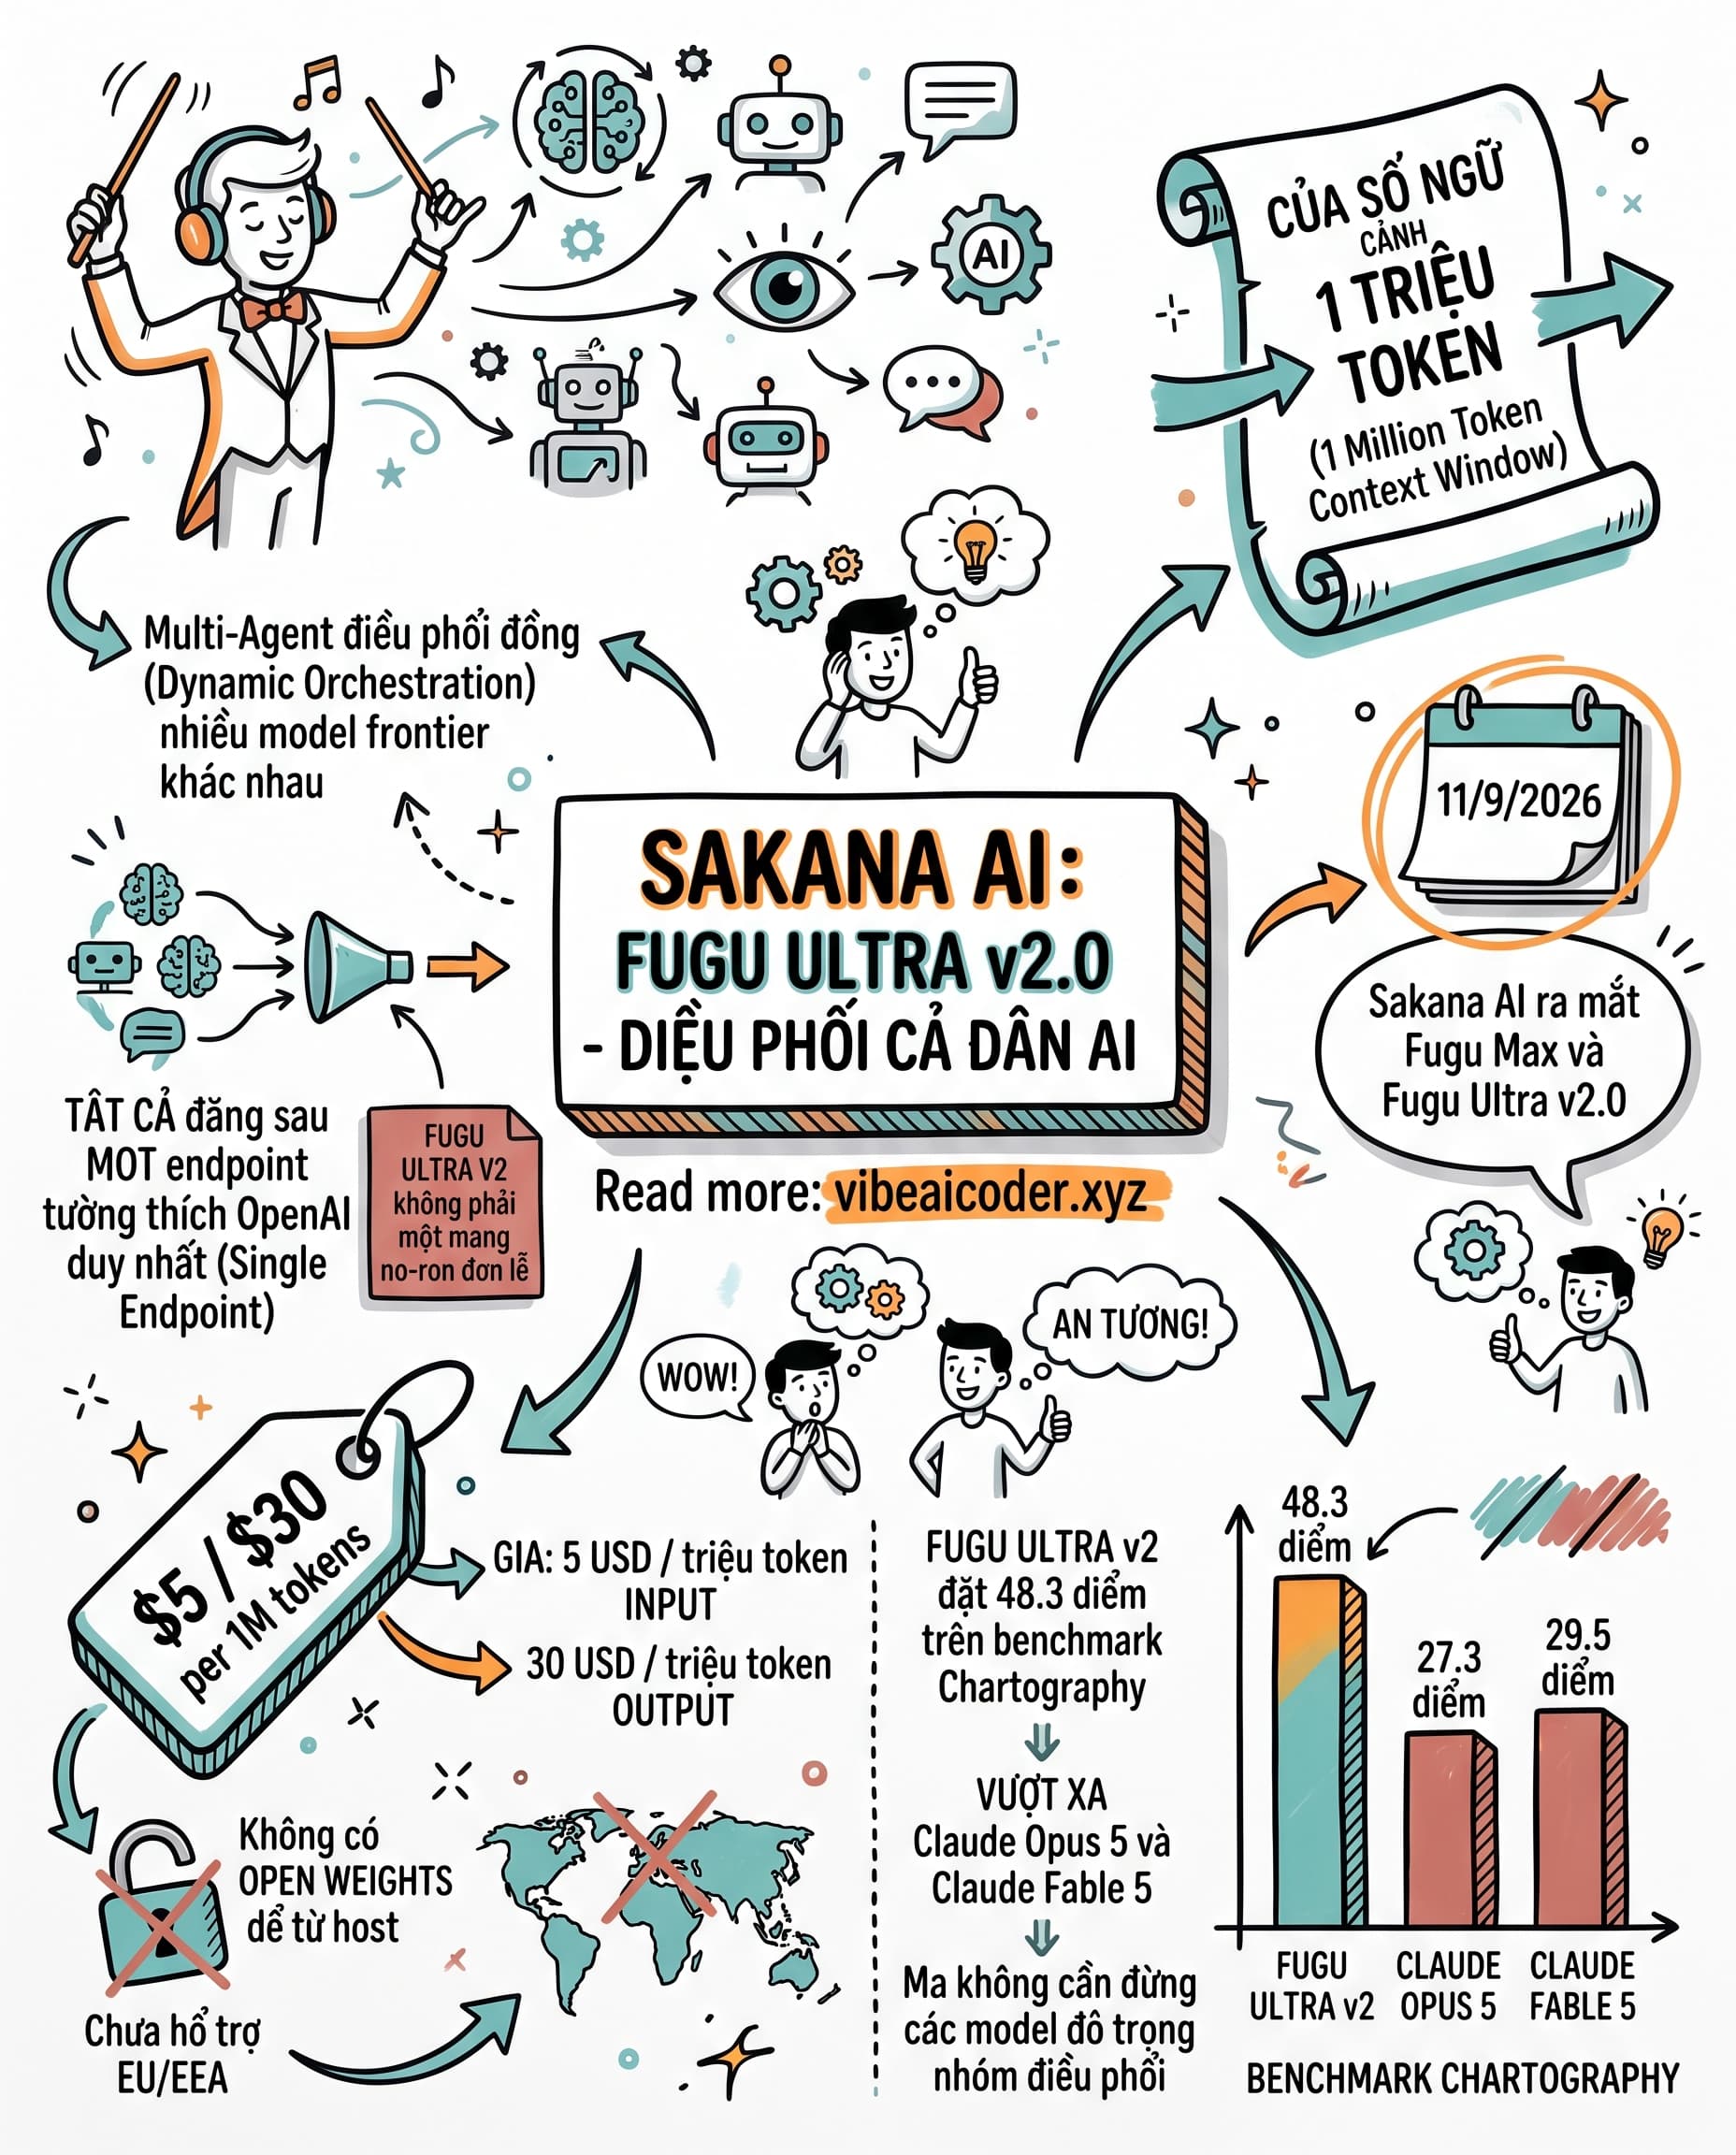
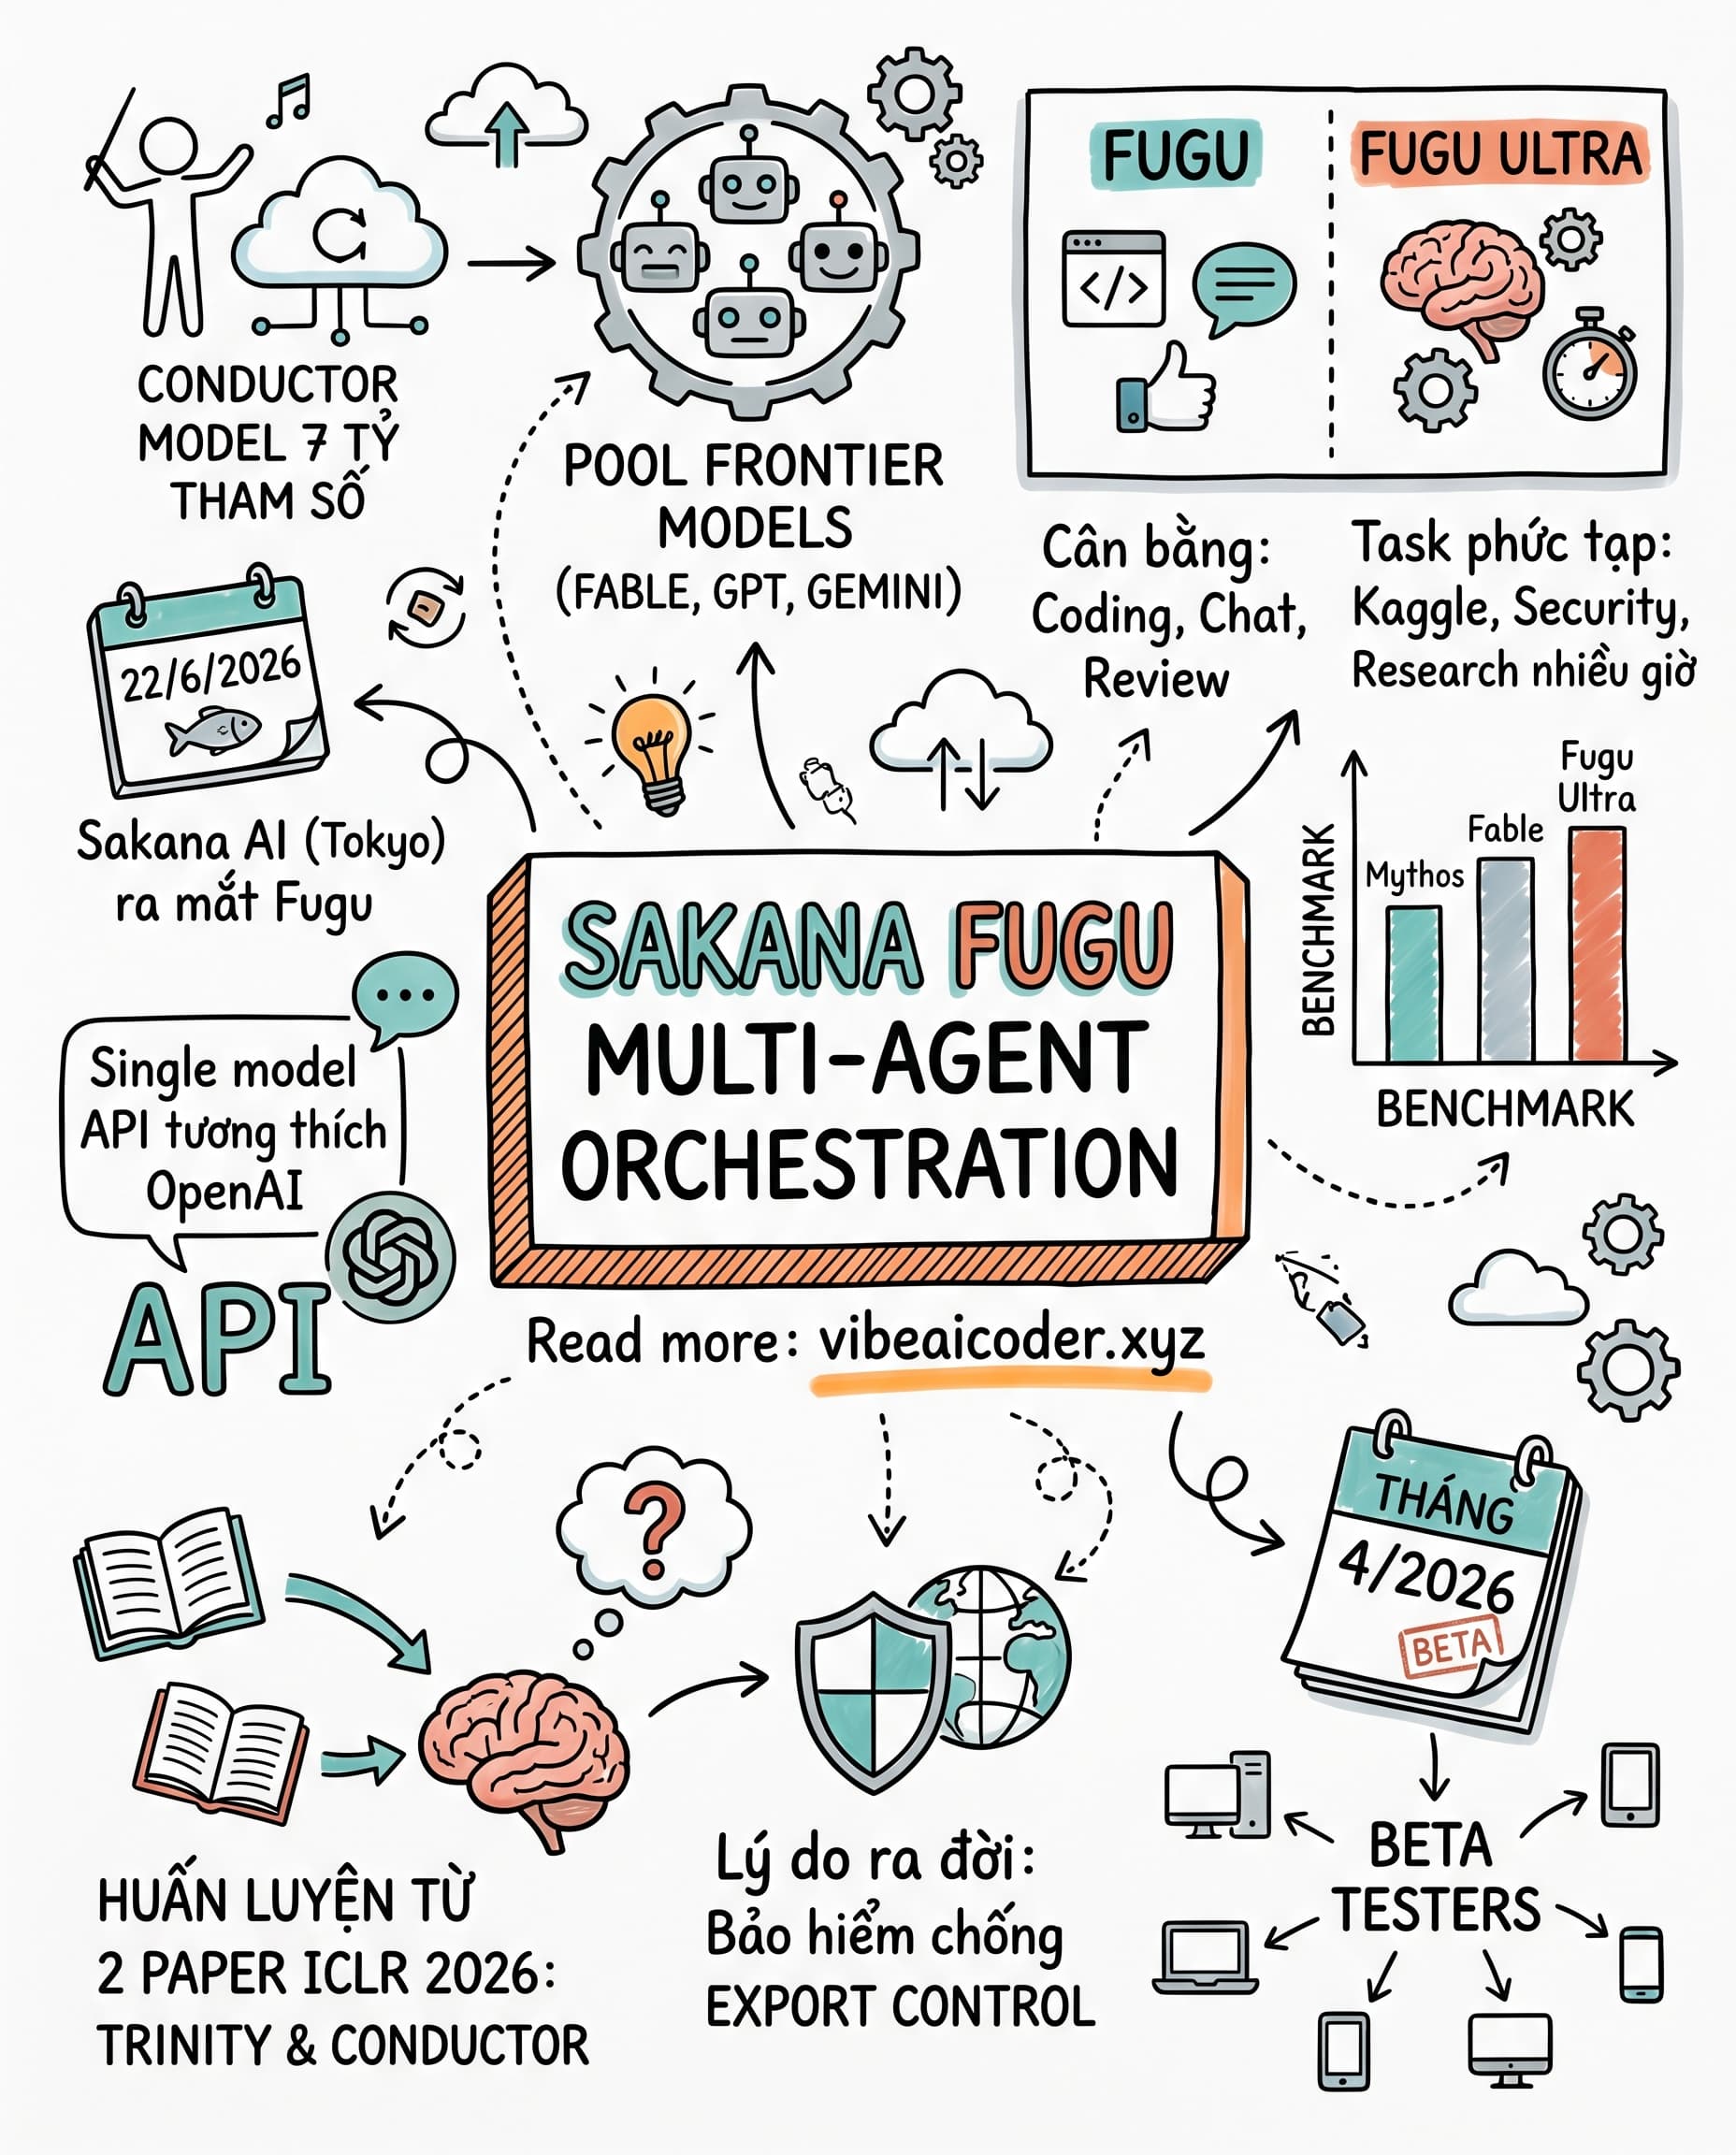
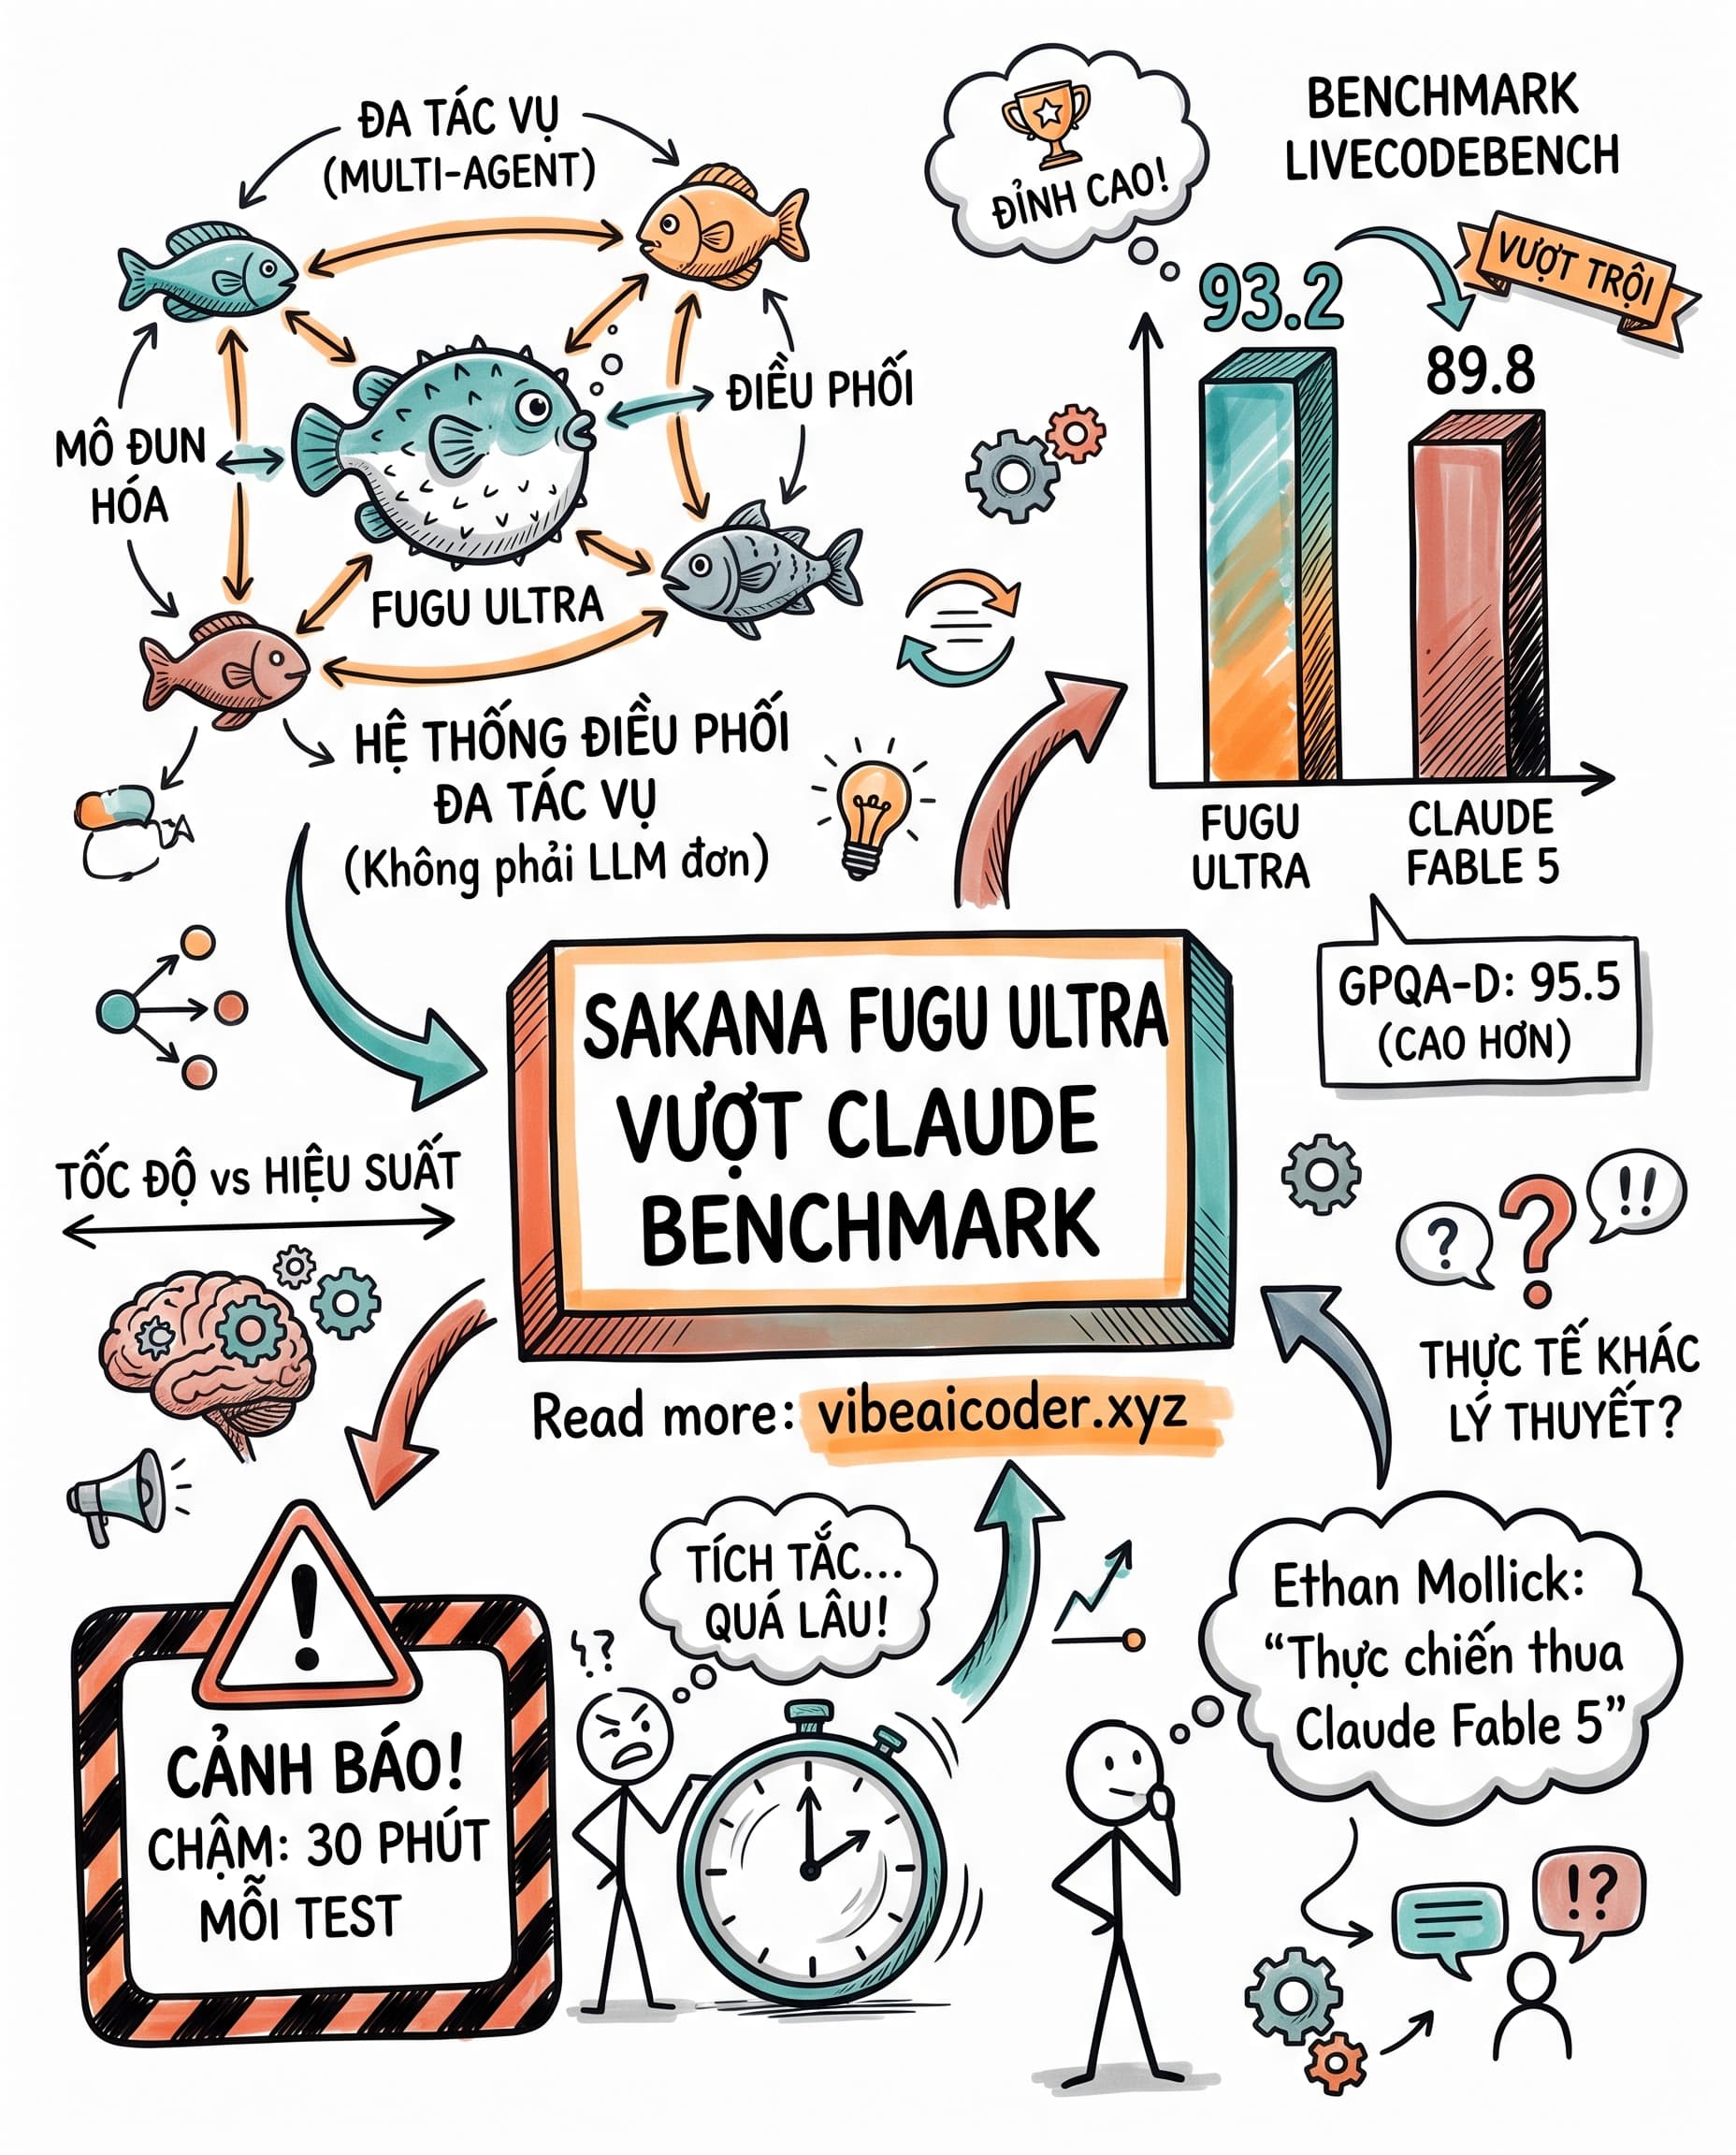
Fugu Ultra không phải một LLM đơn lẻ. Sakana AI ra mắt nó ngày 22/6/2026 như một hệ thống multi-agent orchestration: nhận vấn đề đầu vào, tự phân tích, chia thành các sub-task nhỏ hơn, rồi giao cho một pool các foundation model chuyên biệt xử lý song song. Sau đó hệ thống kiểm tra chéo và tổng hợp kết quả.
Kiến trúc này khác hẳn cách các model thông thường hoạt động. Thay vì một model làm tất cả, Fugu Ultra điều phối nhiều model cùng lúc như một đội nhóm.
 Số Liệu Benchmark Ấn Tượng
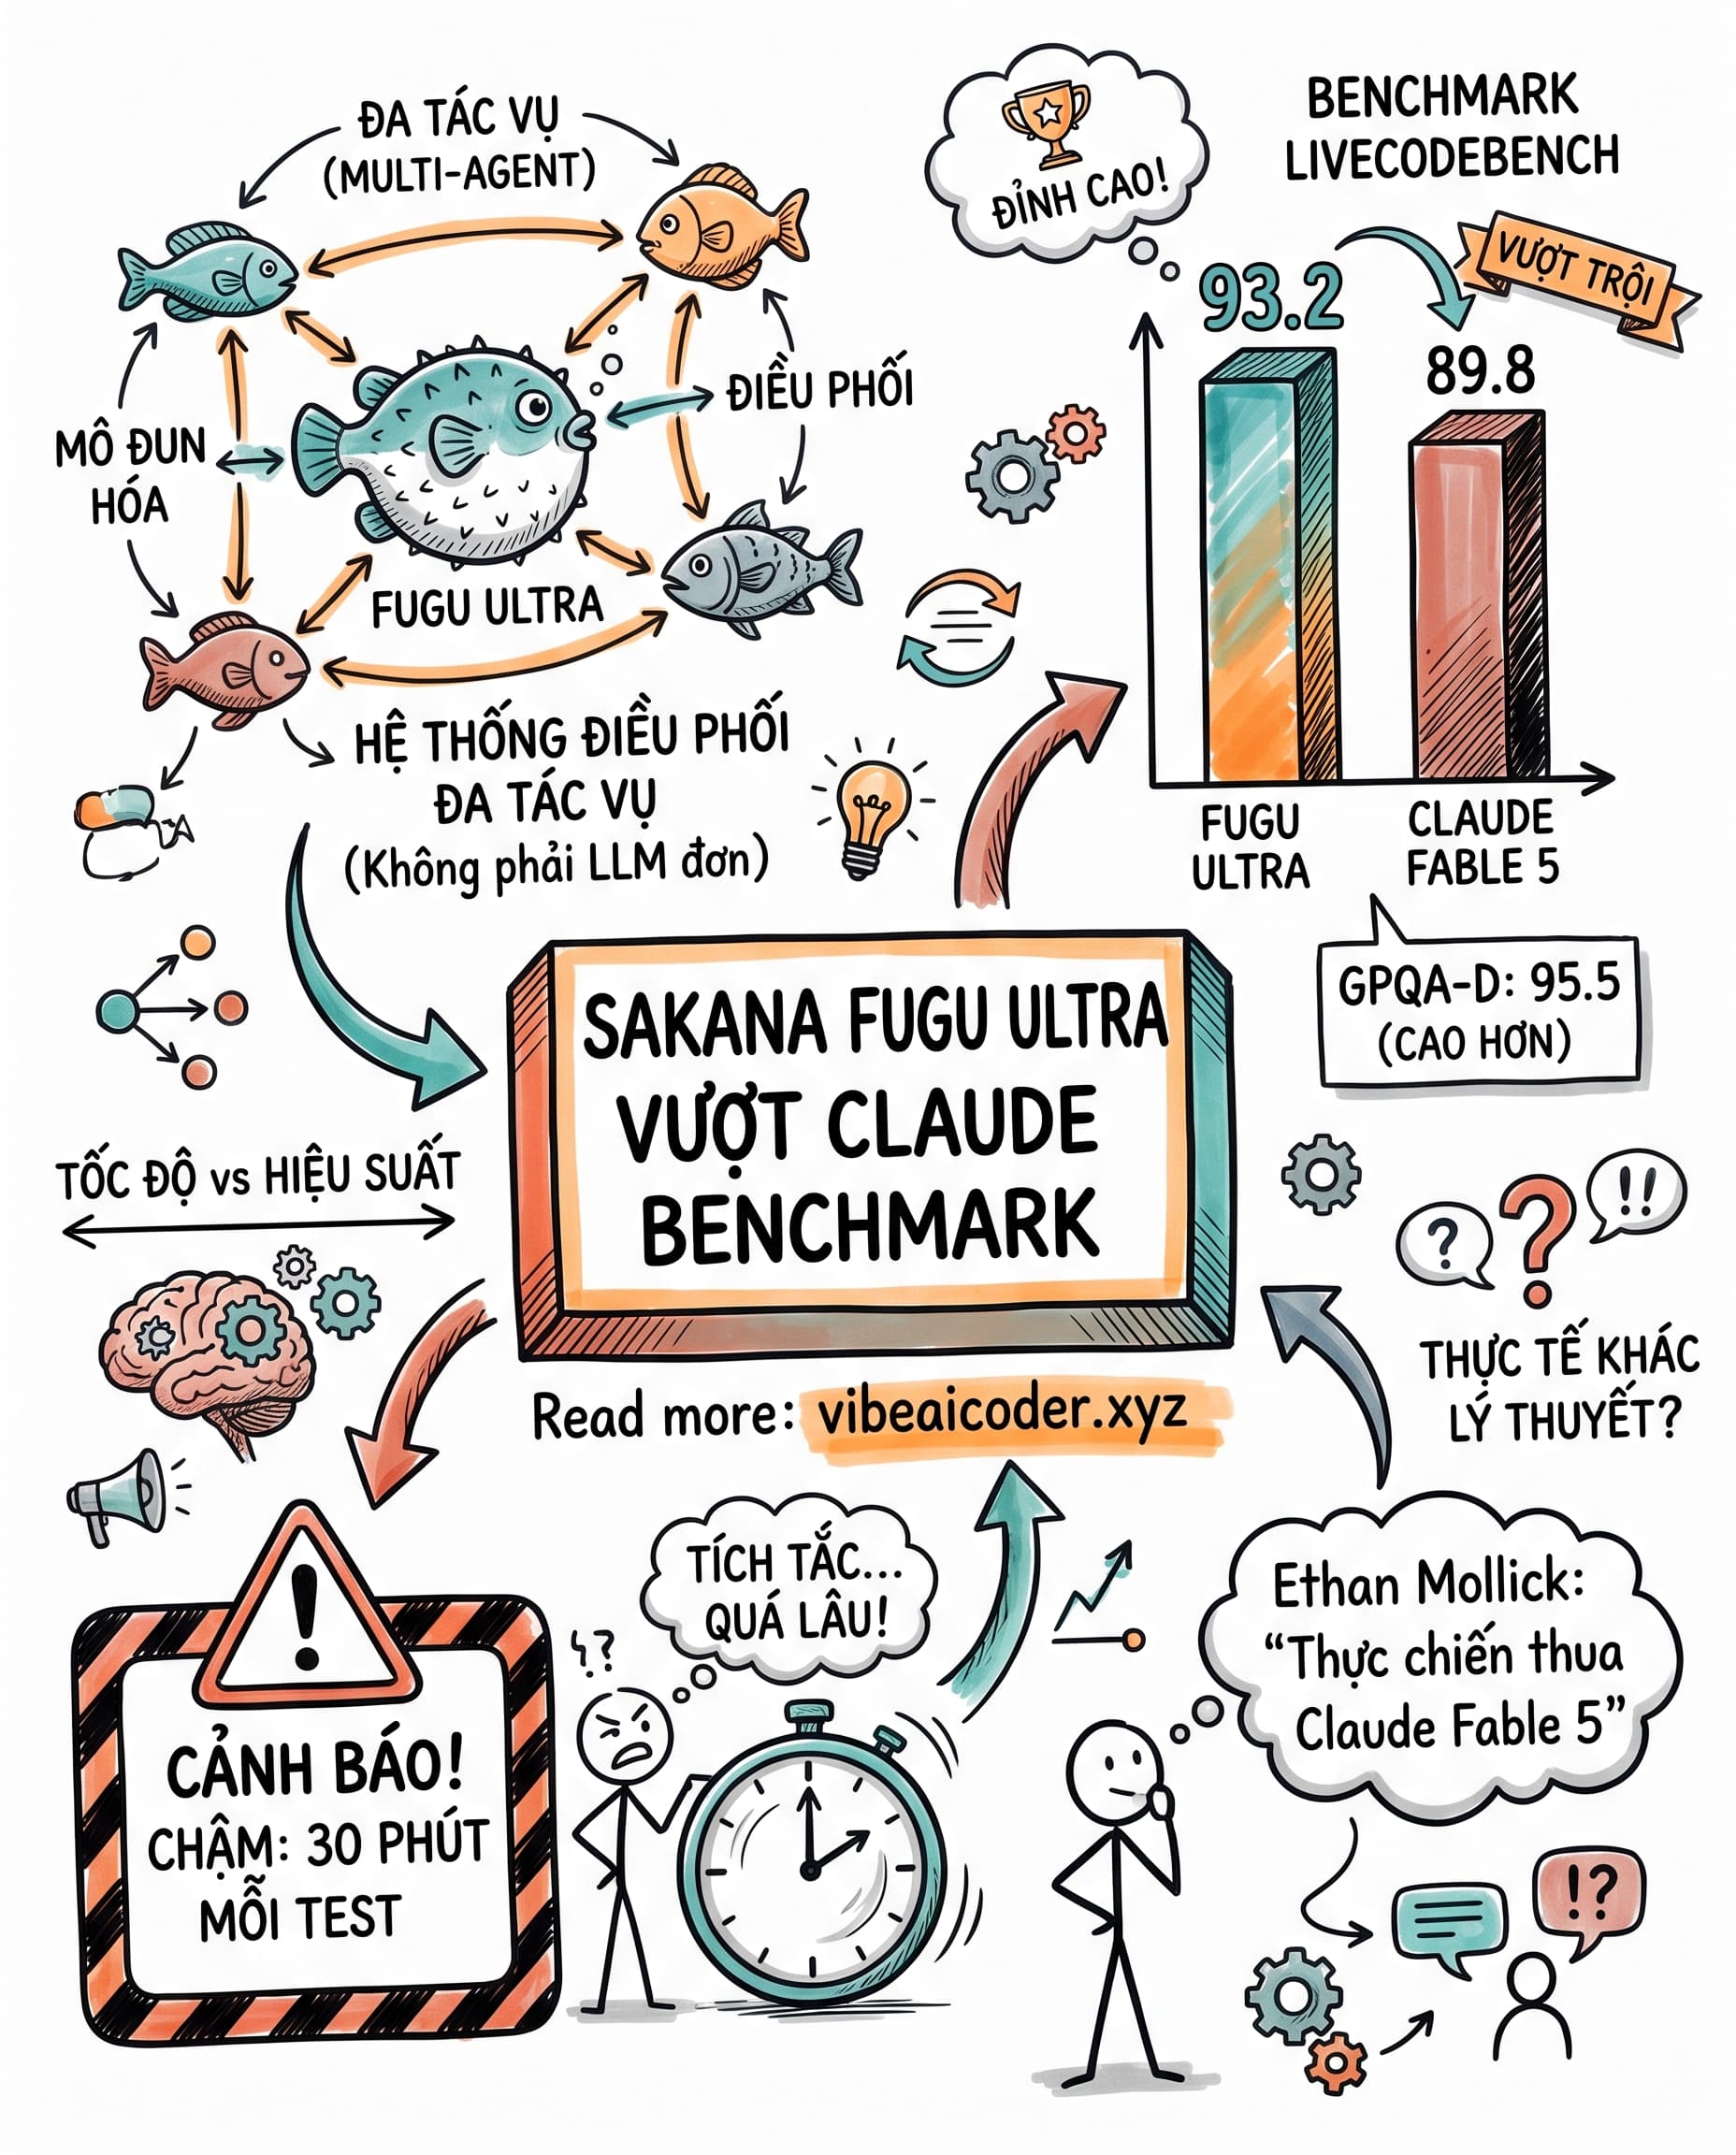
Trên LiveCodeBench, Fugu Ultra đạt 93.2 điểm. Claude Fable 5 đạt 89.8. Khoảng cách 3.4 điểm trên bài kiểm tra lập trình cạnh tranh.
Trên GPQA-Diamond (bộ câu hỏi khoa học tiến sĩ), Fugu Ultra đạt 95.5 điểm. Claude Mythos Preview đạt 94.6. Fugu Ultra dẫn trước 0.9 điểm trên một trong những benchmark khó nhất hiện tại.
Nhìn vào hai con số này, nhiều người sẽ kết luận ngay: Fugu Ultra mạnh hơn Claude Fable 5 và Claude Mythos Preview. Kết luận đó có vấn đề.
 Vấn Đề Thực Sự: Tốc Độ
Ethan Mollick, giáo sư Wharton chuyên nghiên cứu AI ứng dụng, chạy thử Fugu Ultra và ghi lại nhận xét. Ông gọi hệ thống này là "cực kỳ chậm". Một bài test mất 30 phút để hoàn thành.
Kiến trúc multi-agent xử lý tuần tự và song song nhiều lớp có chi phí thời gian rất cao. Với công việc cần phản hồi nhanh, 30 phút mỗi query không phải lựa chọn thực tế.
Mollick còn ghi nhận kết quả thực chiến của Fugu Ultra thua Claude Fable 5 trên các tác vụ thông thường. Điểm benchmark cao, nhưng khi dùng thật thì ngược lại.
 Bài Học Về Benchmark
Fugu Ultra minh họa rõ một vấn đề lớn trong cách đánh giá AI hiện nay: benchmark số cao không phản ánh hiệu quả thực tế.
LiveCodeBench và GPQA-Diamond đo năng lực trên bộ câu hỏi cố định, trong môi trường kiểm soát. Chúng không đo tốc độ phản hồi, không đo chi phí vận hành, không đo khả năng xử lý tác vụ mở mà người dùng thực sự cần.
Một hệ thống đạt 93.2 trên benchmark lập trình nhưng cần 30 phút mỗi lần chạy sẽ thua một model đạt 89.8 nhưng trả lời trong 10 giây, trên hầu hết mọi use case thực tế.
 Multi-Agent Có Tiềm Năng Nhưng Chưa Phải Thời Điểm
Hướng đi của Sakana AI, dùng nhiều model chuyên biệt phối hợp thay vì một model lớn làm tất cả, về lý thuyết hợp lý. Các hệ thống chuyên biệt thường vượt generalist trên domain hẹp.
Vấn đề là overhead của việc điều phối hiện vẫn quá lớn. Chia task, giao việc, kiểm tra chéo, tổng hợp, mỗi bước đều tốn thời gian. Với phần cứng và kiến trúc hiện tại, chi phí đó chưa xứng đáng với mức cải thiện về chất lượng.
Bạn đánh giá model AI mới dựa trên benchmark hay dựa trên thử nghiệm thực tế trước?
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ