 Context, compaction và memory: Claude lấy thông tin từ đâu để trả lời bạn
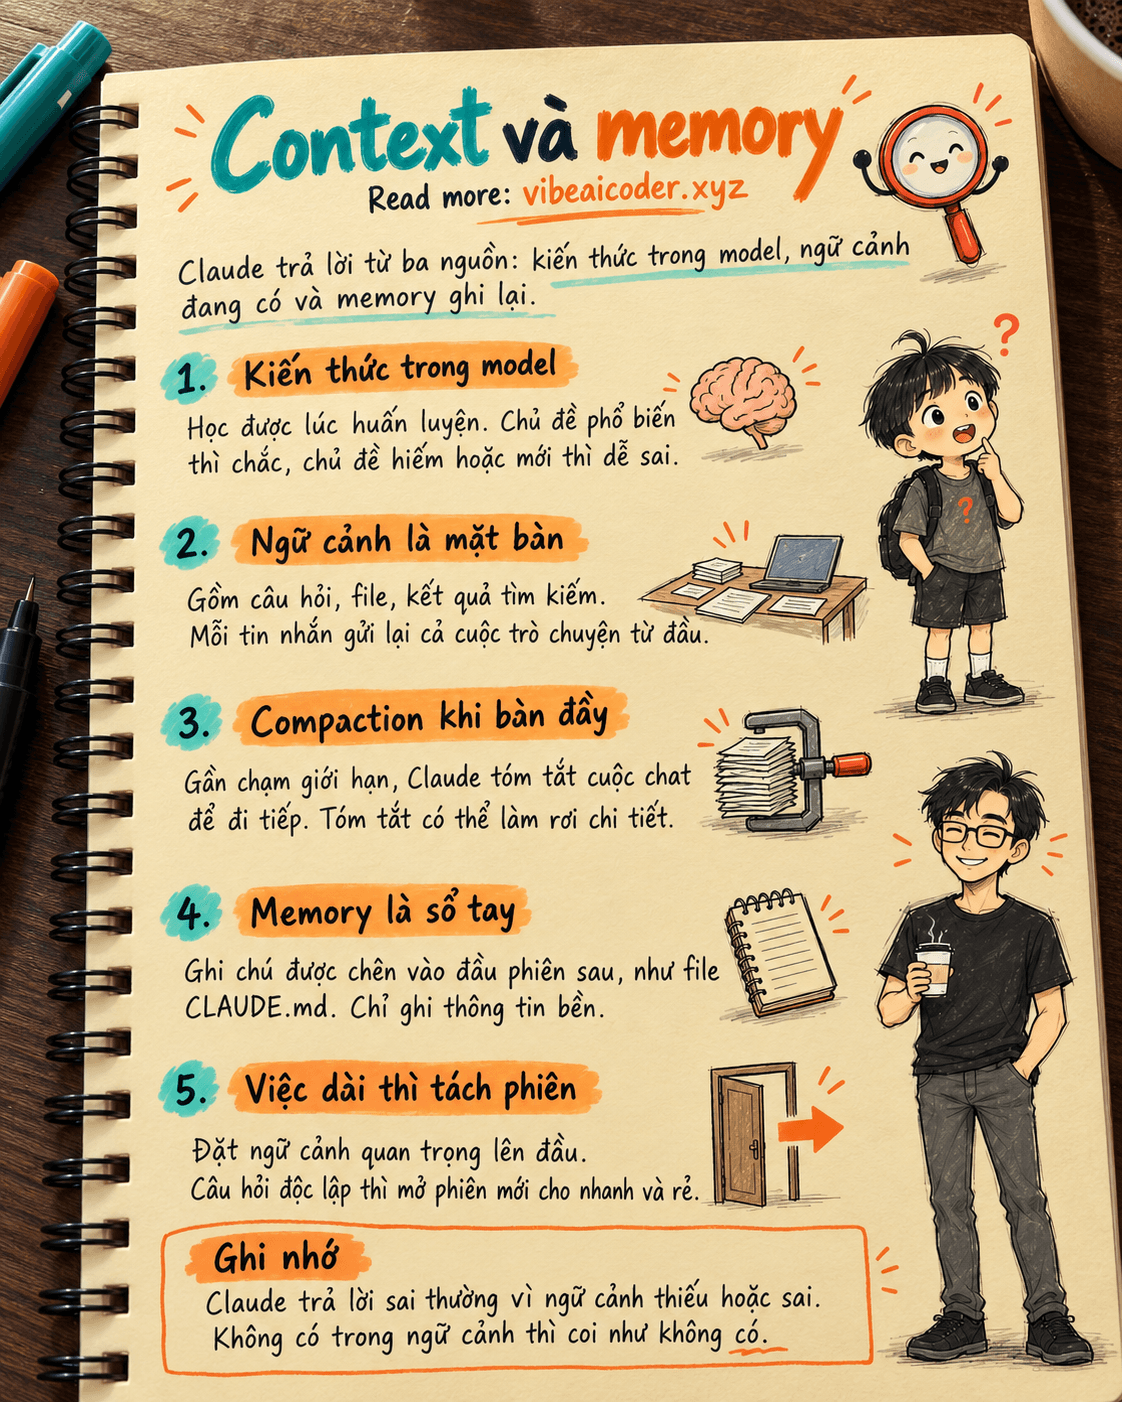
Câu trả lời của Claude đến từ ba nguồn: thứ nó học được lúc huấn luyện, thứ đang có trong cuộc trò chuyện (gọi là ngữ cảnh, hay context), và thứ được ghi lại để dùng cho lần sau (gọi là memory). Khi Claude trả lời sai, gần như luôn là vì ngữ cảnh thiếu, sai hoặc chất lượng thấp, chứ không phải nó cố tình đánh lừa bạn. Biết phân biệt ba nguồn này, bạn đoán được AI sẽ sai ở đâu, hiểu token (đơn vị tính chữ của AI) của mình đi đâu, và vì sao mở một cuộc trò chuyện mới đôi khi là cách nhanh và rẻ nhất.
Nếu bạn mới làm quen với Claude, bài Claude AI là gì là điểm xuất phát tốt.
 Hiểu nhanh bằng ví dụ đời thường
Hãy hình dung Claude là một chuyên gia tư vấn ngồi trước bàn làm việc:
- Trong đầu chuyên gia có kiến thức tích lũy từ hàng nghìn cuốn sách đã đọc. Chuyện phổ biến thì nhớ chắc, chuyện hiếm thì nhớ mang máng.
- Trên mặt bàn là tập hồ sơ bạn vừa đưa: câu hỏi, tài liệu, ghi chú. Mặt bàn có hạn. Hồ sơ dày quá thì phải gom lại, viết tóm tắt một trang rồi cất bản gốc đi.
- Trong cuốn sổ tay là vài dòng ghi về bạn: bạn làm nghề gì, thích được trao đổi thế nào. Lần sau bạn tới, chuyên gia mở sổ ra đọc trước khi nói chuyện.
Ba chỗ đó tương ứng với ba nguồn thông tin của Claude.
 Nó hoạt động thế nào
Nguồn 1: Kiến thức nằm sẵn trong model
Đôi khi Claude đơn giản là biết một chuyện, vì kiến thức đó đã nằm trong model từ lúc huấn luyện. Nhưng không ai đặt mục tiêu xây một cuốn bách khoa toàn thư. Khả năng nhớ dữ kiện chỉ là hệ quả phụ của việc học đoán chữ kế tiếp. Vì là hệ quả phụ nên nó không đều: chủ đề phổ biến thì dày và chắc, chủ đề hiếm hoặc mới thì mỏng và dễ sai. Bạn có thể đọc thêm về điều này ở bài 4 tính chất của AI tạo sinh.
Nguồn 2: Ngữ cảnh, cái mặt bàn có giới hạn
Ngữ cảnh là mọi thứ đang nằm trong cuộc trò chuyện: câu hỏi của bạn, file bạn đính kèm, kết quả tìm kiếm được kéo vào. Đưa thêm tài liệu là cách dễ nhất để biến việc khó thành việc dễ. Cách "cứ đưa hết những gì có thể cần" nhìn chung hiệu quả, nhưng vướng một hạn mức gọi là cửa sổ ngữ cảnh.
Các model Claude mạnh nhất hiện giữ được tới khoảng một triệu token, cỡ ba cuốn tiểu thuyết dày. Vậy sao vẫn có người chạm giới hạn dù chưa gõ tới một phần trăm số đó? Vì phần lớn ngữ cảnh không phải chữ bạn viết. Một ví dụ thu nhỏ trên cửa sổ 1.000 token:
| Thành phần trong một lượt hỏi | Số token |
|---|---|
| Câu hỏi bạn gõ | 28 |
| Hướng dẫn hệ thống đi kèm từ trước (system prompt) | 345 |
| Kết quả tìm kiếm Claude kéo vào | 184 |
Sản phẩm thật có con số lớn hơn, nhưng tỷ lệ tương tự: phần lớn thứ bạn trả tiền là ngữ cảnh bạn không viết ra. Muốn hiểu token được tính thế nào, xem bài token là gì.
Một điều quan trọng: mỗi tin nhắn bạn gửi đều gửi lại toàn bộ cuộc trò chuyện từ đầu, gồm cả phần ngữ cảnh chèn sẵn mà bạn không thấy. Vì vậy một câu hỏi ngắn ở cuối phiên dài có thể đắt hơn đúng câu đó ở phiên mới.
Khi mặt bàn đầy: tóm tắt để đi tiếp (compaction)
Khi ngữ cảnh gần chạm ngưỡng, ứng dụng không gửi tiếp ngay mà làm ba bước:
- Nhận ra sắp đầy: giữ câu hỏi mới của bạn lại.
- Nhờ Claude tóm tắt: đưa toàn bộ cuộc trò chuyện vào kèm yêu cầu tóm tắt mọi thứ đã diễn ra.
- Đi tiếp từ bản tóm tắt: bản tóm tắt thay chỗ lịch sử cũ, rồi câu hỏi đang giữ mới được gửi đi.
Những phiên bản đầu của cách làm này mất chi tiết rõ tới mức nhận ra được: chỉ dẫn đưa trước lúc tóm tắt thường không sống sót. Giờ đã tốt hơn nhiều, nhưng tóm tắt vẫn là tóm tắt, vẫn có thể rơi mất chi tiết. Đó là lý do việc dài nên tách phiên và nhắc lại yêu cầu quan trọng ở mỗi phần mới.
Nguồn 3: Memory, cuốn sổ tay qua nhiều phiên
Tóm tắt giúp một phiên đi xa hơn giới hạn. Memory giúp thông tin quan trọng đi qua nhiều phiên.
Cơ chế đơn giản: Claude ghi vài điều vào một chỗ, và ở phiên sau, những ghi chú đó được chèn vào ngữ cảnh trước tin nhắn đầu tiên của bạn. Thứ Ba bạn nói mình thích báo cáo ngắn gọn, Claude ghi lại. Thứ Năm bạn mở phiên mới, không nhắc gì, Claude vẫn biết.
Mỗi sản phẩm cài đặt khác nhau. Trên claude.ai, memory nằm trong phần cài đặt. Claude Code (công cụ lập trình của Claude) đọc các file hướng dẫn trong máy:
- File
CLAUDE.mdtrong thư mục dự án: quy ước chung của dự án, có thể chia sẻ cho cả nhóm. - Thư mục
.claude/rules/trong dự án: các nhóm quy tắc chi tiết hơn. - File
~/.claude/CLAUDE.mdtrong máy bạn: sở thích cá nhân, áp dụng cho mọi dự án. - Lịch sử từng phiên làm việc cũng được lưu trong thư mục
~/.claudetrên máy.
Chỗ lưu khác nhau nhưng quy trình giống nhau: ghi ra, rồi đọc lại ở lần sau. Lưu ý an toàn: lịch sử phiên có thể chứa nội dung file Claude đã đọc và văn bản bạn đã dán vào, nên đừng để công cụ đọc hoặc in ra mật khẩu, khóa bí mật khi không cần.
 Điều này có ý nghĩa gì với bạn
Chọn đúng thứ để ghi vào memory. Thứ đáng ghi là những gì bền: dự án bạn đang làm, cách bạn muốn được trao đổi, ai làm việc cùng bạn. Thứ không nên ghi là dữ kiện dễ cũ: số người đã xác nhận dự tiệc, báo giá của nhà cung cấp. Những cái đó lần sau nên tra lại, đừng ghi rồi mong nó chưa đổi.
Hiểu ngữ cảnh chèn sẵn và ngữ cảnh tự lấy. Trước khi Claude đọc chữ đầu tiên của bạn, nhiều thứ đã nằm trong ngữ cảnh: hướng dẫn hệ thống, mô tả công cụ, ghi chú memory. Rồi ở mỗi lượt, Claude tự quyết định trả lời bằng thứ đang có hay đi tra thêm (tìm web, đọc file, dùng công cụ). Khi bạn chọn mức nỗ lực cao, nó tra và kiểm nhiều hơn, câu trả lời tốt hơn nhưng tốn ngữ cảnh hơn. Mức thấp thì nó trả lời thẳng.
Bốn thói quen rút ra:
- Đặt ngữ cảnh quan trọng lên đầu, đừng chôn chỉ dẫn ở giữa tài liệu dài.
- Việc dài thì tách phiên, câu hỏi độc lập thì mở phiên mới thay vì hỏi tiếp trong phiên đã dài.
- Dựng ngữ cảnh thường trú cho việc lặp lại: Project trên claude.ai,
CLAUDE.mdtrong dự án code, file mẫu đính kèm sẵn. - Đừng trông vào việc nó nhớ lời bạn sửa. Không có trong ngữ cảnh thì coi như không có.
Ví dụ một đoạn mở đầu phiên mới khi tiếp tục việc dở:
Tôi đang viết báo cáo quý cho phòng kinh doanh. Đã xong phần 1 và 2 (tóm tắt đính kèm). Yêu cầu giữ nguyên: giọng trang trọng, mỗi phần tối đa 300 chữ, số liệu lấy từ file đính kèm. Giờ viết phần 3 về [chủ đề].
 Hiểu lầm thường gặp
Hiểu lầm 1: "Claude nhớ hết mọi thứ tôi từng nói." Sự thật: trong một phiên, nó chỉ thấy những gì còn trong ngữ cảnh, và phiên dài có thể đã bị tóm tắt. Qua phiên khác, nó chỉ biết những gì được ghi vào memory.
Hiểu lầm 2: "Câu hỏi ngắn thì tốn ít token." Sự thật: mỗi lượt gửi lại cả cuộc trò chuyện. Câu hỏi ngắn ở cuối một phiên dài vẫn tốn nhiều token.
Hiểu lầm 3: "Cửa sổ một triệu token thì cứ nhét hết vào." Sự thật: nhiều chưa chắc tốt. Chỉ dẫn quan trọng bị chôn giữa khối tài liệu lớn dễ bị bỏ qua. Ngữ cảnh gọn, đúng trọng tâm thường cho kết quả tốt hơn.
 Câu hỏi thường gặp
Context (ngữ cảnh) của Claude là gì? Là mọi thứ Claude đang thấy trong cuộc trò chuyện: câu hỏi của bạn, file đính kèm, kết quả tìm kiếm, cùng phần hướng dẫn hệ thống chèn sẵn.
Compaction là gì? Là cách ứng dụng tóm tắt cuộc trò chuyện khi gần đầy cửa sổ ngữ cảnh để phiên đi tiếp được. Bản tóm tắt có thể làm rơi chi tiết.
Memory khác ngữ cảnh thế nào? Ngữ cảnh chỉ sống trong một phiên. Memory là ghi chú được lưu lại và chèn vào đầu các phiên sau, giúp Claude nhớ thông tin bền về bạn.
Vì sao nên mở phiên mới thay vì hỏi tiếp? Vì phiên mới không phải gửi lại cả lịch sử dài, nên nhanh hơn, rẻ hơn và ít bị nhiễu bởi chỉ dẫn cũ.
Nên ghi gì vào memory hoặc CLAUDE.md? Những thông tin bền: dự án, quy ước, cách bạn muốn làm việc. Đừng ghi số liệu dễ thay đổi như giá cả hay danh sách tạm thời.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
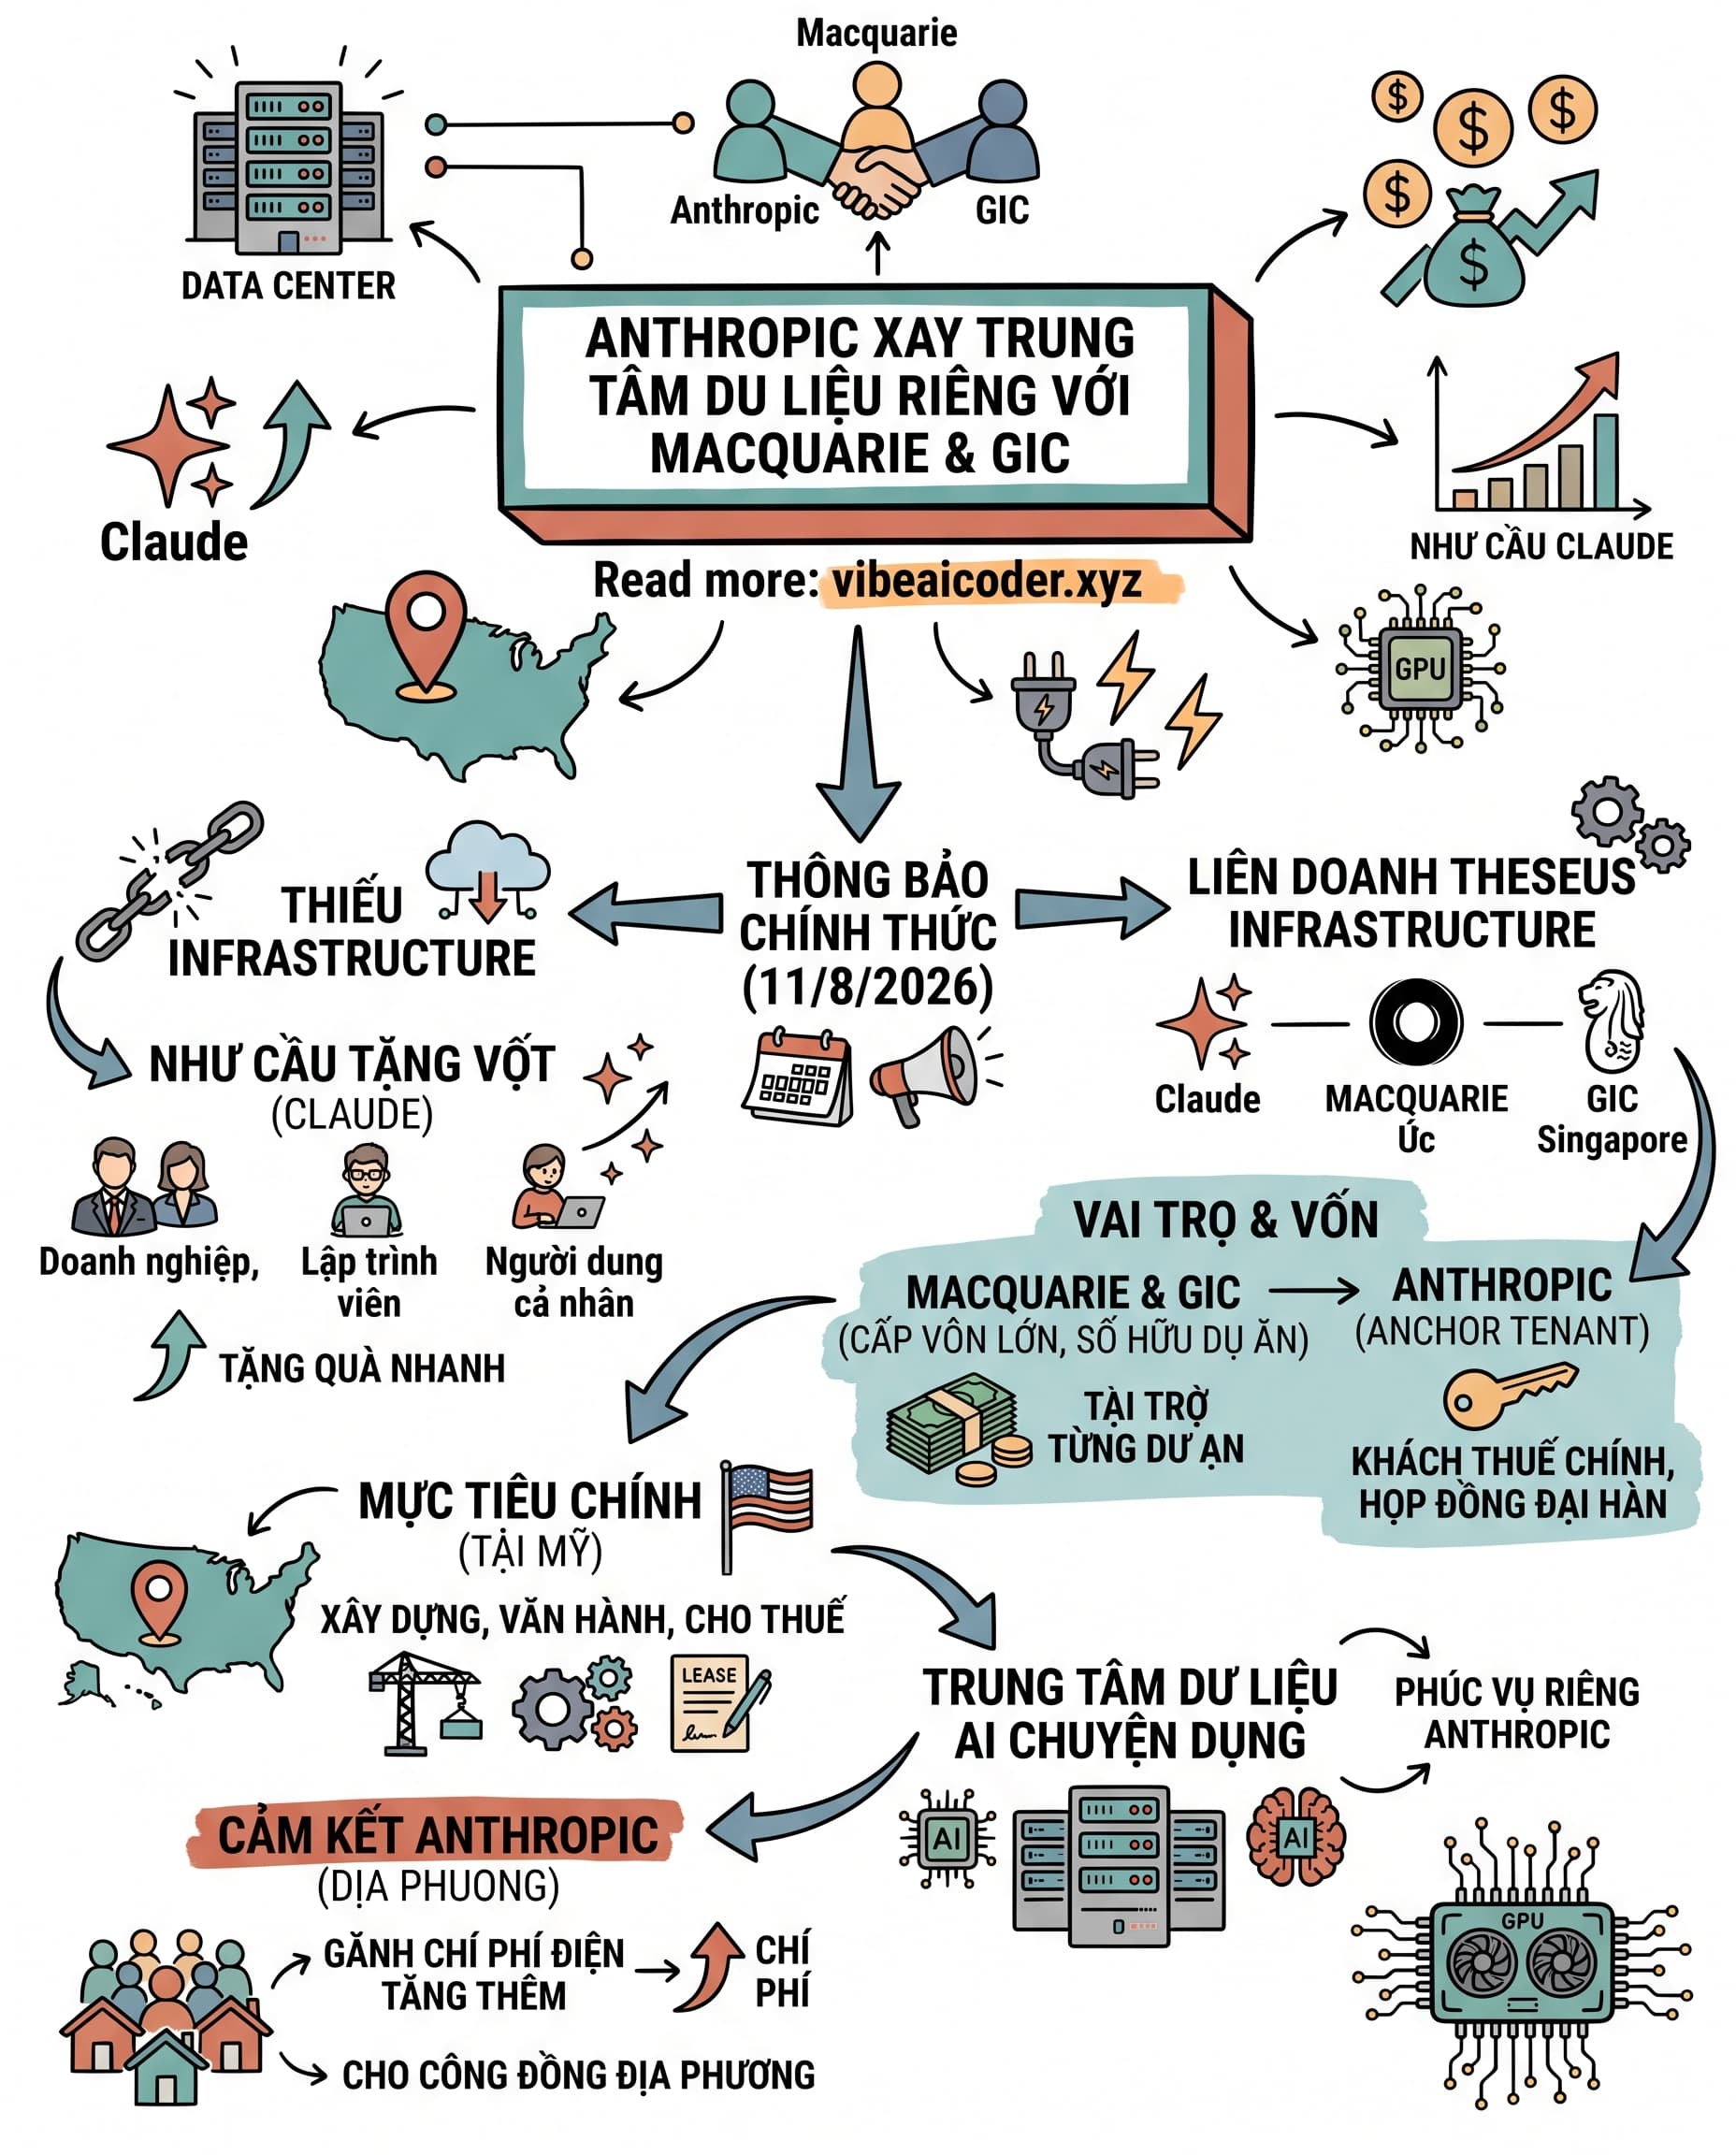
 Anthropic bắt tay Macquarie và GIC, tự xây trung tâm dữ liệu riêng cho Claude
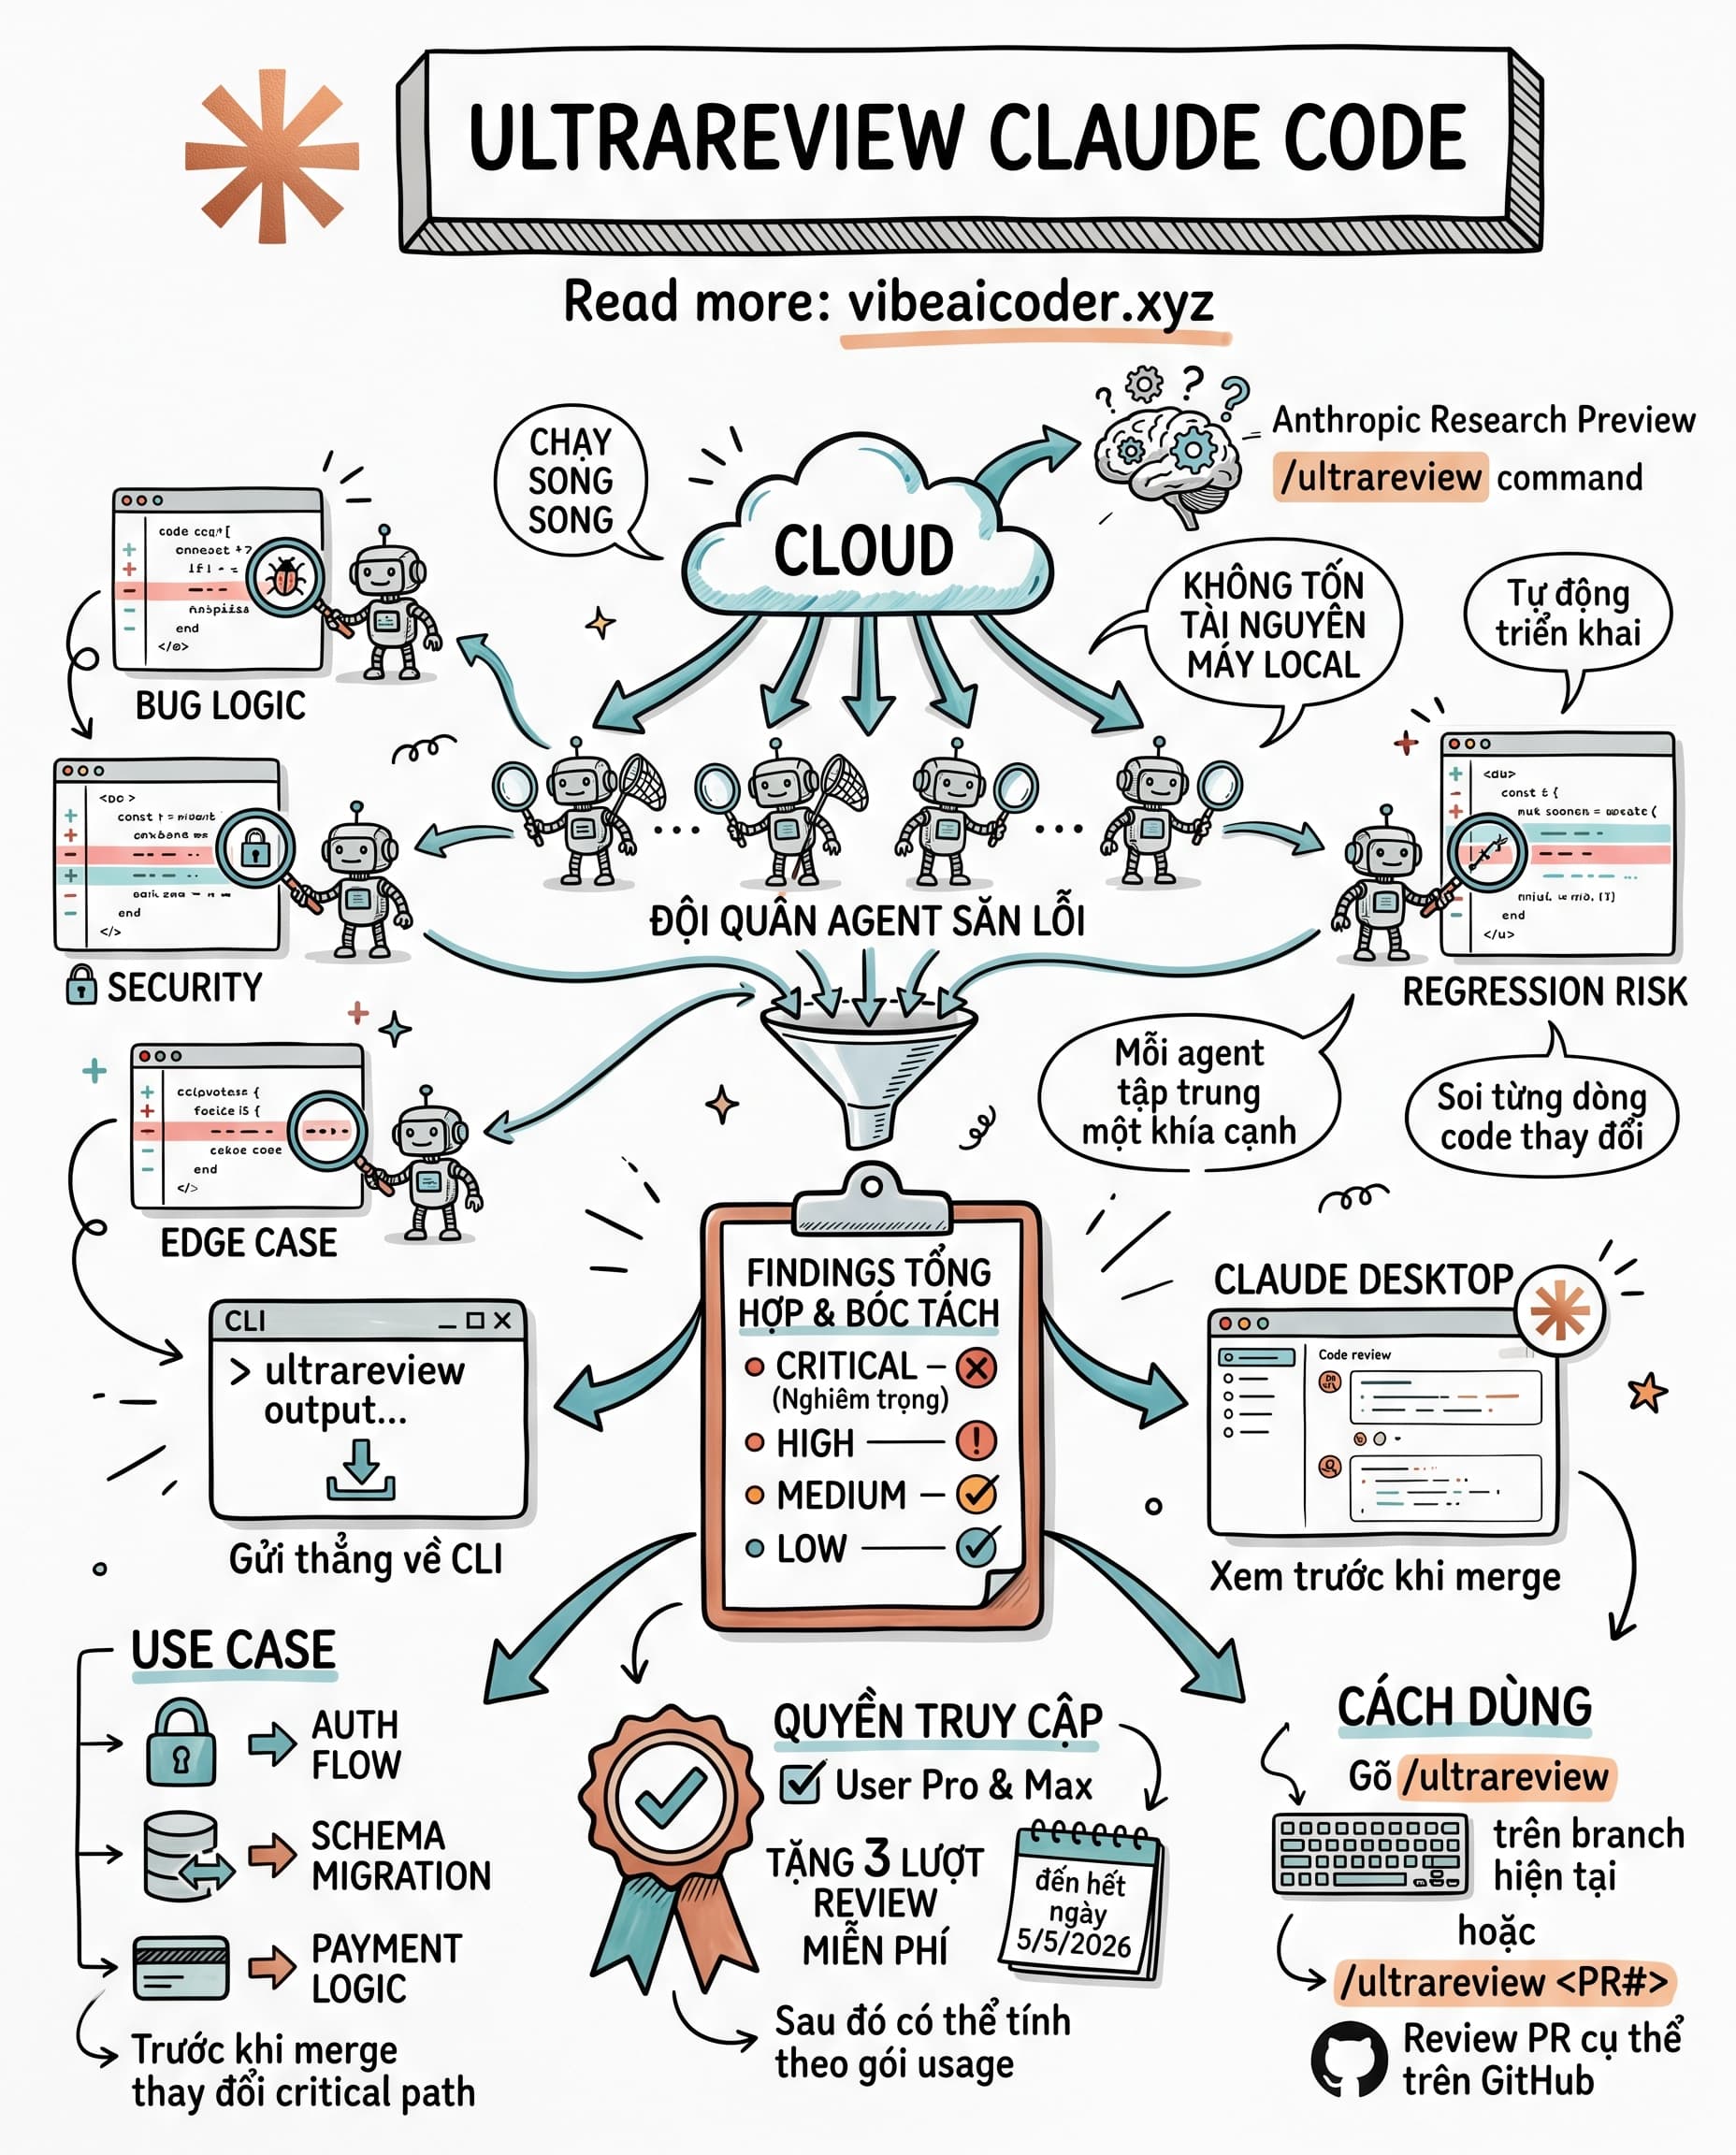
 Anthropic ra mắt /ultrareview trong Claude Code, đội quân agent săn bug chạy trên cloud

 Claude Opus 4.7 ra mắt: Model Opus mạnh nhất từ trước đến nay, vượt mặt GPT-5.4 và Gemini 3.1 Pro