Bonsai 2: Nén AI 27 tỷ tham số xuống 6GB, điểm số đẹp nhưng vẫn vấp việc thật
🌳 Bonsai 2: Nén một AI khổng lồ xuống 6GB, điểm số đẹp nhưng vẫn vấp việc thật
Tưởng tượng bạn nén cả một cuốn từ điển dày cộp thành một tờ giấy nhỏ mà vẫn tra được gần hết mọi từ. Đó gần như là những gì công ty PrismML vừa làm được với một mô hình AI 27 tỷ tham số. Nhưng khi đem "tờ giấy nhỏ" đó đi làm việc thật, mọi chuyện lại không đơn giản như con số trên giấy.
 Một AI 54GB biến thành 6GB
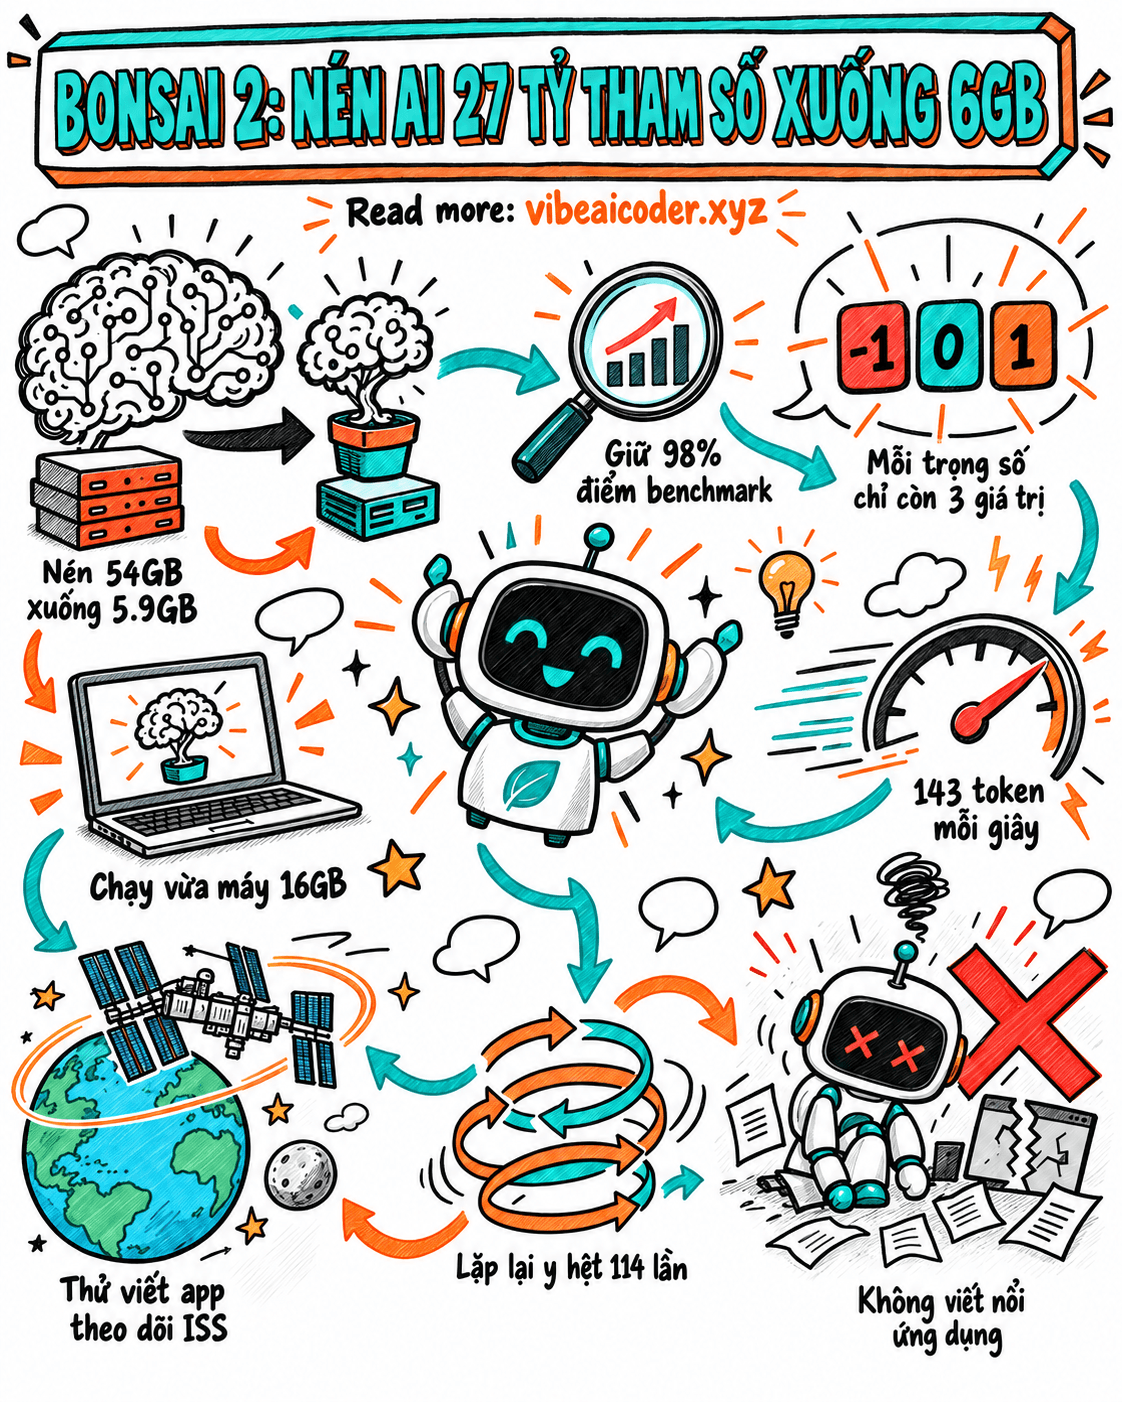
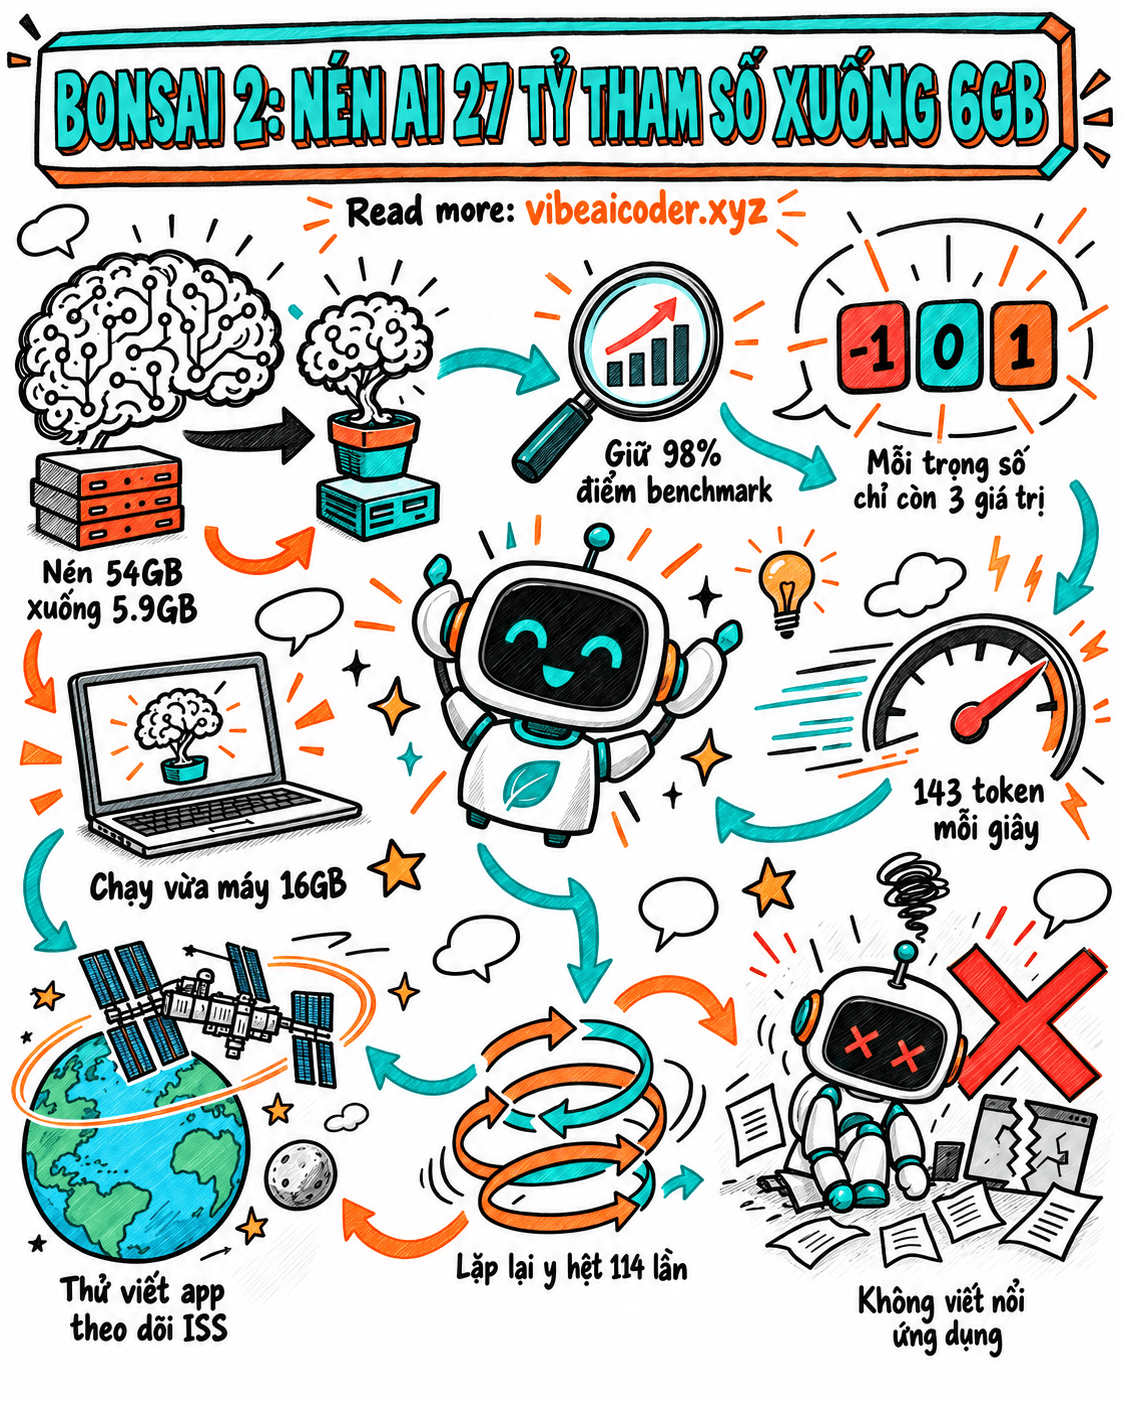
PrismML lấy mô hình Qwen3.8 27B (bản gốc nặng khoảng 53,8GB) và tạo ra phiên bản nén tên là Bonsai 2, chỉ còn khoảng 5,9GB, tức là nhẹ hơn gần 9 lần.
Cách họ làm nghe có vẻ liều lĩnh: bình thường mỗi "con số" bên trong não AI (gọi là trọng số, tức các con số AI dùng để tính toán và ra quyết định) có thể nhận rất nhiều giá trị khác nhau, giống như một bức ảnh có hàng triệu sắc màu. PrismML ép mỗi con số đó chỉ còn đúng 3 lựa chọn: -1, 0 hoặc +1, giống như biến bức ảnh nhiều màu thành ảnh chỉ có đen, trắng và xám. Đổi lại, file nhẹ đi rất nhiều và chạy nhanh hơn.
 Điểm benchmark: gần như không giảm
Cái bất ngờ là điểm số của Bonsai 2 trên các bài kiểm tra chuẩn (gọi là benchmark, tức bộ đề thi thử để đo AI giỏi cỡ nào) gần như không giảm so với bản gốc:
- Tổng thể: giữ được 98,2% điểm của bản gốc.
- Toán: giữ 99,5%.
- Lập trình: giữ 99,3%.
- Làm theo yêu cầu (instruction following): thậm chí còn cao hơn bản gốc một chút.
Về tốc độ, Bonsai 2 chạy được khoảng 143 token mỗi giây trên card đồ hoạ RTX 5090, và khoảng 47 token mỗi giây trên laptop Apple M5 Max (token có thể hiểu đơn giản là từng mẩu nhỏ của câu chữ mà AI sinh ra). Model này thậm chí chạy vừa trên máy chỉ có 16GB bộ nhớ, tức là một laptop bình thường cũng đủ sức "cõng" một AI 27 tỷ tham số, điều gần như không tưởng cách đây một năm.
Nhìn vào bảng số liệu này, ai cũng sẽ nghĩ Bonsai 2 là bản sao gần như hoàn hảo của bản gốc, chỉ nhẹ hơn và rẻ hơn để chạy.
🛰️ Nhưng khi giao việc thật, chuyện khác hẳn
Kênh YouTube Prompt Engineering đã thử một bài kiểm tra thực tế hơn nhiều so với benchmark: yêu cầu cả hai model (bản gốc và Bonsai 2) tự viết một ứng dụng theo dõi vị trí trạm vũ trụ ISS trên một quả địa cầu 3D, một việc đòi hỏi AI phải tự lên kế hoạch, viết code, kiểm tra rồi sửa lỗi qua nhiều bước liên tiếp (gọi là AI agent, tức AI tự hành động thay vì chỉ trả lời một câu).
Kết quả:
- Bản gốc Qwen3.8 27B: viết ra một ứng dụng chạy được thật.
- Bonsai 2: không viết nổi một dòng code nào của ứng dụng. Nó bị kẹt trong một vòng lặp, lặp đi lặp lại đúng một lượt tìm kiếm y hệt tới 114 lần, và lần nào cũng cho ra đúng một kết quả giống hệt nhau, như bị "trượt băng tại chỗ" mà không tiến thêm được bước nào.
 Vì sao điểm cao mà vẫn thất bại
Bài học ở đây không phải là Bonsai 2 "dở", mà là benchmark và công việc thật là hai chuyện khác nhau. Các bài kiểm tra chuẩn thường là những câu hỏi ngắn, có đáp án rõ ràng. Nhưng một việc như "tự viết cả một ứng dụng" đòi hỏi AI phải nối tiếp rất nhiều bước nhỏ, mỗi bước một chút sai lệch có thể cộng dồn lại. Khi nén một model quá mạnh, những sai lệch nhỏ li ti đó dễ khiến AI bị lạc hướng hoặc quẩn quanh trong vòng lặp, dù nó vẫn trả lời cực tốt cho từng câu hỏi đơn lẻ.
 Bài học cho người dùng
Nếu bạn đang cân nhắc chạy một AI nhẹ, rẻ ngay trên laptop của mình, con số benchmark đẹp là một tín hiệu tốt nhưng chưa đủ để tin tưởng hoàn toàn. Với các việc đơn giản như trò chuyện, tóm tắt hay trả lời nhanh, các model nén như Bonsai 2 hoàn toàn ổn và tiết kiệm rất nhiều chi phí. Nhưng nếu bạn định giao cho AI những việc nhiều bước, cần nó tự lên kế hoạch và tự sửa lỗi như một trợ lý lập trình thật sự, hãy tự thử với đúng công việc của bạn trước khi tin dùng, thay vì chỉ nhìn vào bảng điểm.
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
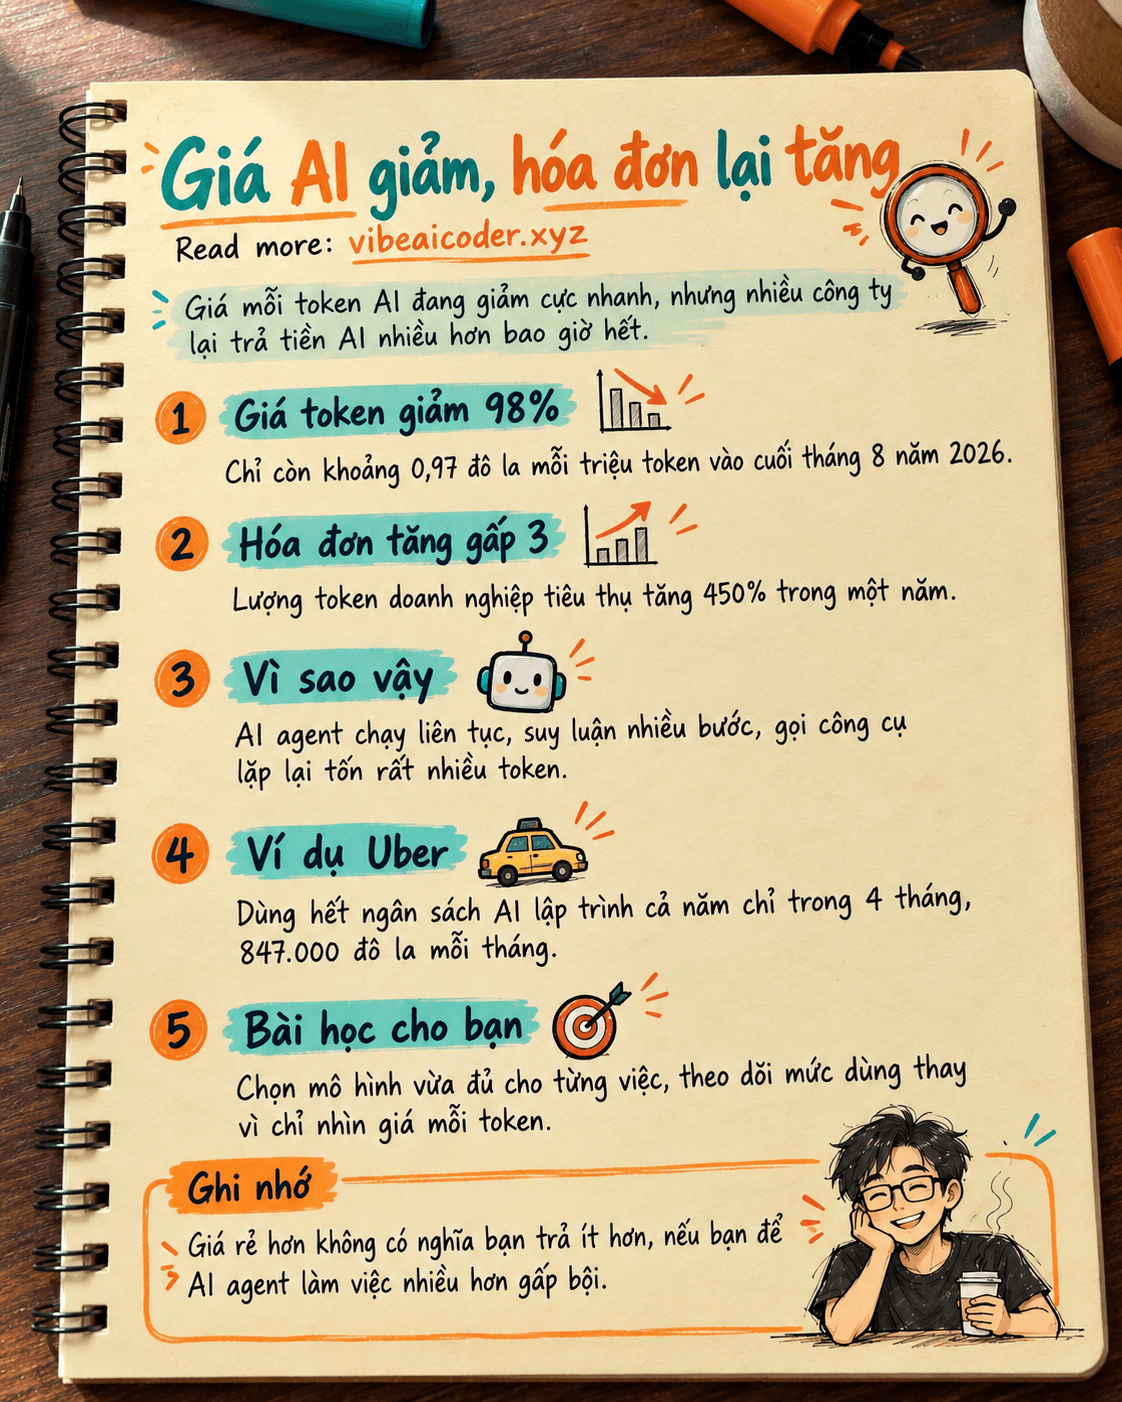
 Giá AI giảm 98% nhưng hóa đơn công ty lại tăng gấp 3