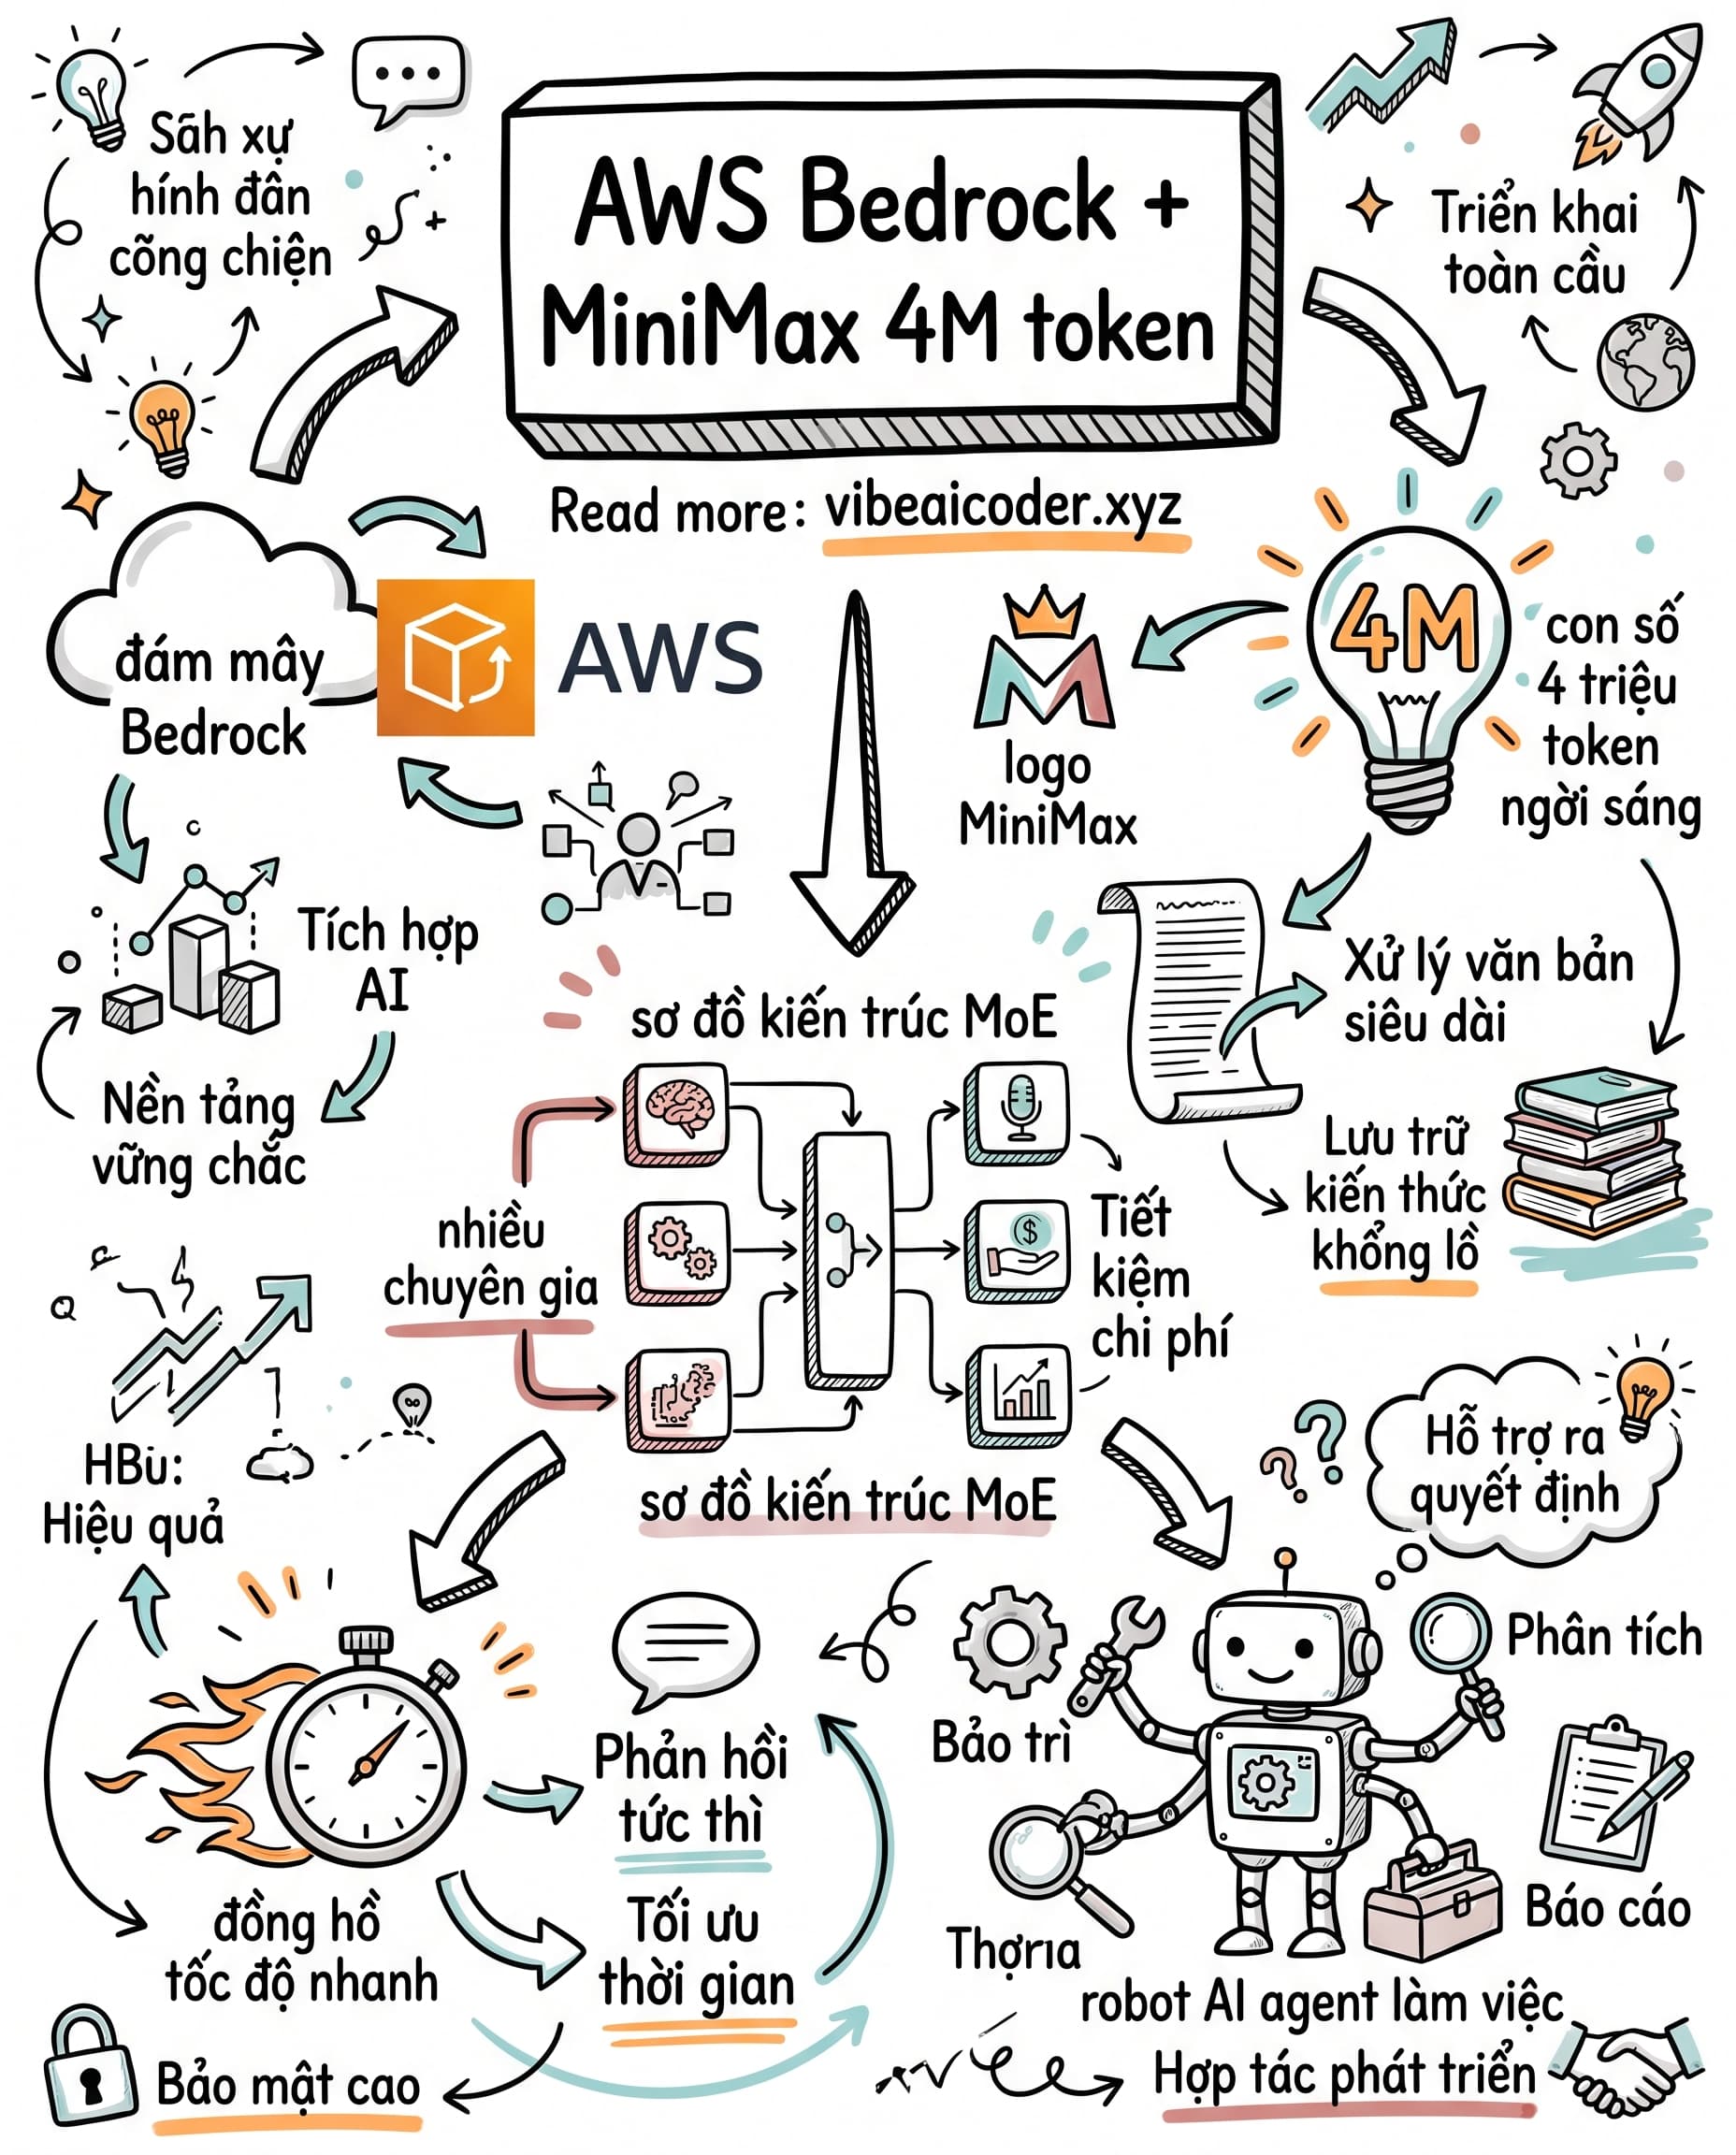
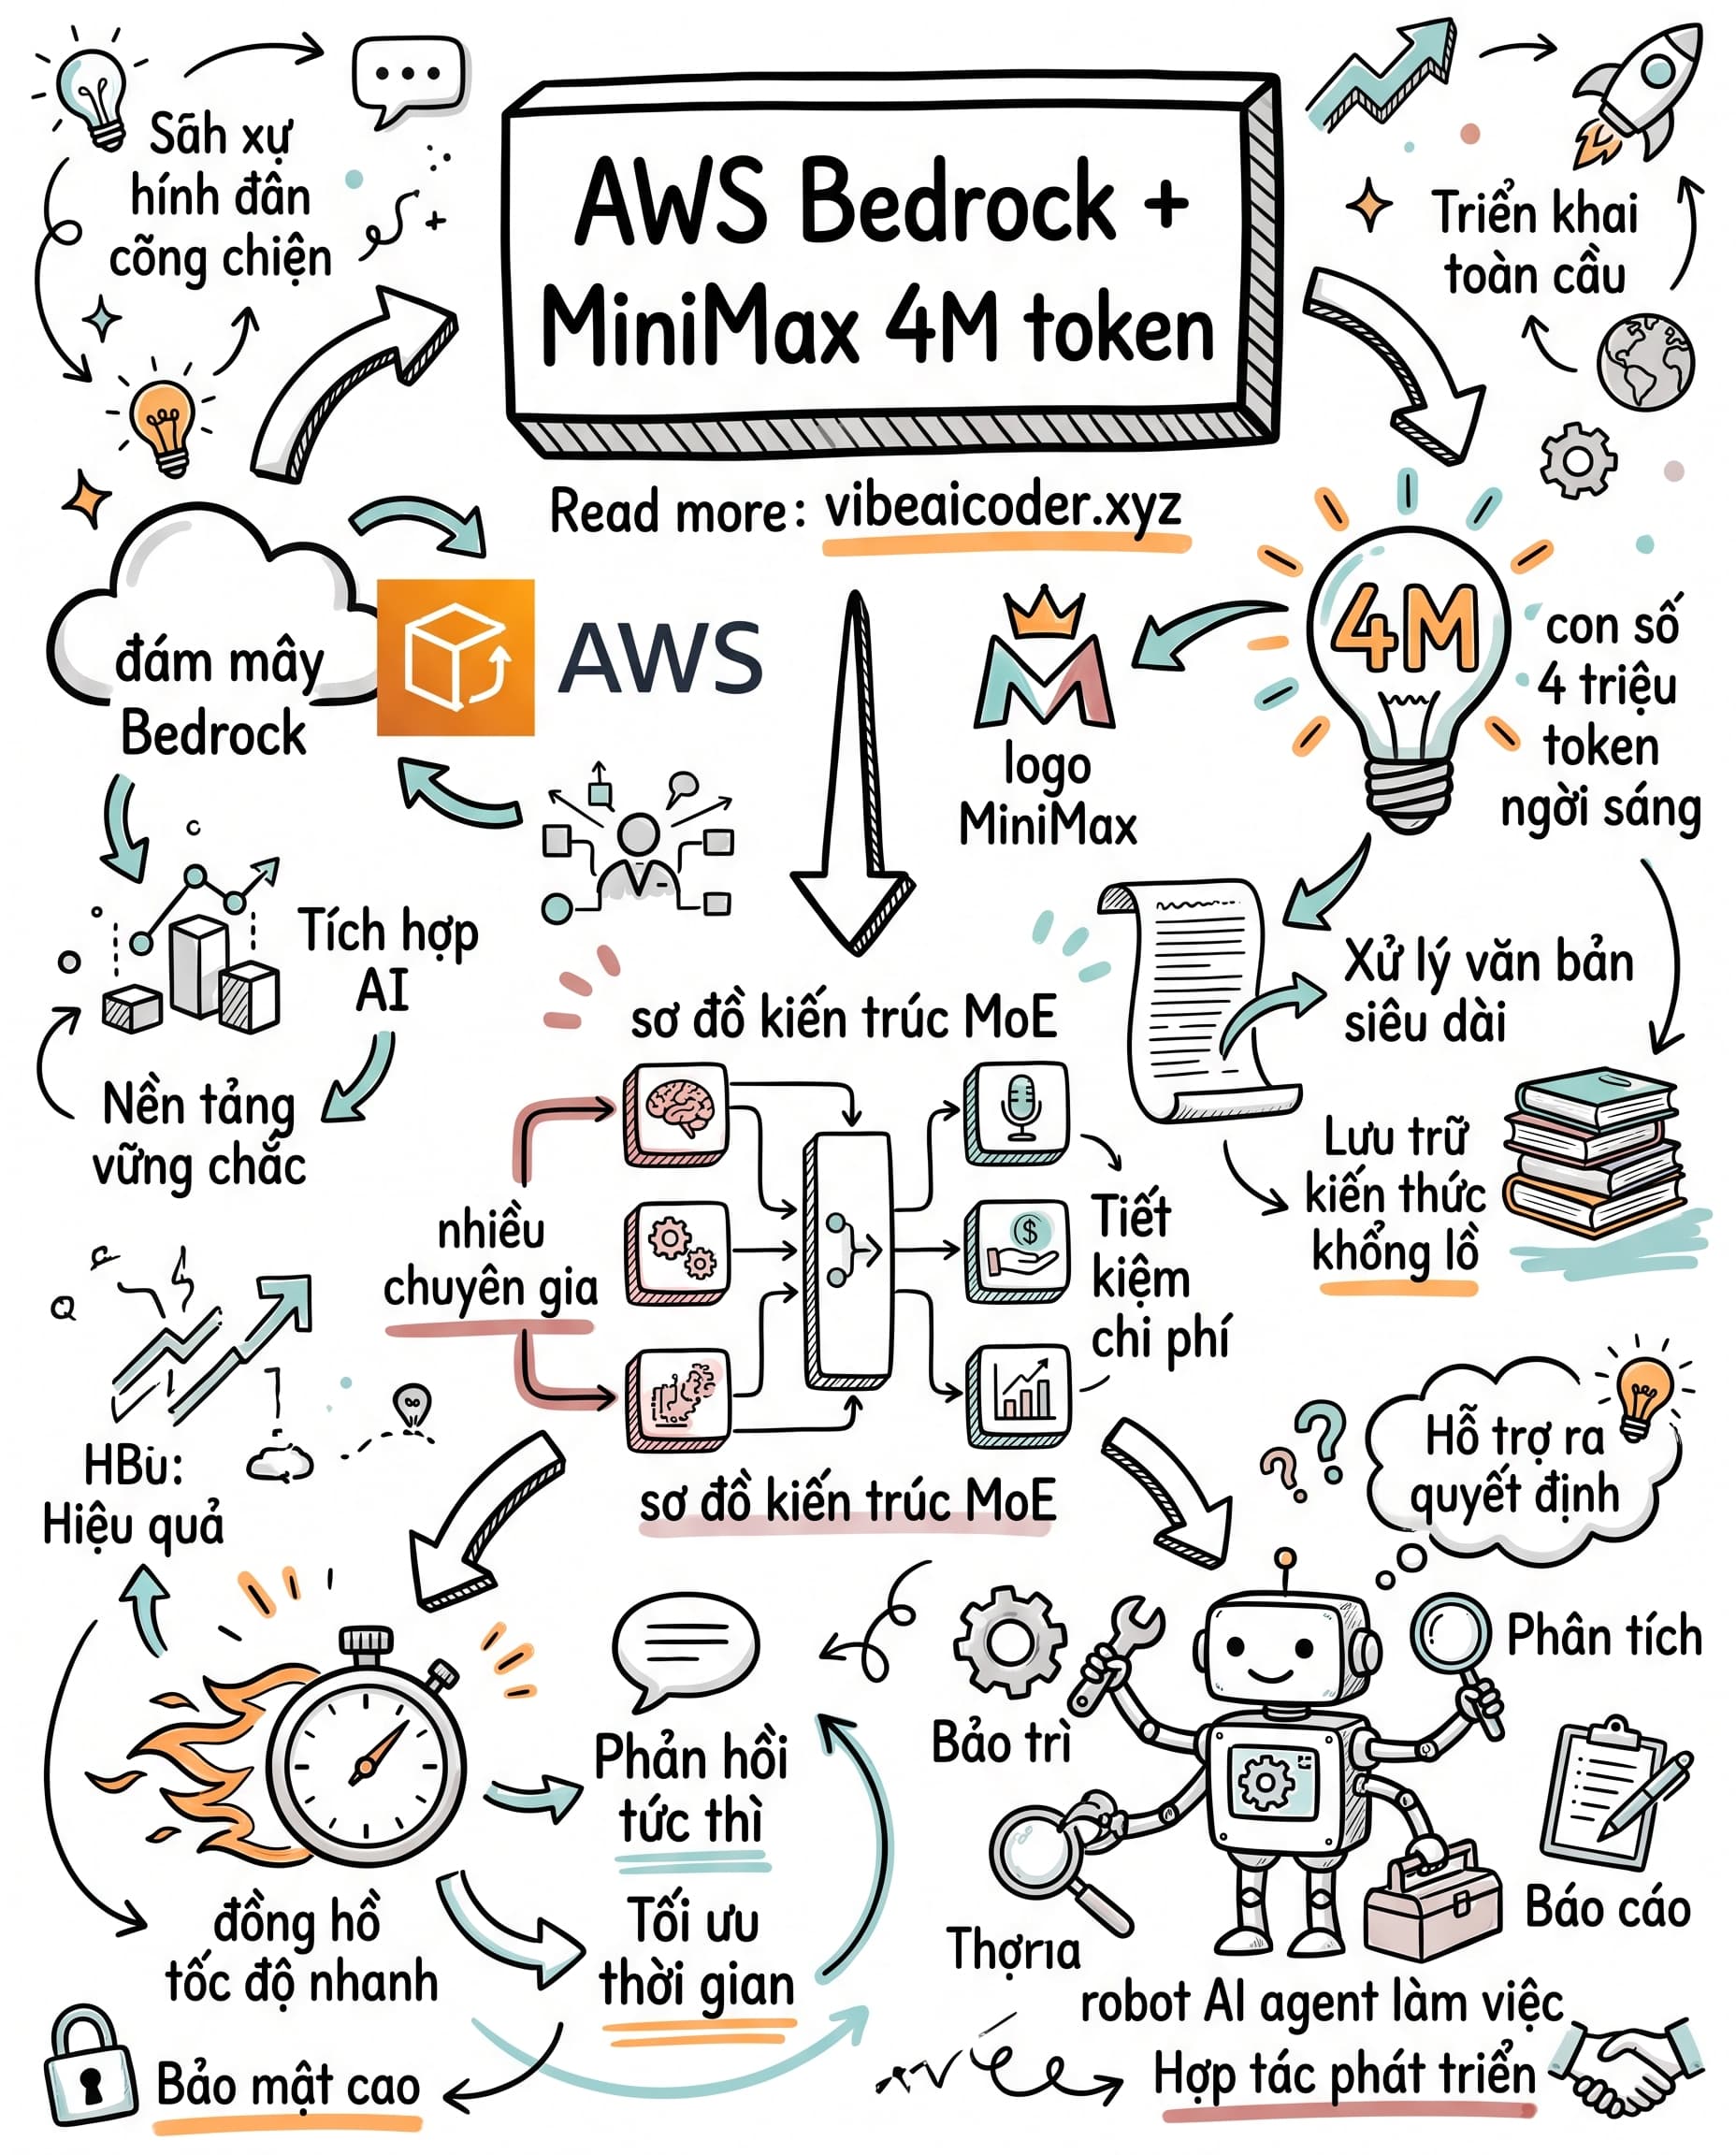
 AWS đưa MiniMax vào Bedrock, ngữ cảnh 4 triệu token cho AI agent
Amazon vừa âm thầm mở khóa một giới hạn mà dân build AI agent ghét nhất: bộ nhớ ngắn hạn quá bé.
 MiniMax là gì và tại sao AWS chọn nó
MiniMax là dòng model dùng kiến trúc Mixture of Experts (MoE), nghĩa là thay vì bắt một mạng nơ-ron khổng lồ xử lý mọi câu hỏi, hệ thống chỉ kích hoạt vài "chuyên gia" phù hợp nhất cho từng tác vụ. Kết quả là tốc độ phản hồi nhanh hơn mà chi phí tính toán vẫn thấp. AWS đưa model này vào Bedrock, nền tảng cho thuê model AI của Amazon, để khách hàng doanh nghiệp dùng trực tiếp không cần tự host.
 Ngữ cảnh 4 triệu token thay đổi được gì
Con số đáng chú ý nhất là cửa sổ ngữ cảnh 4 triệu token. Để dễ hình dung, một cuốn tiểu thuyết dài khoảng 100.000 từ chỉ chiếm chưa tới 150.000 token. Với 4 triệu token, một AI agent có thể nạp toàn bộ codebase của một dự án lớn, hàng chục tài liệu pháp lý, hoặc cả năm lịch sử chat với khách hàng vào một lần gọi duy nhất mà không cần cắt nhỏ hay tóm tắt trước.
 Ý nghĩa cho người xây dựng AI agent
Bộ nhớ ngắn hạn nhỏ từng buộc dev phải xây thêm lớp retrieval (tìm và nhét thông tin liên quan vào prompt) chỉ để né giới hạn token. Khi ngữ cảnh đủ lớn, nhiều tác vụ có thể bỏ qua bước này, agent đọc thẳng toàn bộ dữ liệu gốc và ra quyết định chính xác hơn. Đây cũng là lý do MoE đang trở thành lựa chọn mặc định cho các model muốn vừa nhanh vừa rẻ ở quy mô lớn.
Bạn đang build agent nào cần ngữ cảnh dài? Comment chia sẻ use case của bạn nhé!
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
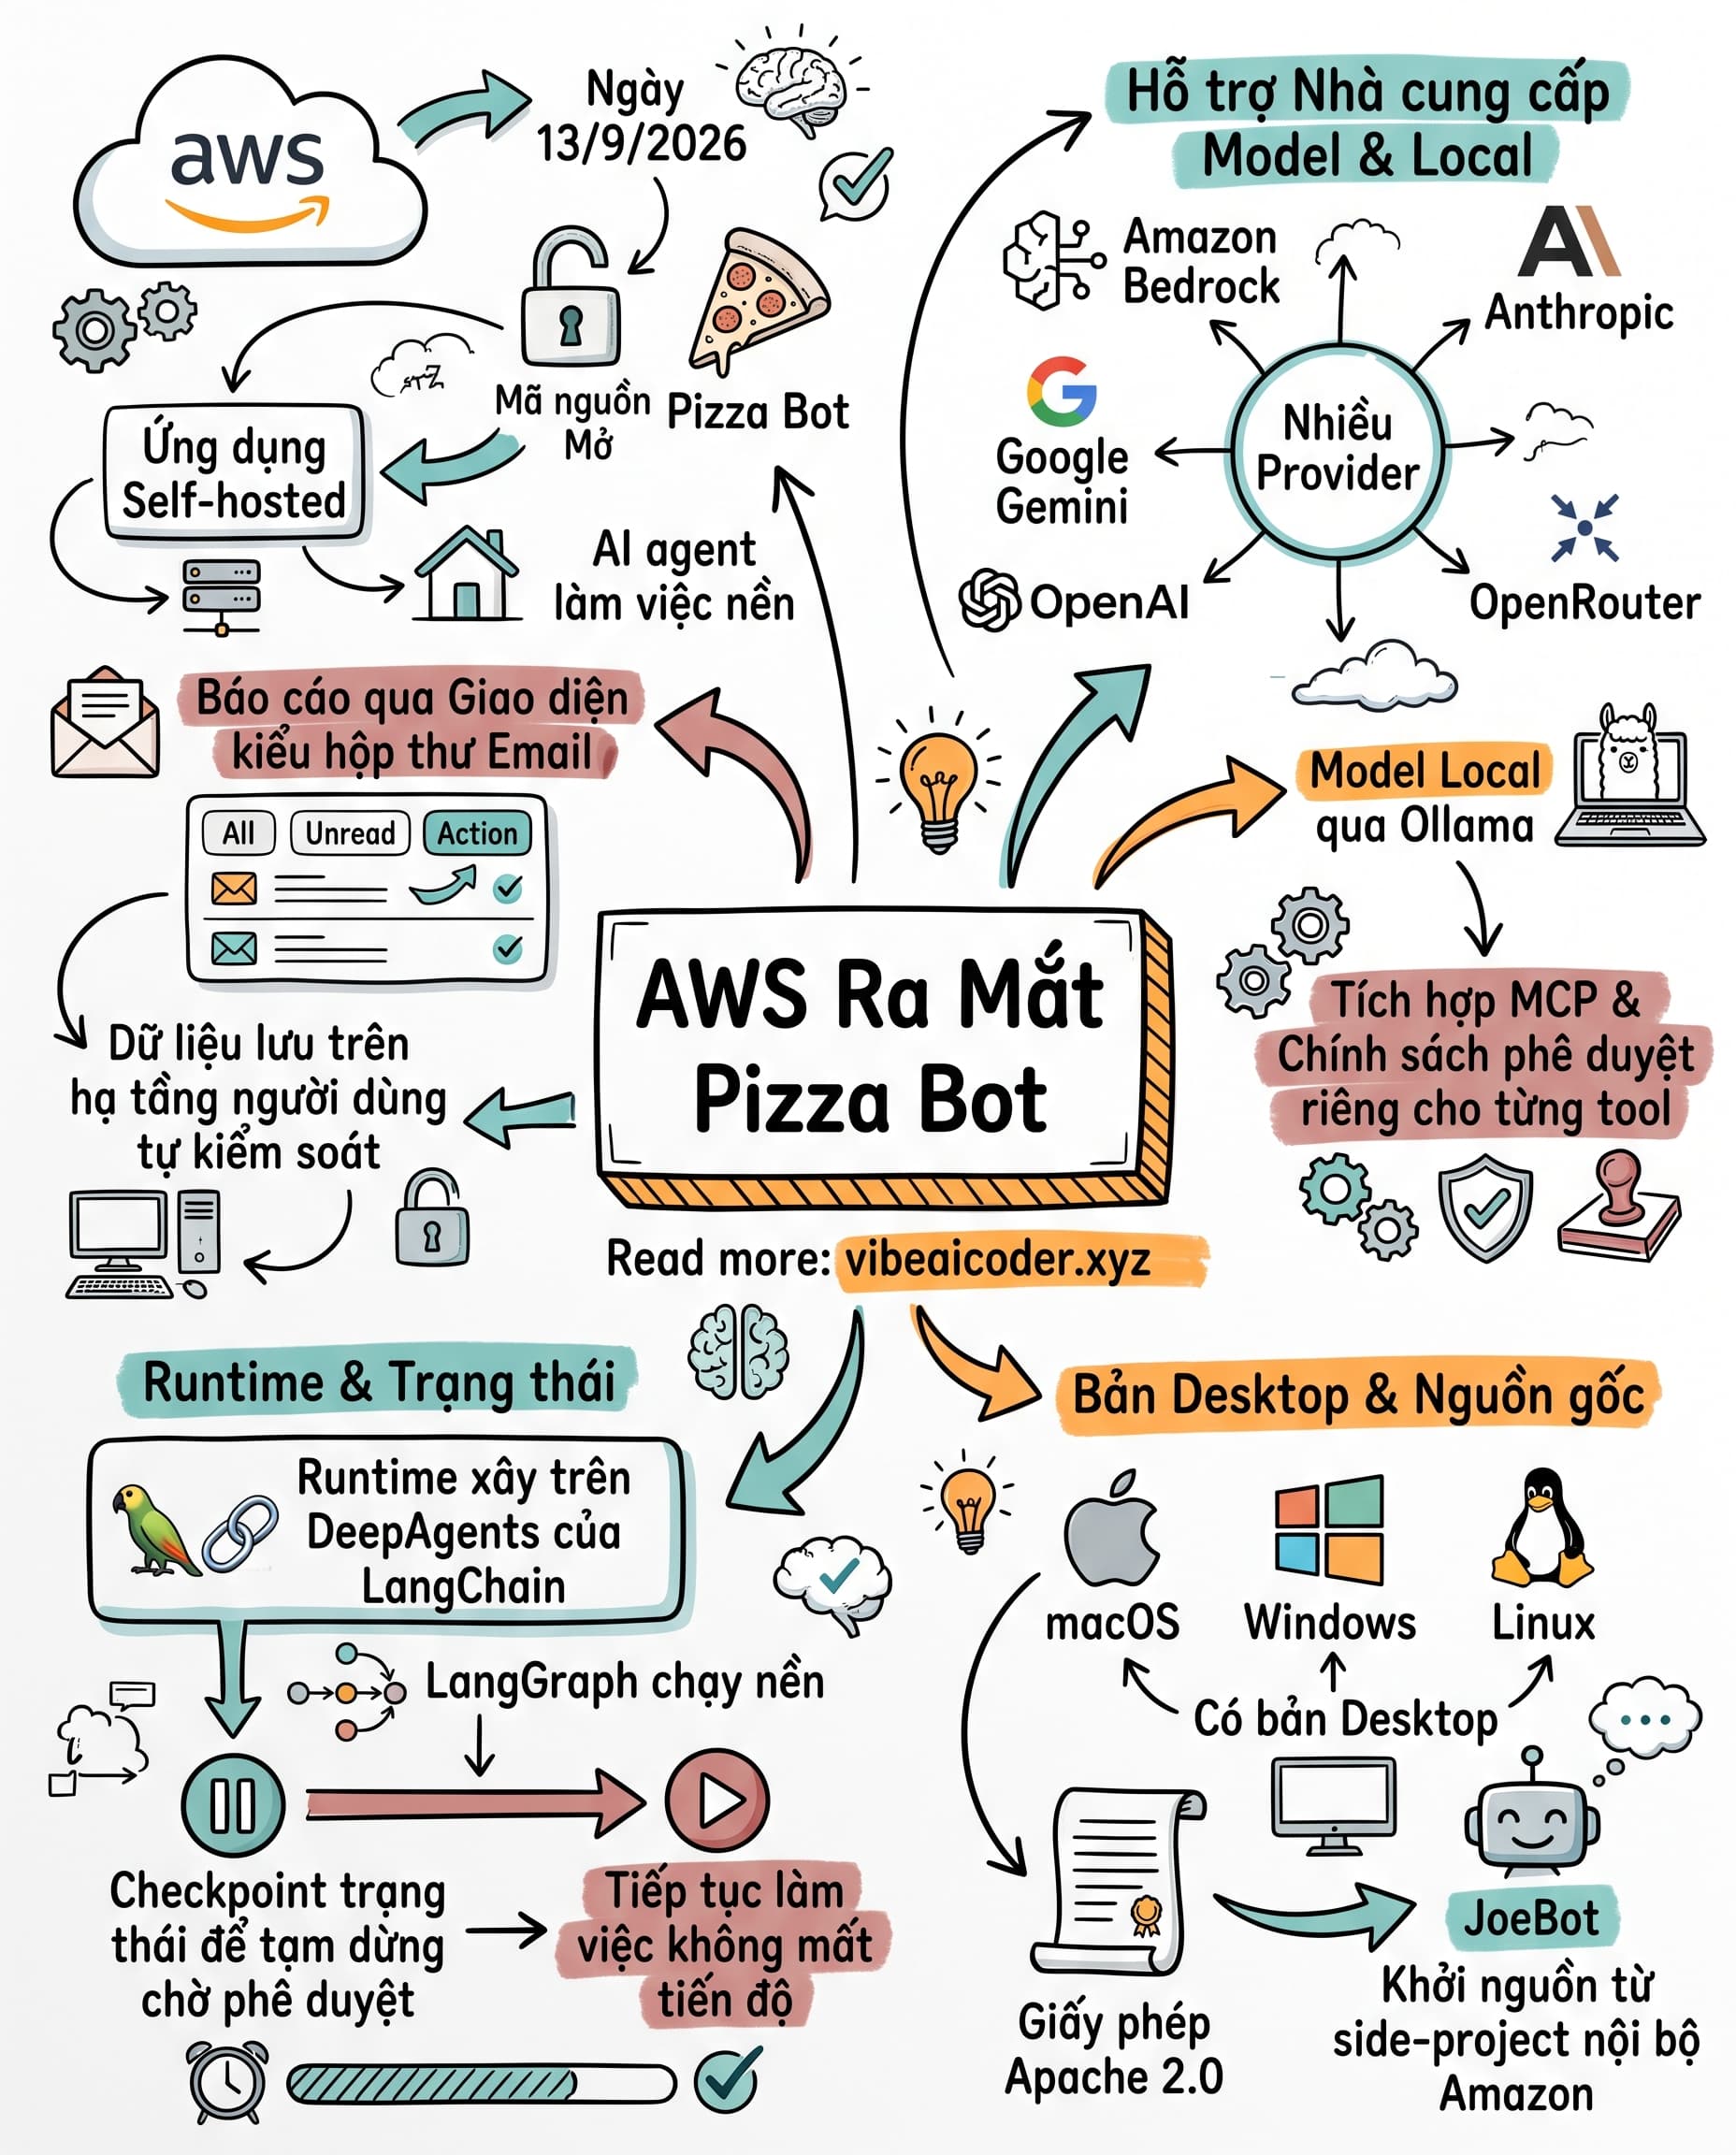
 AWS Mở Mã Nguồn Pizza Bot: AI Agent Làm Việc Nền Như Nhân Viên Thật
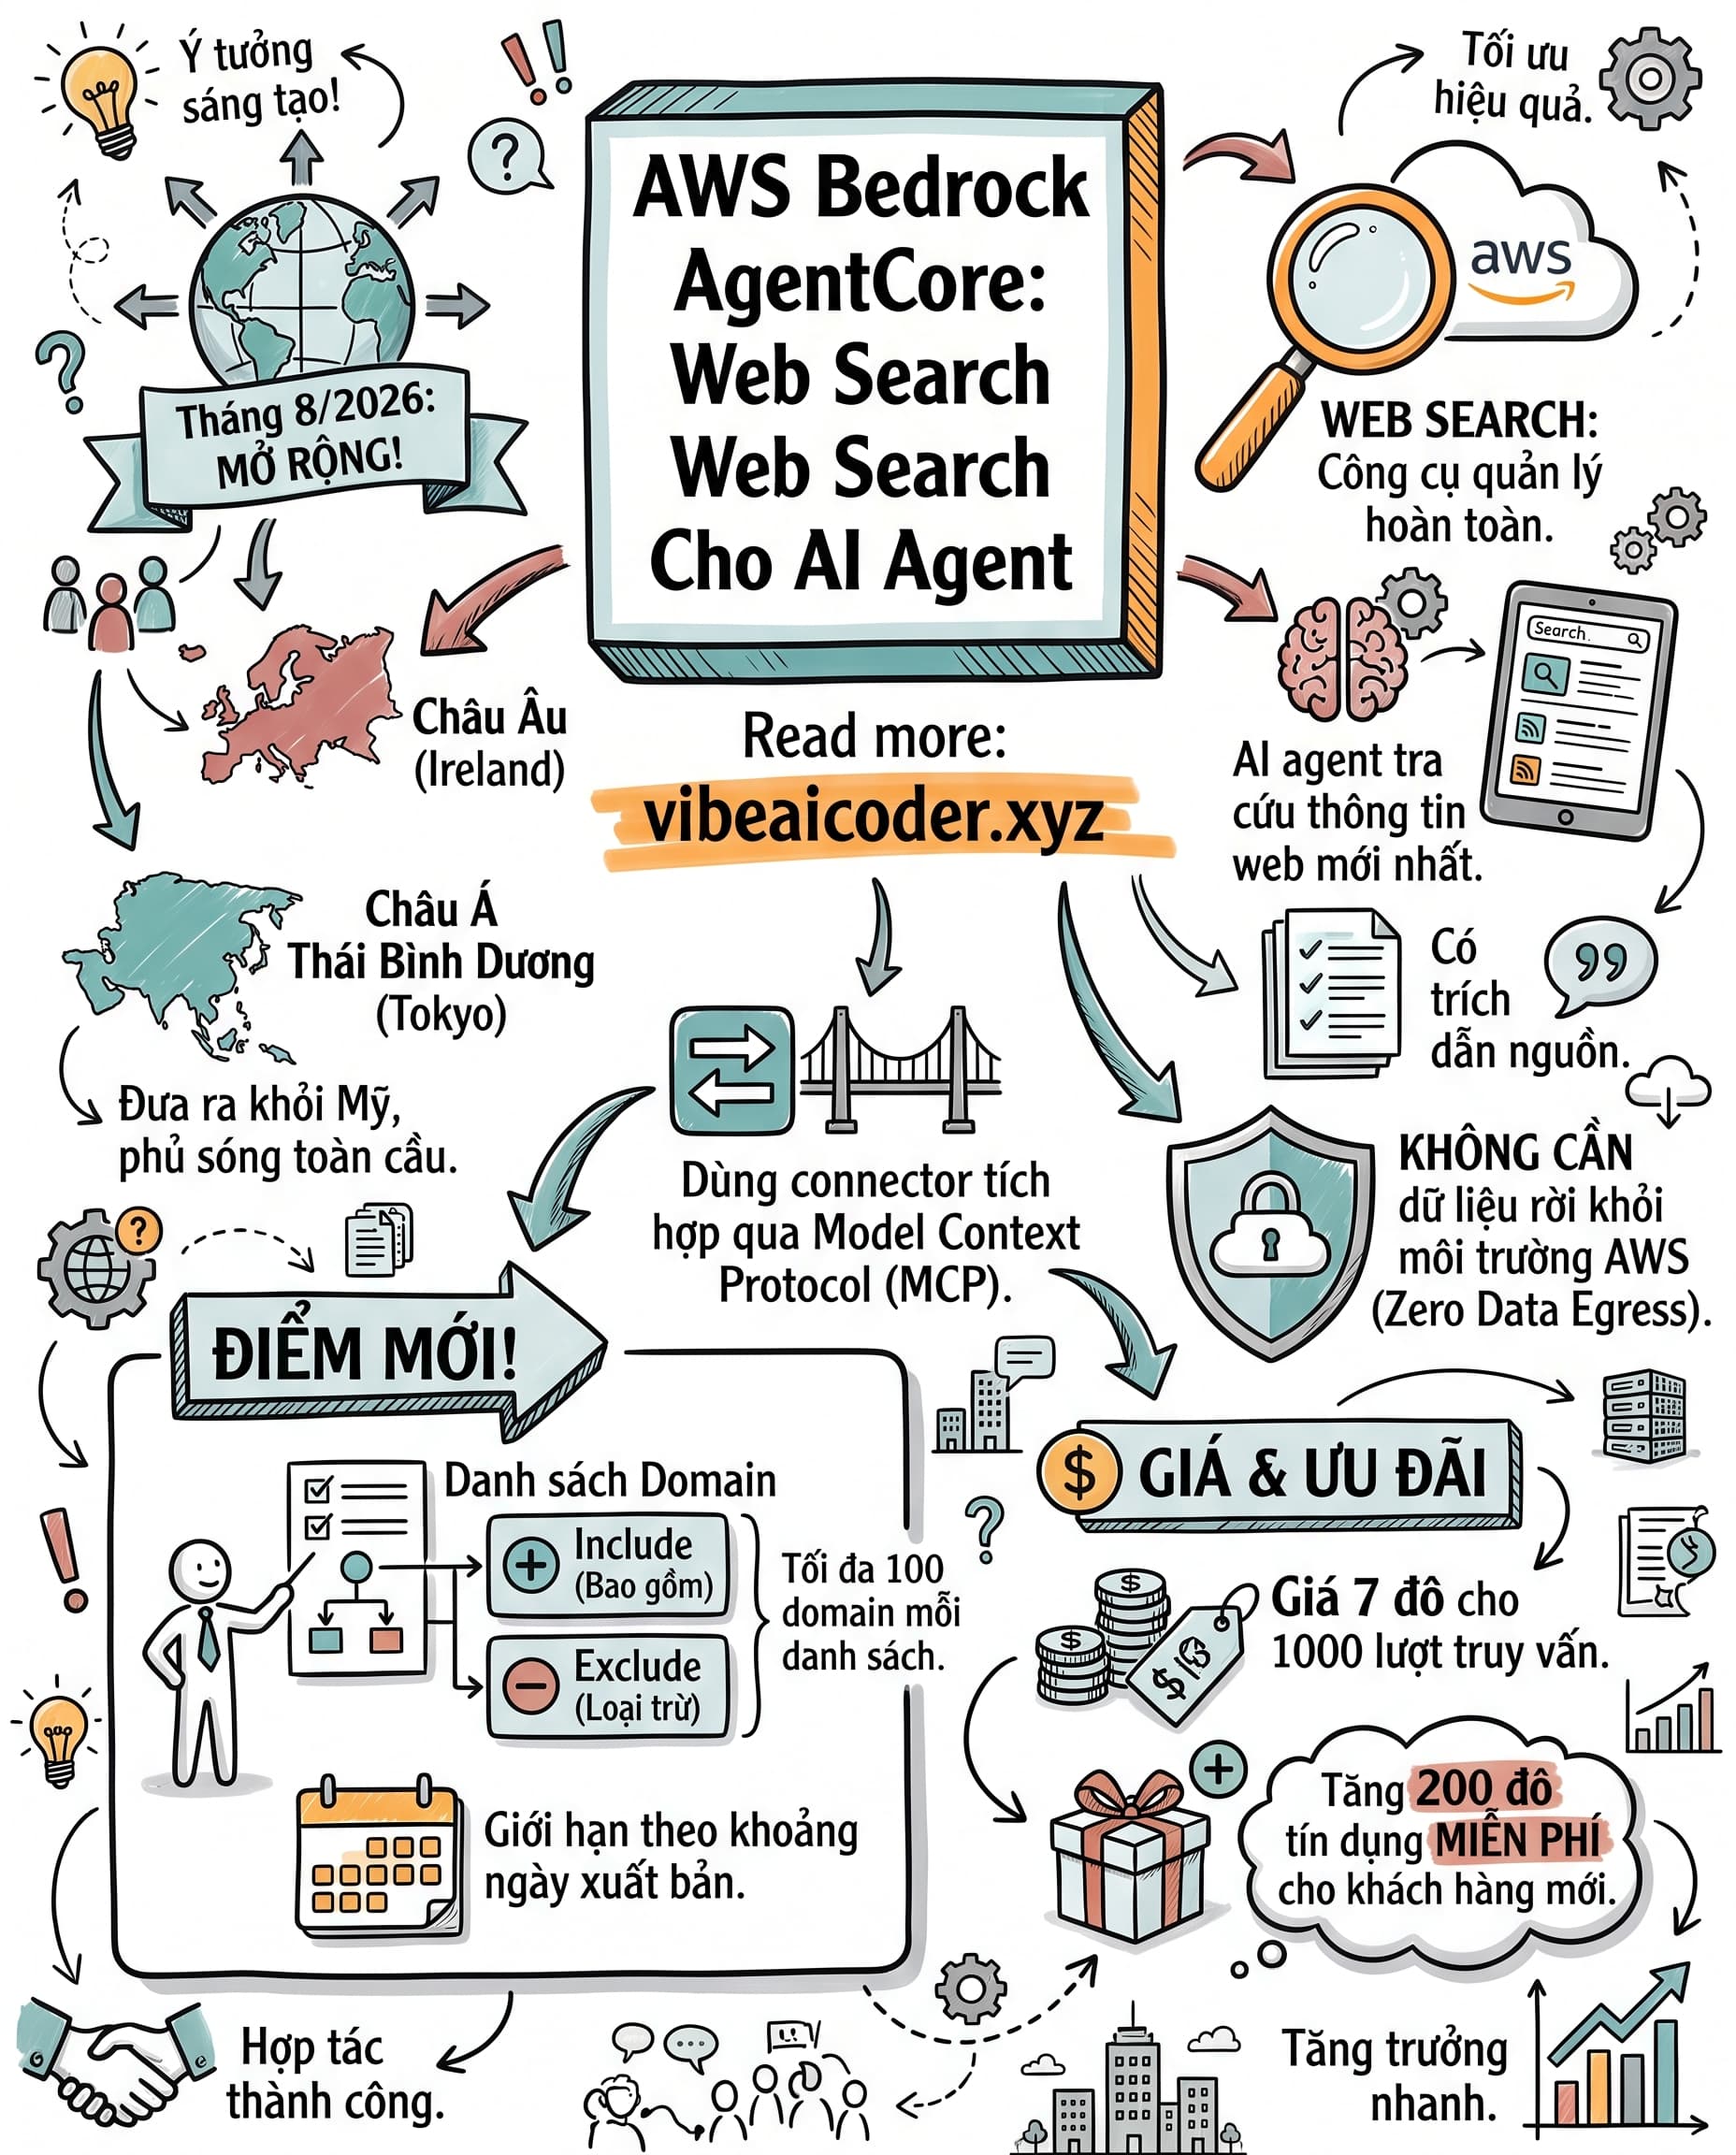
 AWS Mở Rộng Web Search Cho AI Agent Ra Khắp Châu Âu Và Châu Á
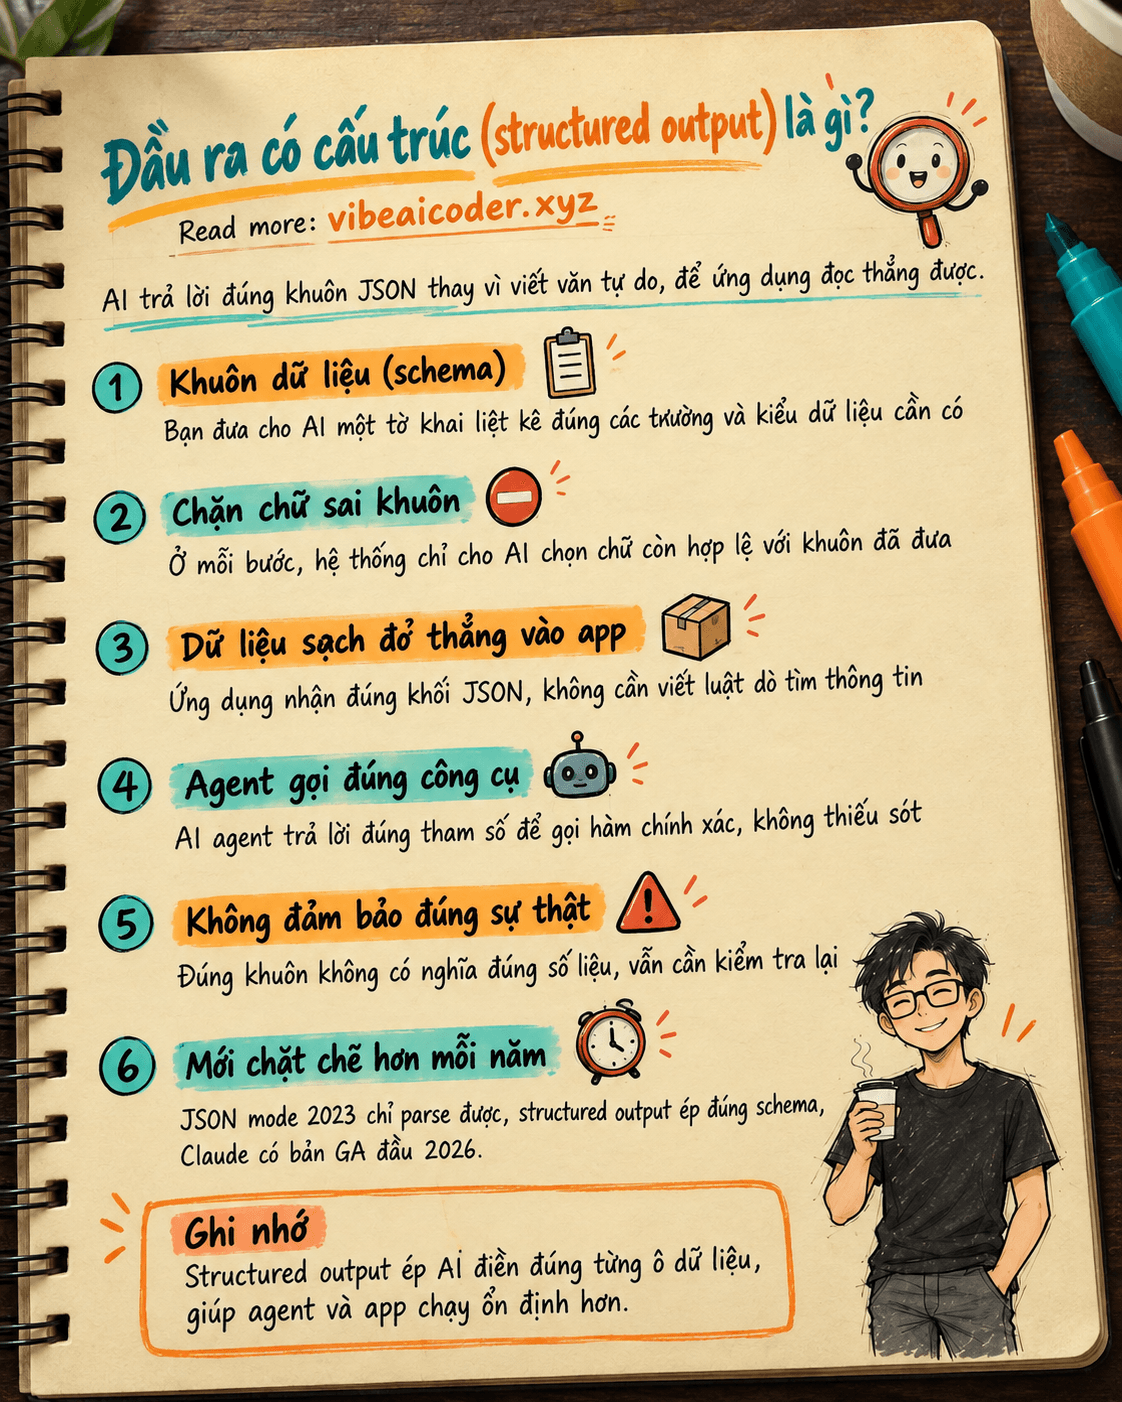
 Đầu ra có cấu trúc (structured output) là gì? Vì sao AI có thể trả lời đúng khuôn mẫu bạn cần