 AI Agent Đọc Dữ Liệu Sinh Học Sai Nhiều Hơn Bạn Tưởng, Và Cách Sửa
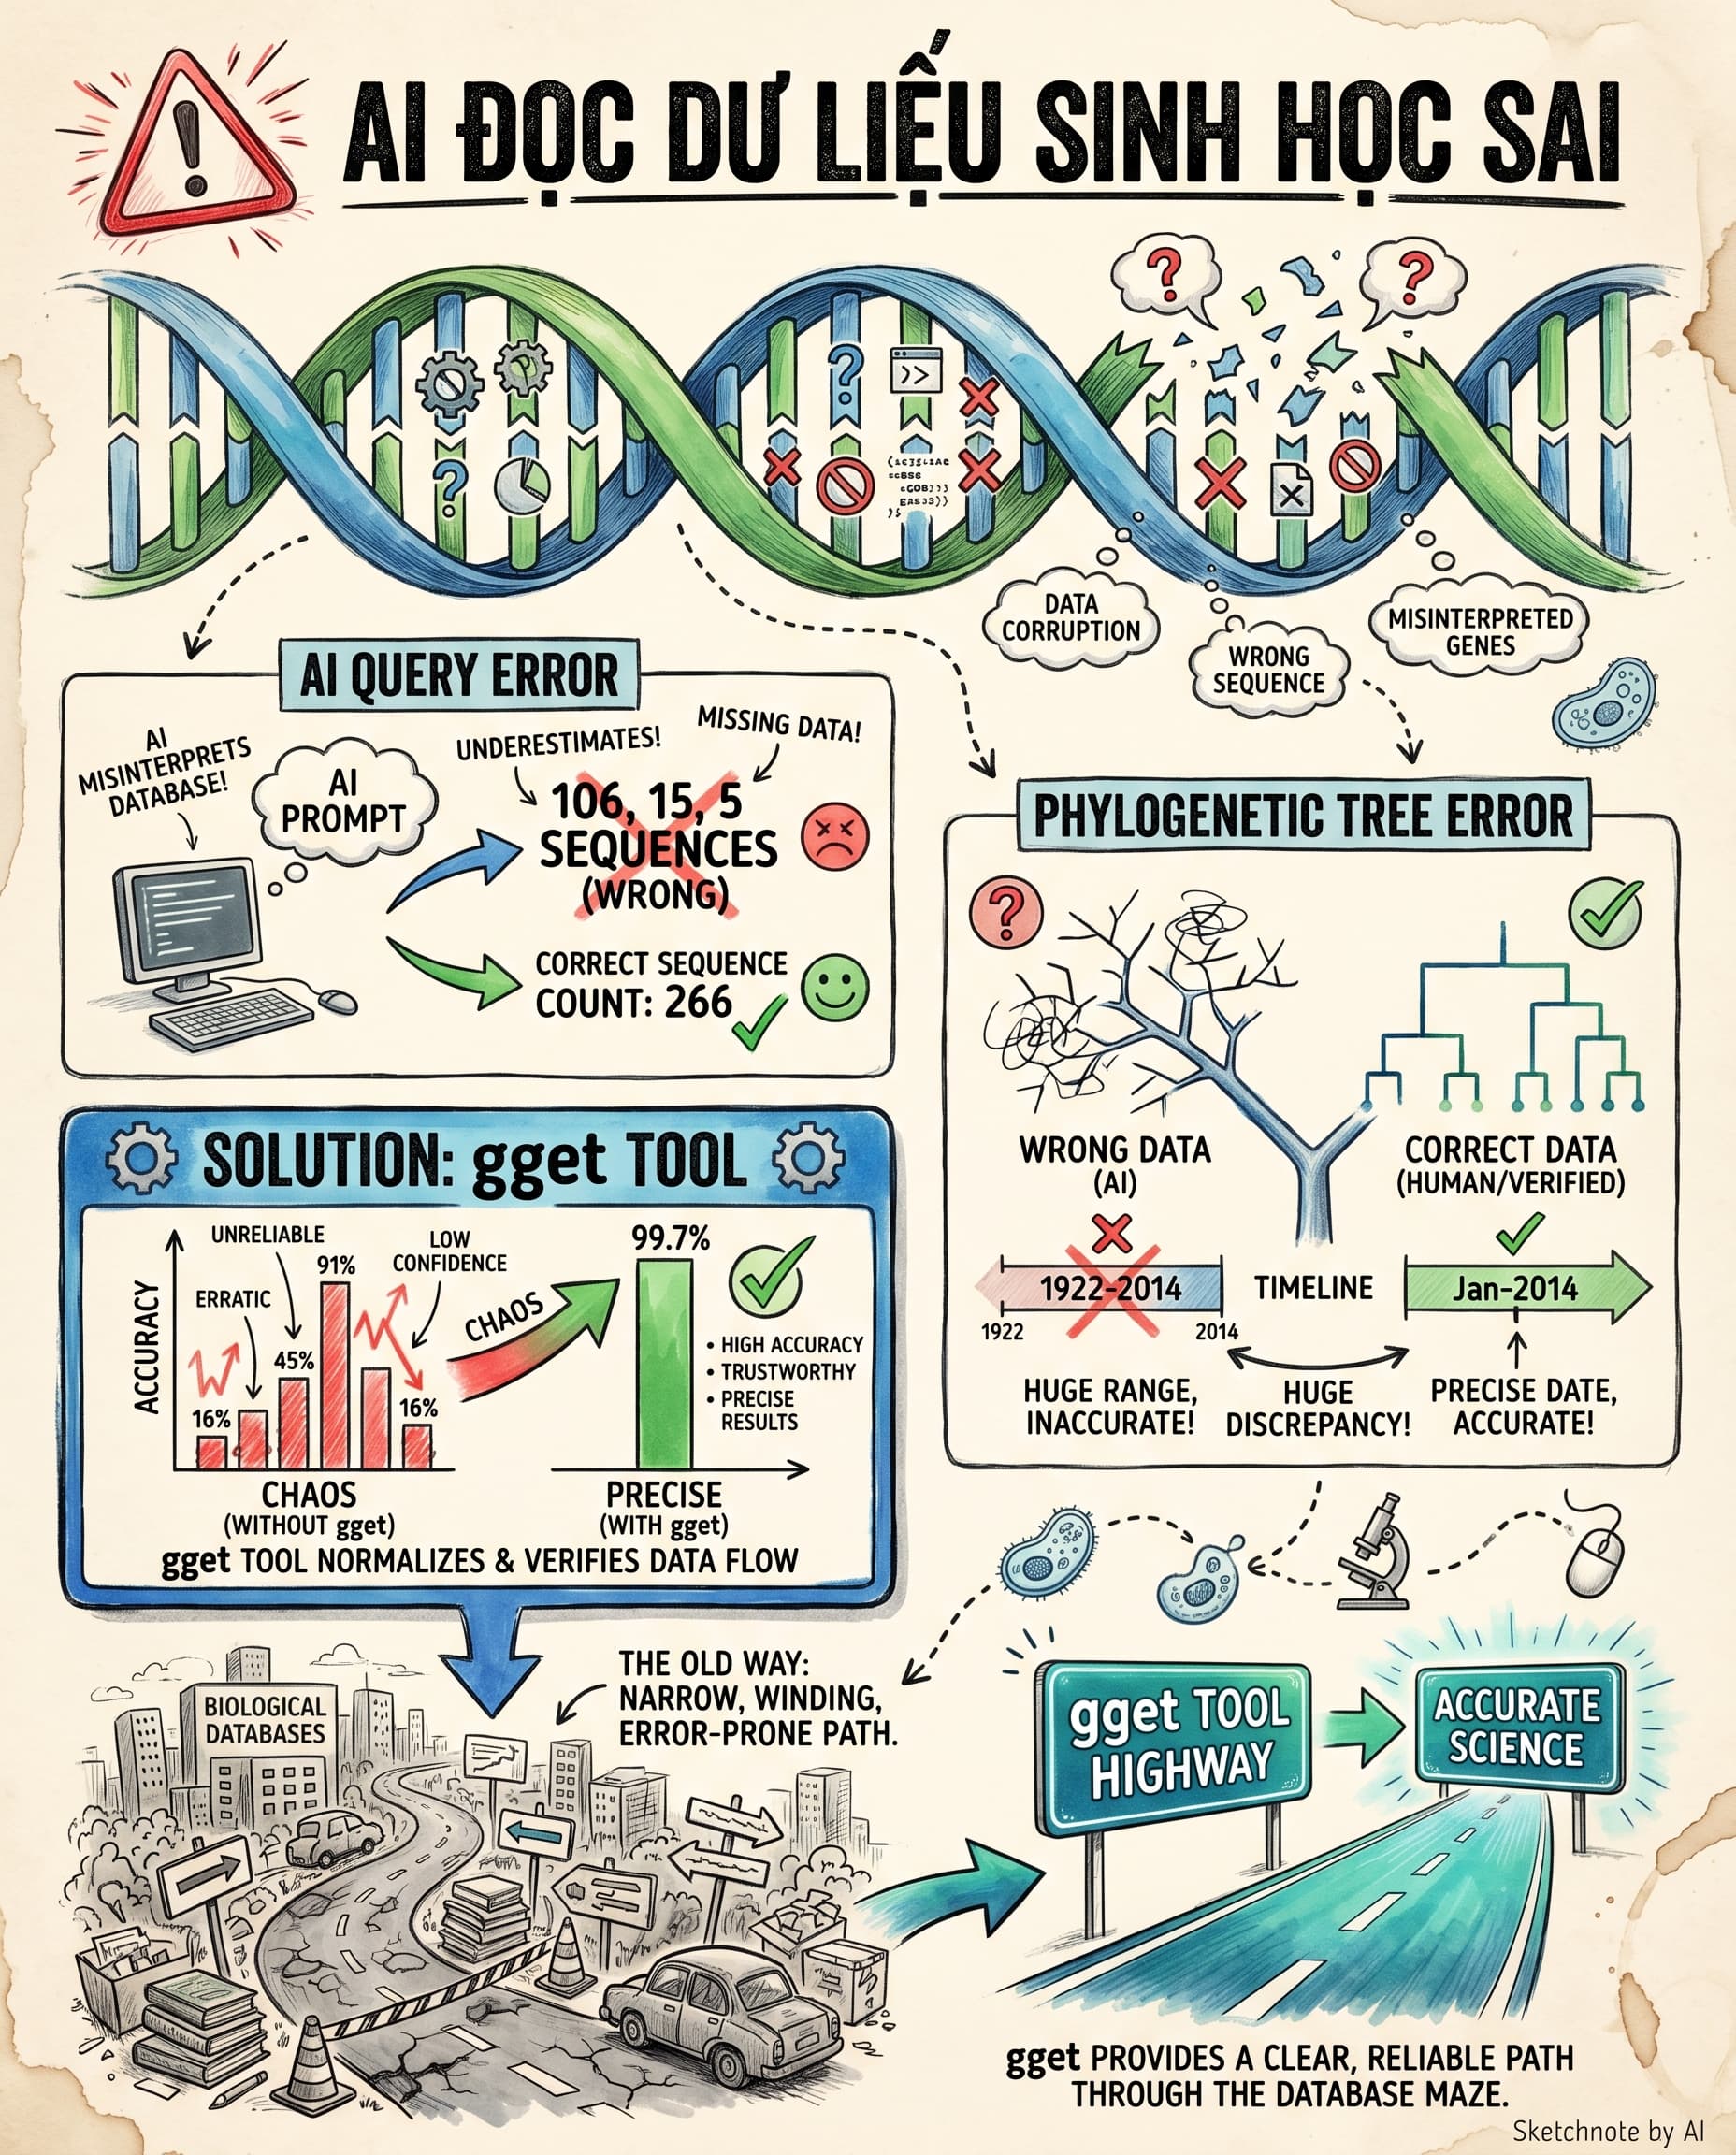
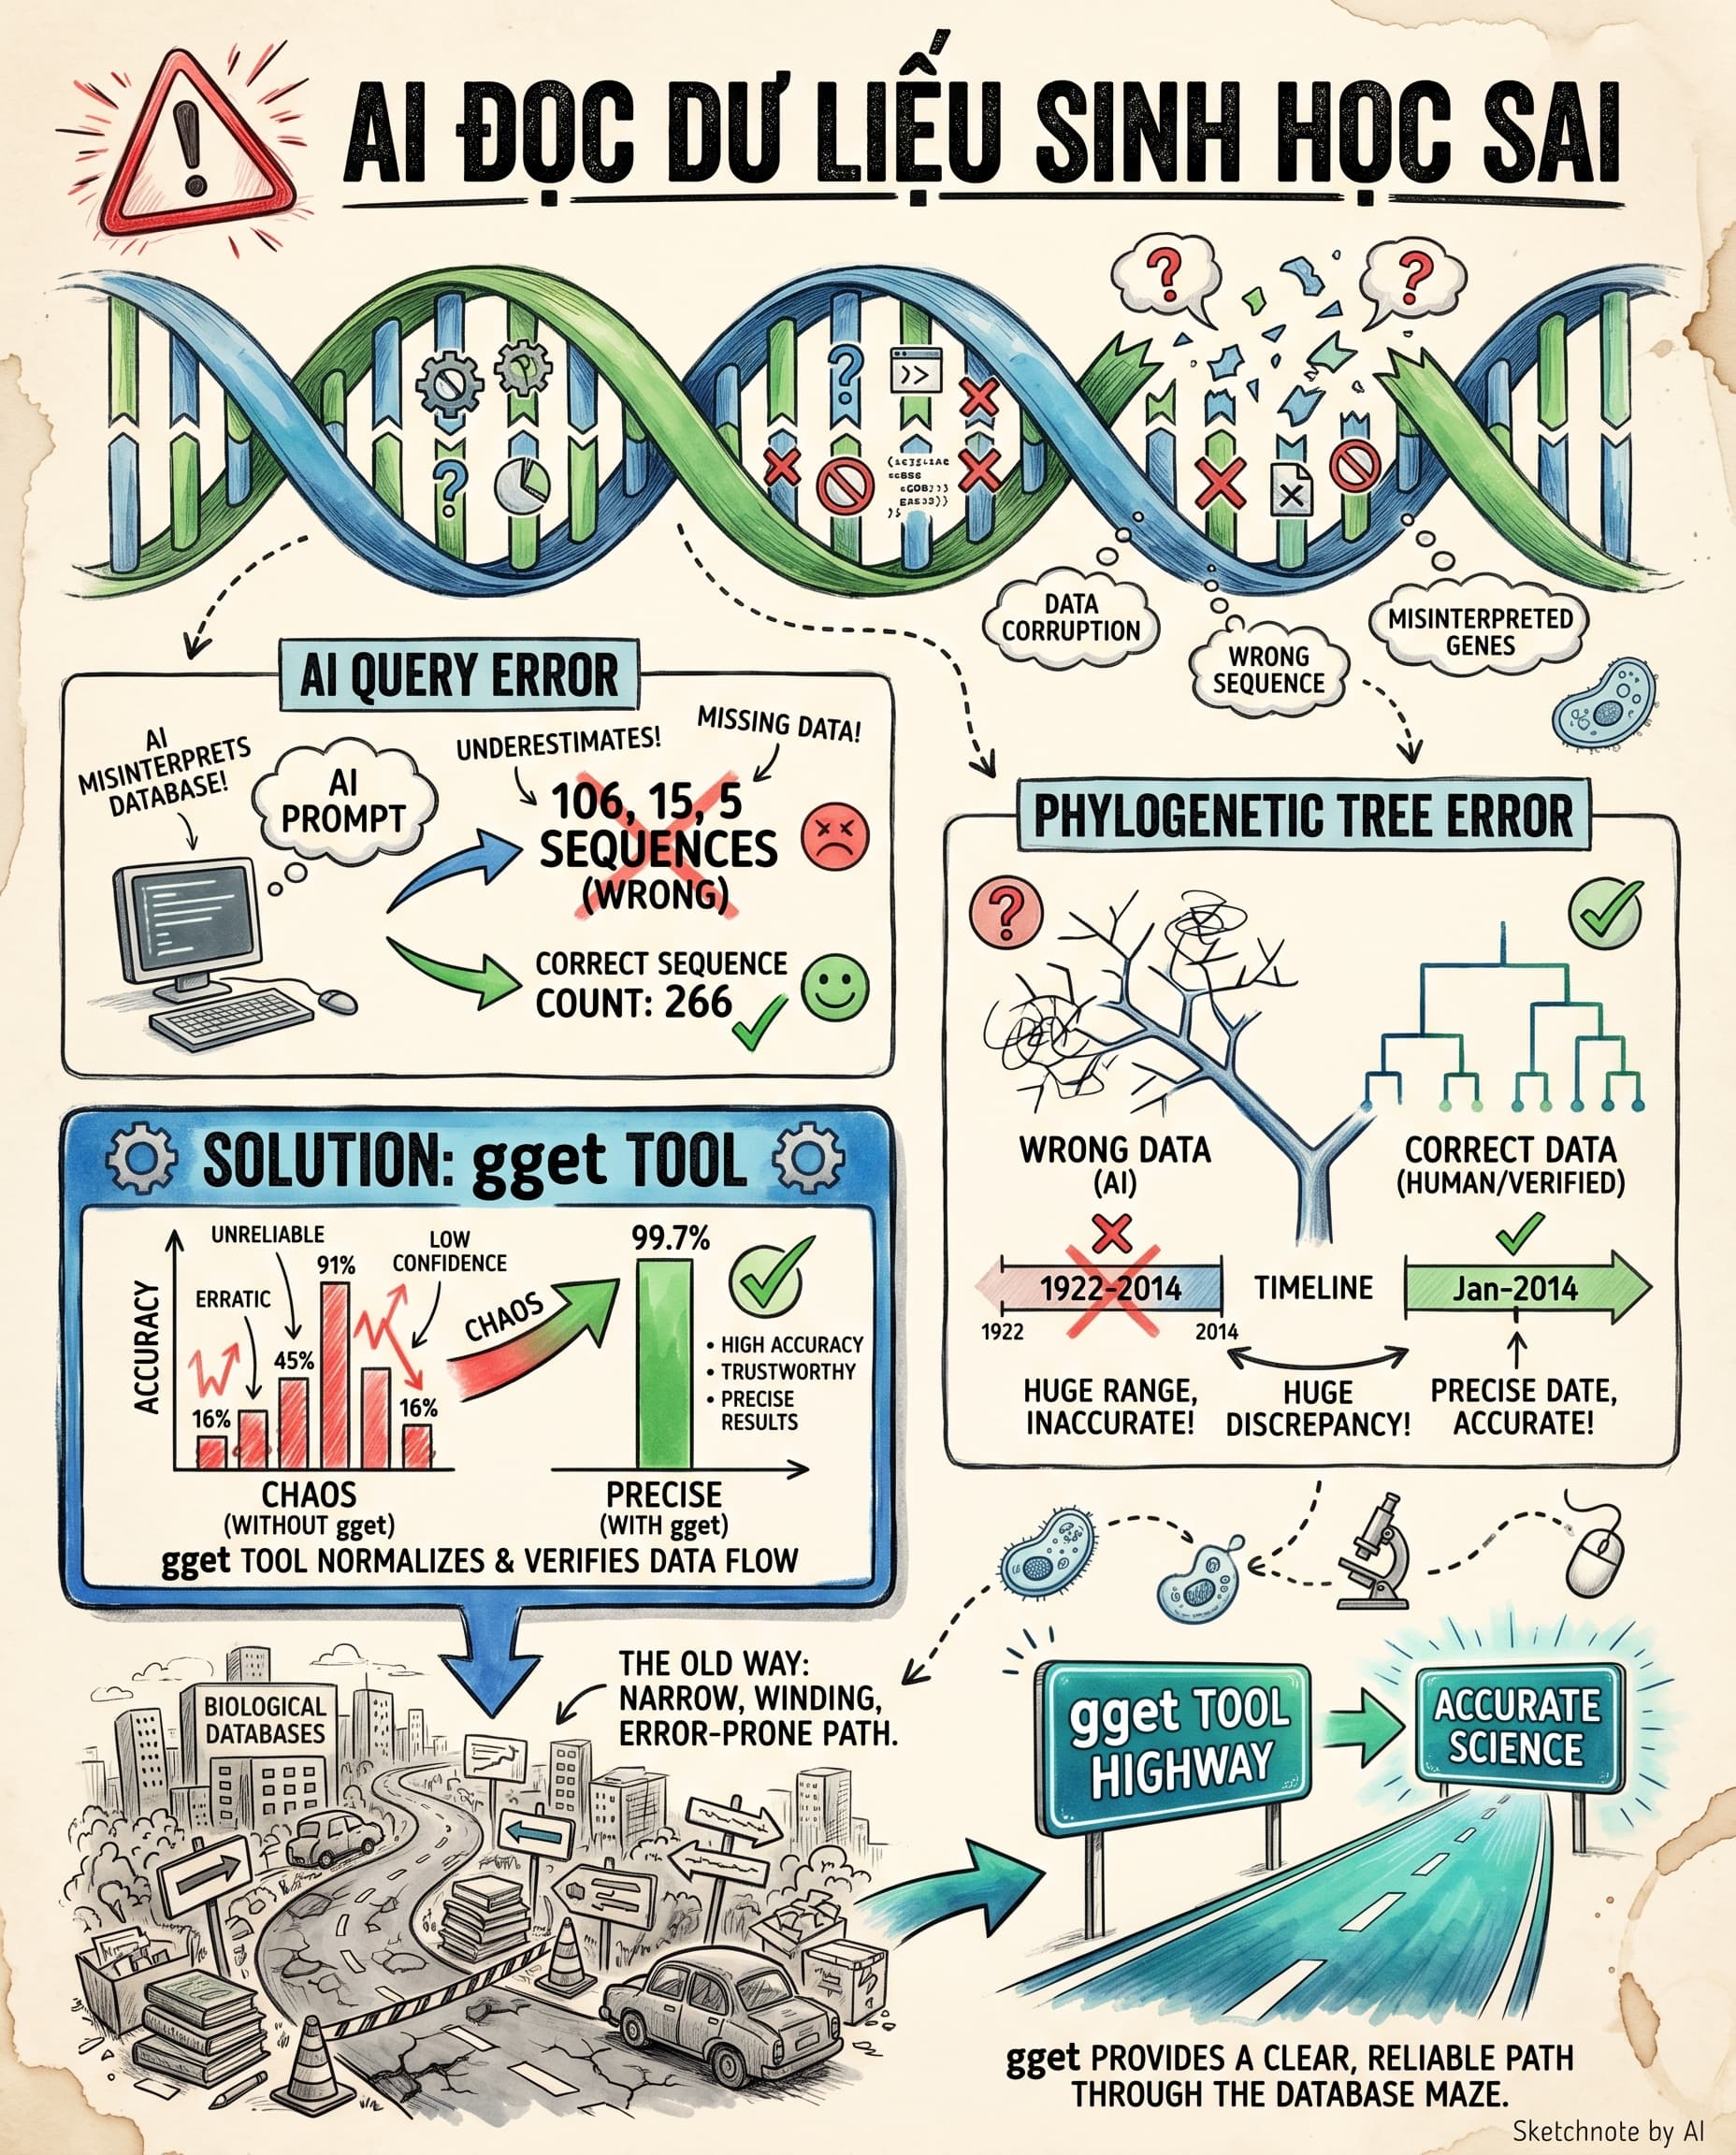
Cùng một câu hỏi, cùng một AI, nhưng lần trả về 106 chuỗi, lần trả về 15, lần chỉ còn 5. Đáp án đúng là 266. Đây không phải lỗi mô hình. Đây là vấn đề của cơ sở hạ tầng.
 Khi AI vào thế giới sinh học
Nghiên cứu từ Anthropic (tháng 6/2026) thử nghiệm bốn hệ thống AI trên VirBench, một bộ 120 truy vấn chuỗi virus đòi hỏi độ chính xác tuyệt đối. Kết quả? Tùy từng hệ thống, độ chính xác dao động từ 16,9% đến 91,3%.
Nhưng con số đó chưa phải phần đáng lo nhất. Phần đáng lo là tính ngẫu nhiên. Một agent, cùng câu hỏi, trả về ba kết quả khác nhau trong ba lần chạy. Với sinh học phân tử, sự không nhất quán đó kéo theo hậu quả thật sự. Cây phát sinh loài được xây từ dữ liệu sai cho kết quả nguồn gốc ổ dịch dao động từ năm 1922 đến tháng 4/2014. Đáp án đúng là tháng 1/2014.
 Cơ sở dữ liệu được xây cho con người, không phải máy
Vấn đề gốc rễ nằm ở thiết kế. Các cơ sở dữ liệu sinh học lớn như NCBI hay GISAID được xây dựng để con người duyệt, tìm, và đọc. Giao diện của chúng có logic ngầm mà người dùng học theo kinh nghiệm, biết cách lọc, biết khi nào nên bỏ qua kết quả trùng, biết cách đặt câu hỏi khác khi lần đầu không ra.
AI agent không có cái kiến thức ngầm đó. Nó đi vào những cơ sở dữ liệu đó như người lái xe trên hệ thống đường phố cũ, đầy ngõ hẹp và ngã rẽ không biển báo. Không phải xe kém, mà đường không thiết kế cho xe tốc độ cao.
 Giải pháp không phải là AI giỏi hơn
Nhóm nghiên cứu xây một công cụ tên gget virus, một lớp truy cập dữ liệu chuẩn hóa đặt giữa AI agent và các cơ sở dữ liệu sinh học. Công cụ này không làm AI thông minh hơn. Nó làm con đường sạch hơn.
Sau khi tích hợp gget virus, độ chính xác của tất cả bốn hệ thống vọt lên trên 90%. GPT-5.5 đạt 99,7%, gần như không còn biến động. Cùng một câu hỏi, cùng một AI, nhưng lần này kết quả ổn định và đúng.
Đây là bài học quan trọng trong kỷ nguyên agentic AI: vấn đề không luôn nằm ở mô hình. Đôi khi nó nằm ở môi trường mà mô hình đang hoạt động.
 Bài học rộng hơn cho AI trong khoa học
Sinh học không phải ngành duy nhất có vấn đề này. Bất kỳ lĩnh vực nào dùng cơ sở dữ liệu chuyên biệt, từ hóa học, y học đến pháp lý, đều có thể gặp cùng tình huống: AI agent thông minh nhưng dữ liệu đầu vào lộn xộn vì cơ sở hạ tầng chưa được thiết kế cho máy.
Câu hỏi đúng không phải là "mô hình nào tốt hơn?" mà là "đường ống dữ liệu có đáng tin không?" Nếu đầu vào không ổn định, đầu ra không thể đáng tin, dù mô hình có tốt đến đâu.
Deterministic tool layer, lớp công cụ truy cập xác định, đang nổi lên như một mảnh kiến trúc thiết yếu cho các hệ thống AI trong nghiên cứu khoa học nghiêm túc.
 Ứng dụng thực tế cho người xây AI
Nếu bạn đang xây agent kết nối với nguồn dữ liệu bên ngoài, một vài câu hỏi đáng đặt ngay hôm nay:
Nguồn dữ liệu đó có được thiết kế để máy truy cập không, hay nó chủ yếu cho con người đọc? Kết quả truy vấn có tái lập được không, tức là chạy hai lần ra cùng một kết quả? Và nếu kết quả thay đổi, hệ thống của bạn có phát hiện ra không?
Tính xác định trong truy cập dữ liệu không phải tính năng phụ. Với bất kỳ ứng dụng nào đòi hỏi độ chính xác, đó là nền móng.
Bạn đang xây agent nào kết nối với dữ liệu chuyên ngành? Đường ống của bạn có đủ ổn định chưa?
#VibeAICoder #AIresearch #bioinformatics #AgenticAI #khoahoc
Doanh nghiệp muốn giới thiệu sản phẩm AI tới bạn đọc Vibe AI Coder? Xem gói tài trợ
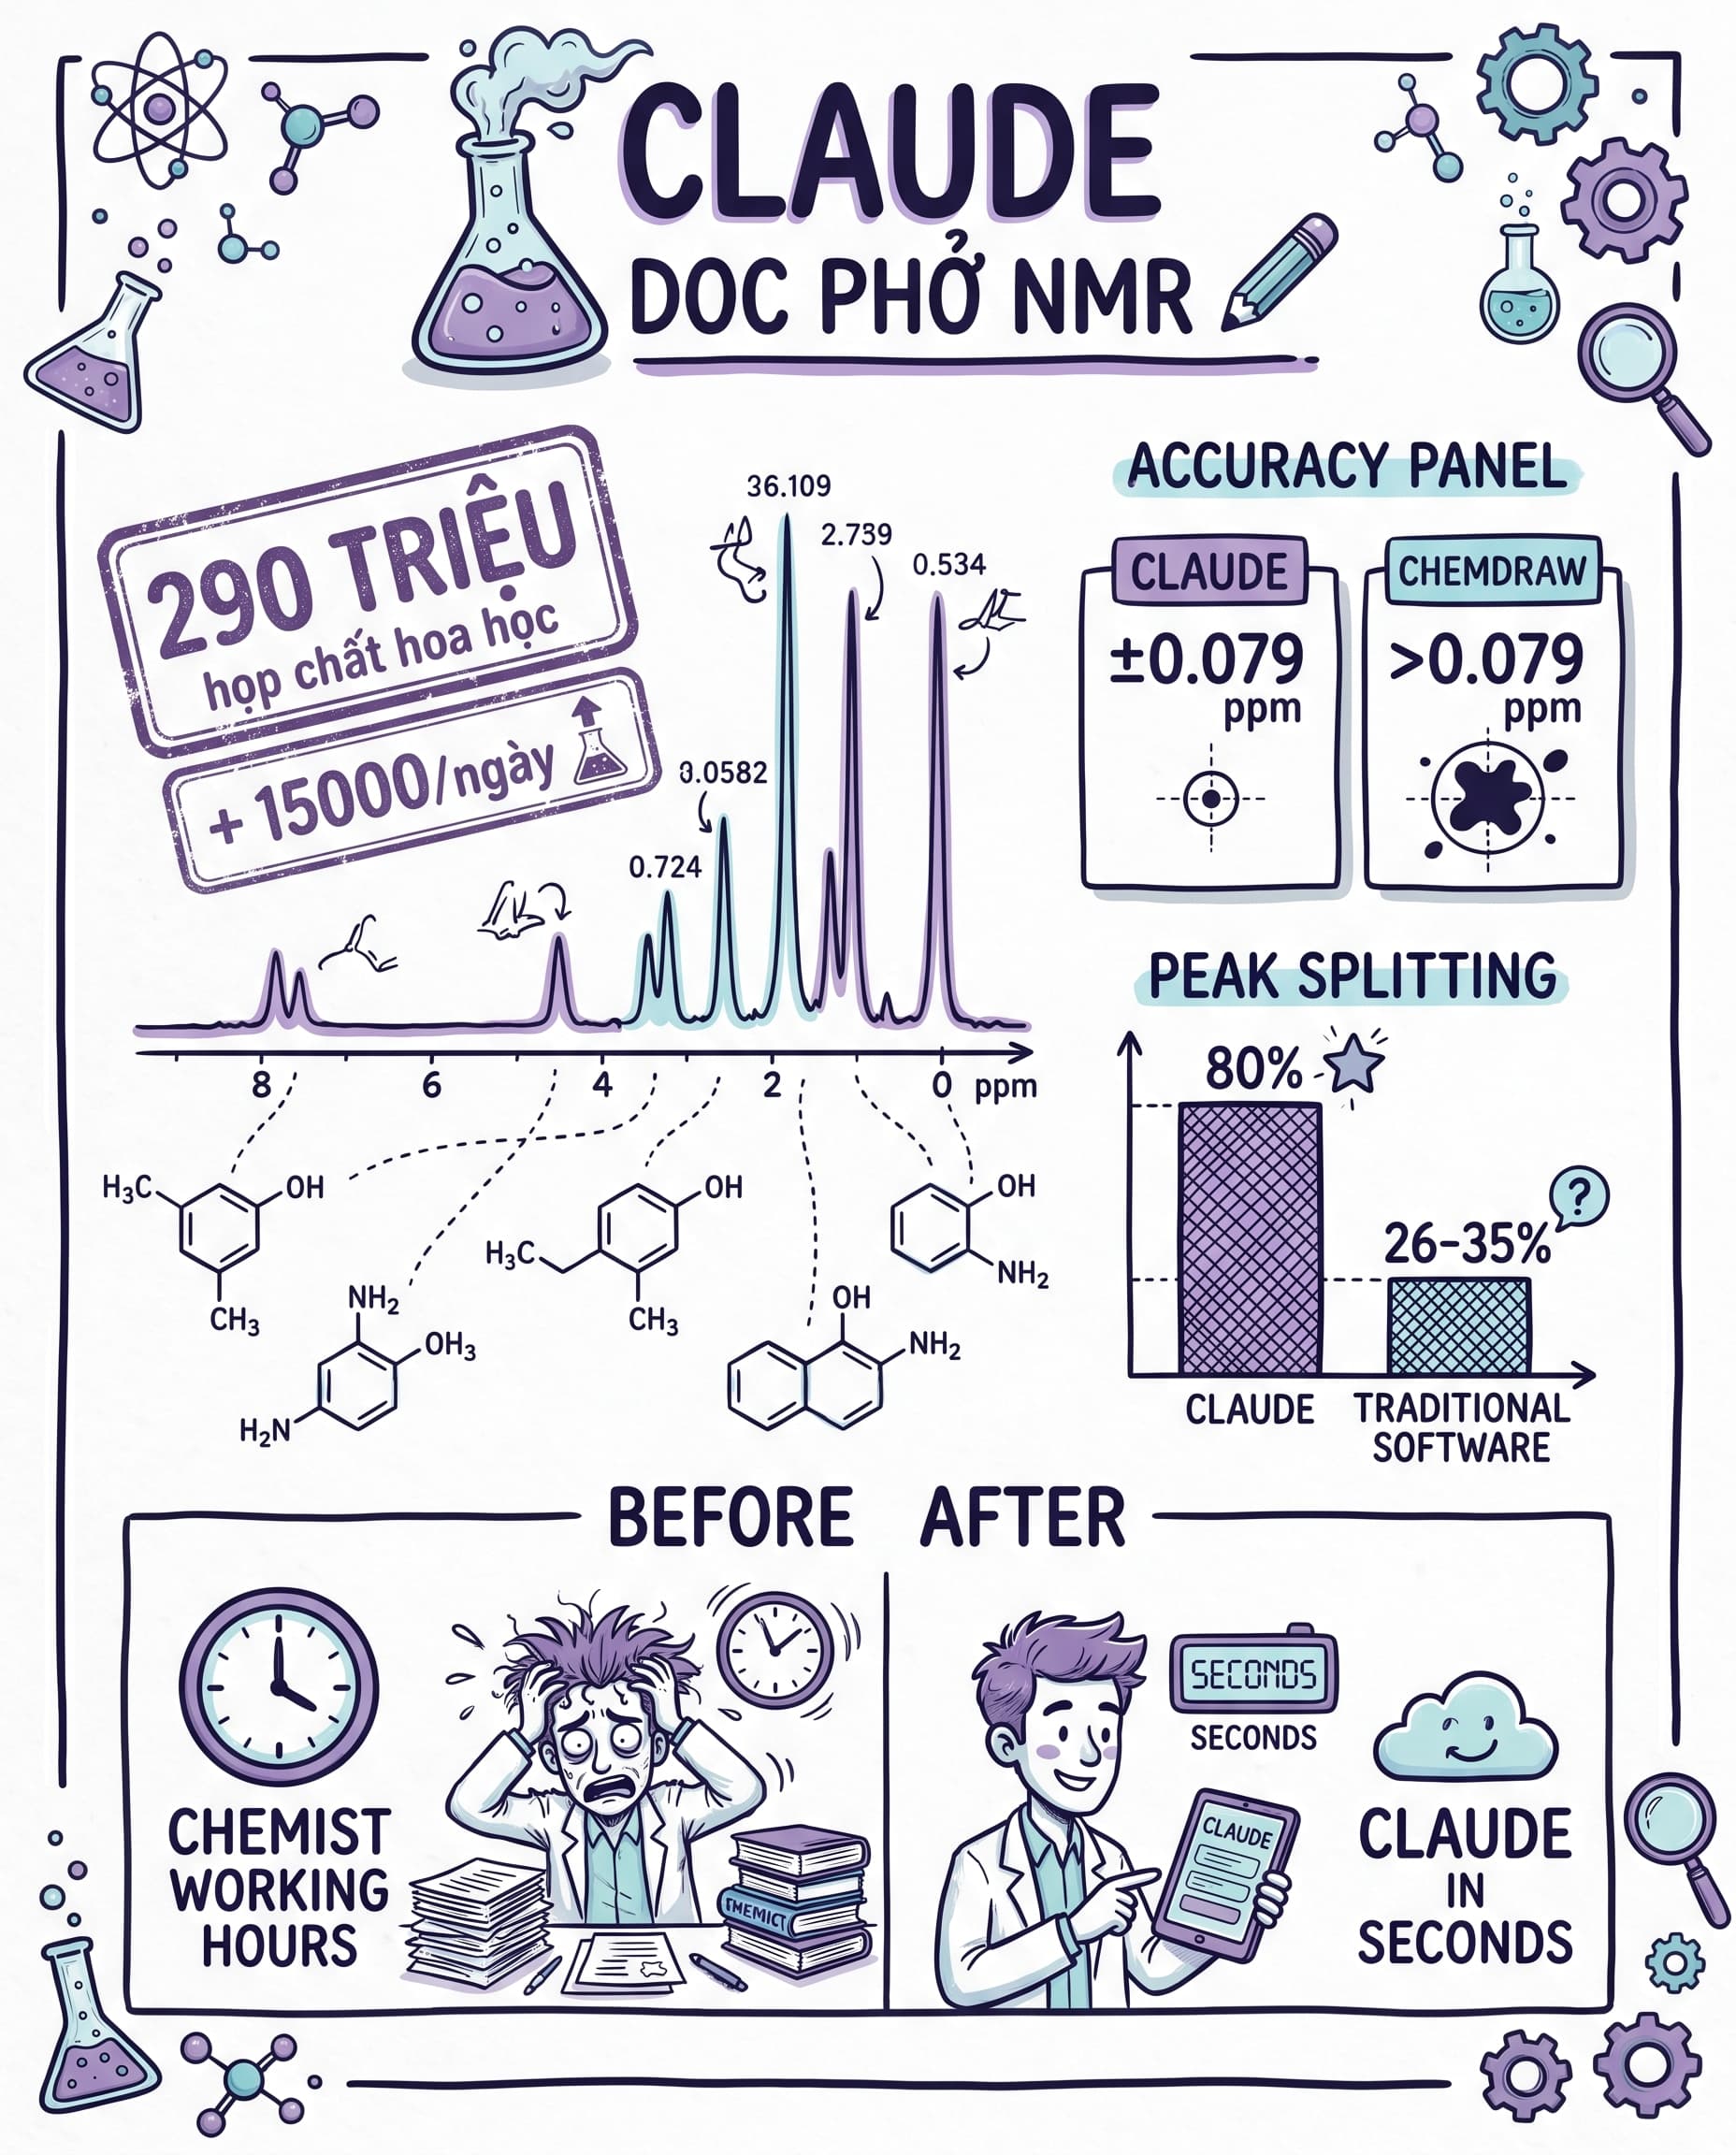
 290 Triệu Hợp Chất Hóa Học Và Lý Do Anthropic Dạy Claude Đọc Phổ NMR
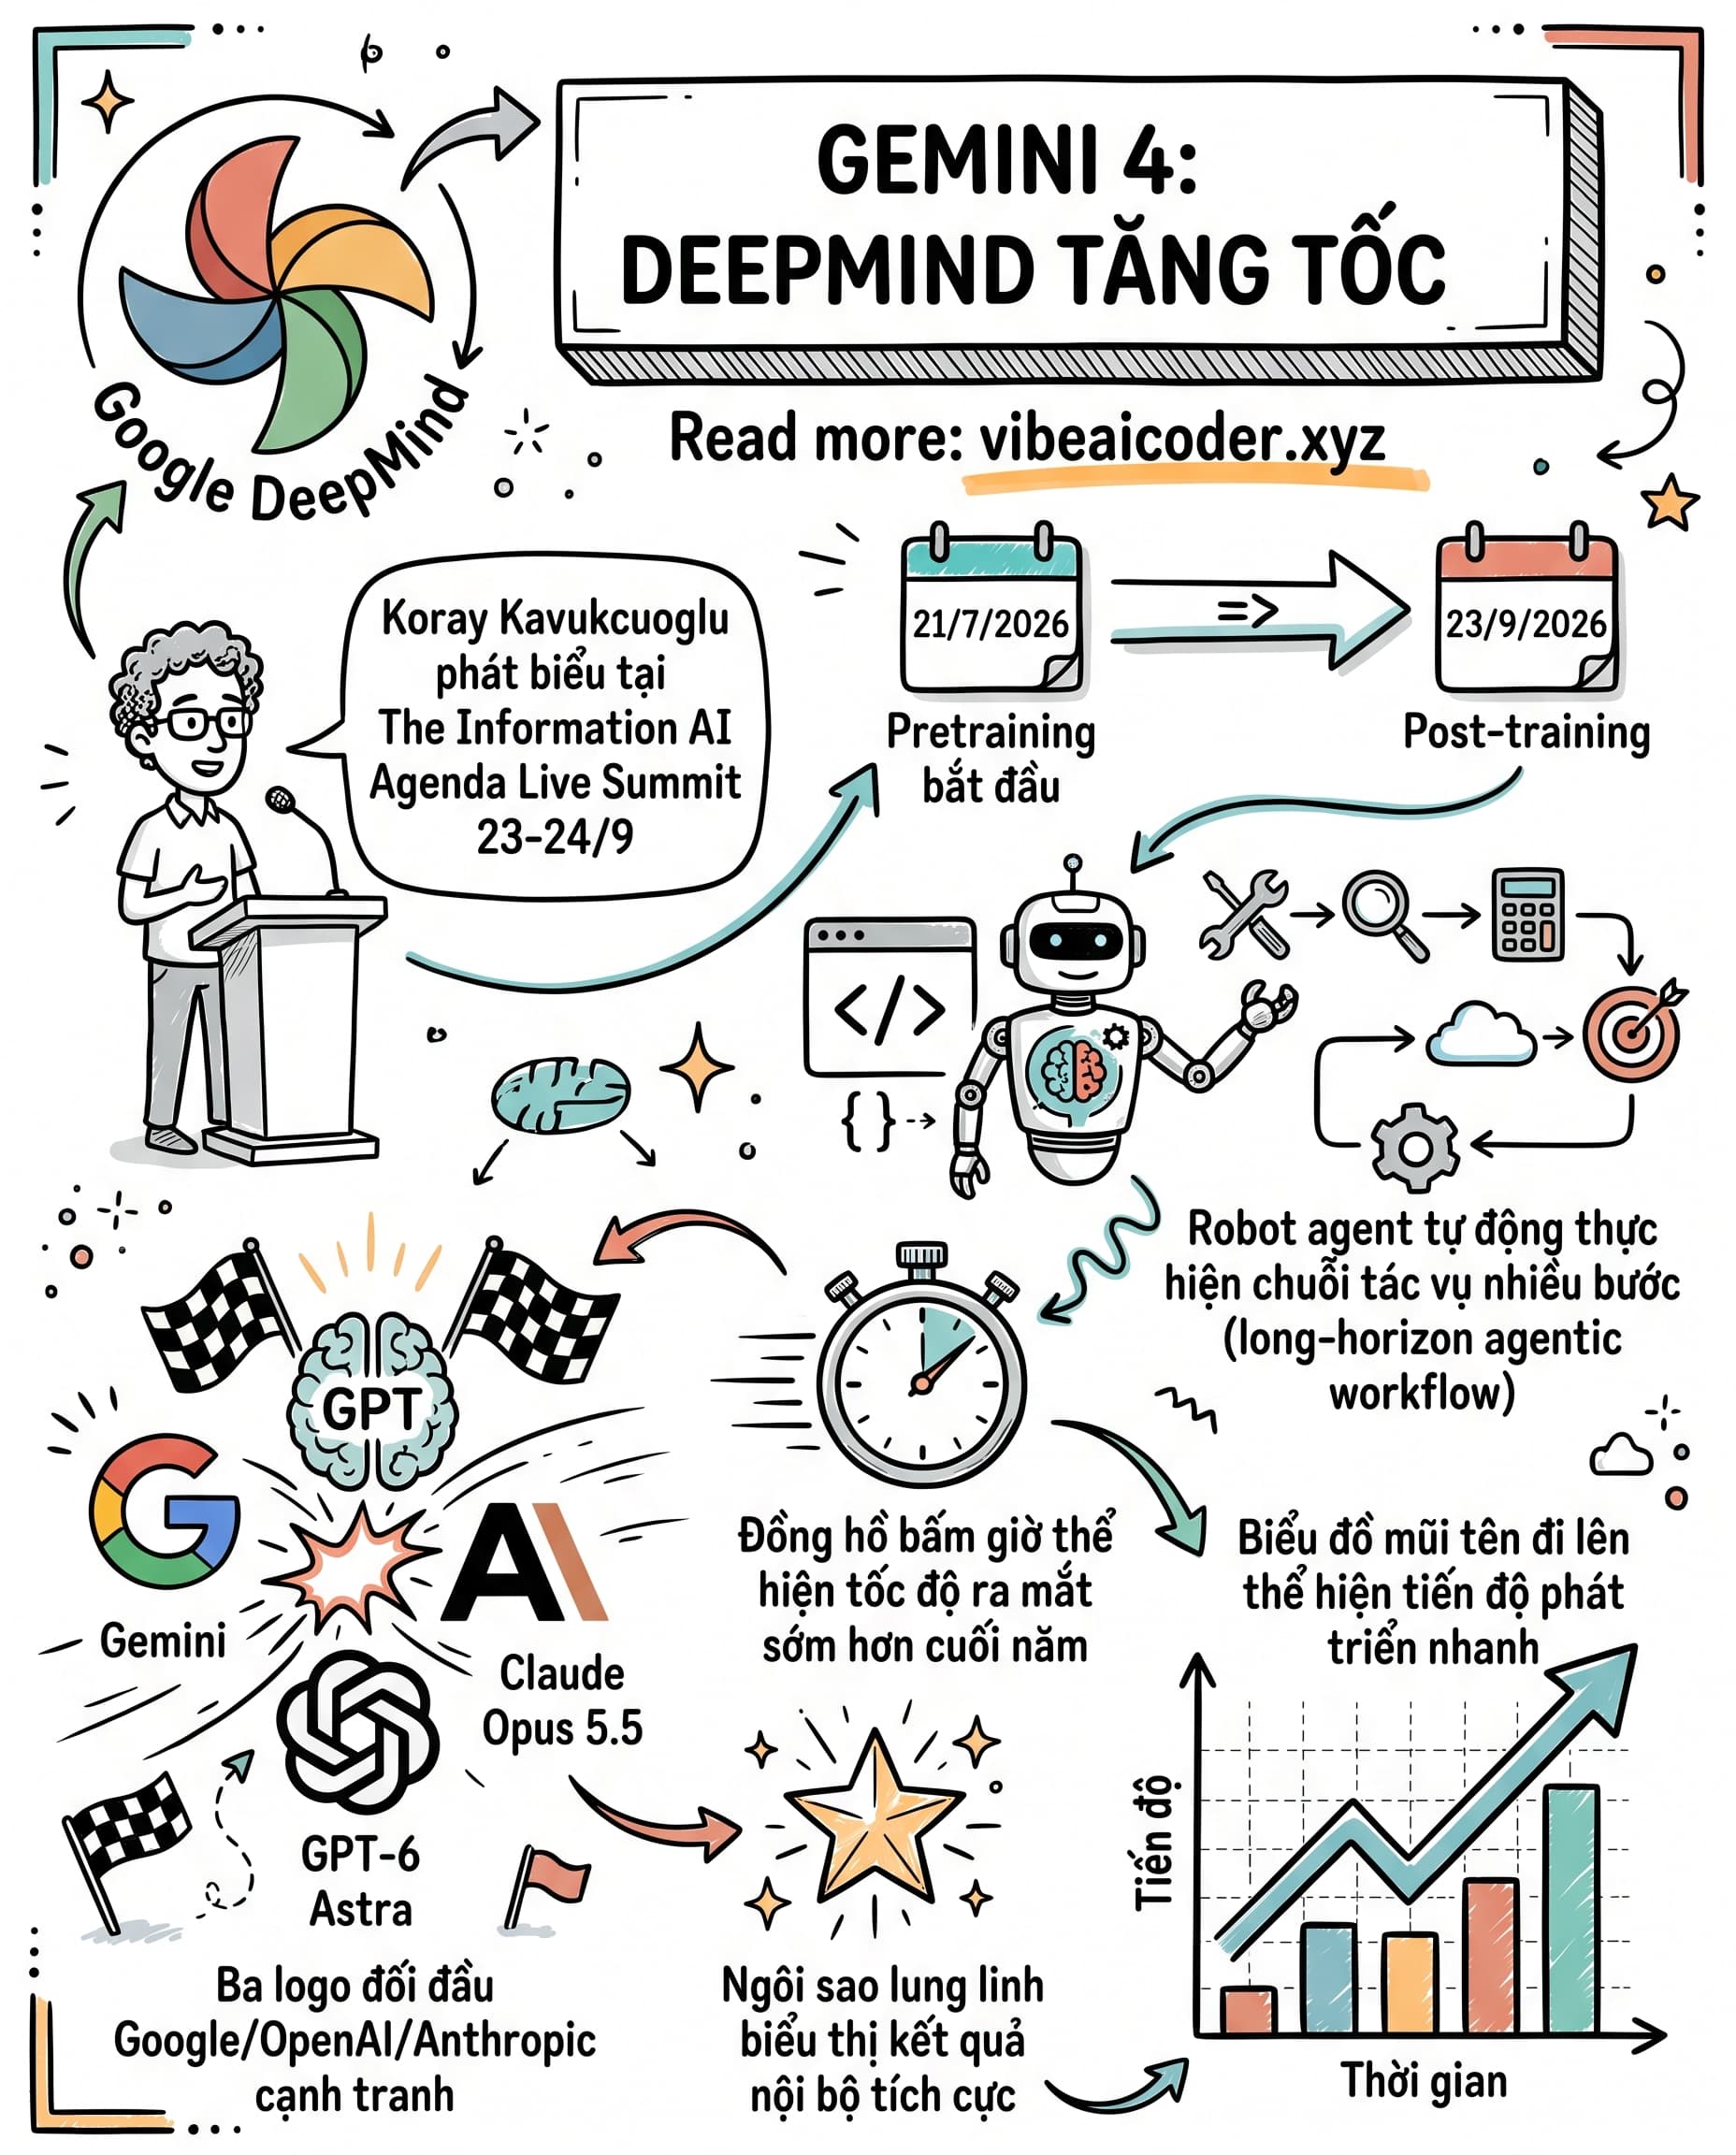
 Gemini 4 Tăng Tốc: Google Muốn Ra Mắt Sớm Hơn Kế Hoạch